← Tous les projets

Projet 01 · IA agentique · Intelligence des données · Génération d'applications · Ingénierie IA

SKatalyst AI

Transformez les données organisationnelles en contexte et le contexte en logiciel.

Les organisations disposent déjà d’énormes quantités de données utiles, mais celles-ci sont fragmentées entre fichiers, bases de données, stockage cloud, documents, rapports et systèmes internes. SKatalyst AI est une tentative de créer une couche entre ces données organisationnelles brutes et les logiciels dont les utilisateurs ont réellement besoin.

Au lieu de commencer par une application et d’y connecter manuellement des données, SKatalyst commence par les informations existantes de l’organisation. Il l'ingère. Le comprend. Le structure. Construit un contexte autour de cela. Utilise ensuite cette compréhension structurée pour générer des applications utiles.

Statut
Bêta privée, septembre 2026
Rôle
Fondatrice, produit, architecture, ingénierie
Depuis
2025
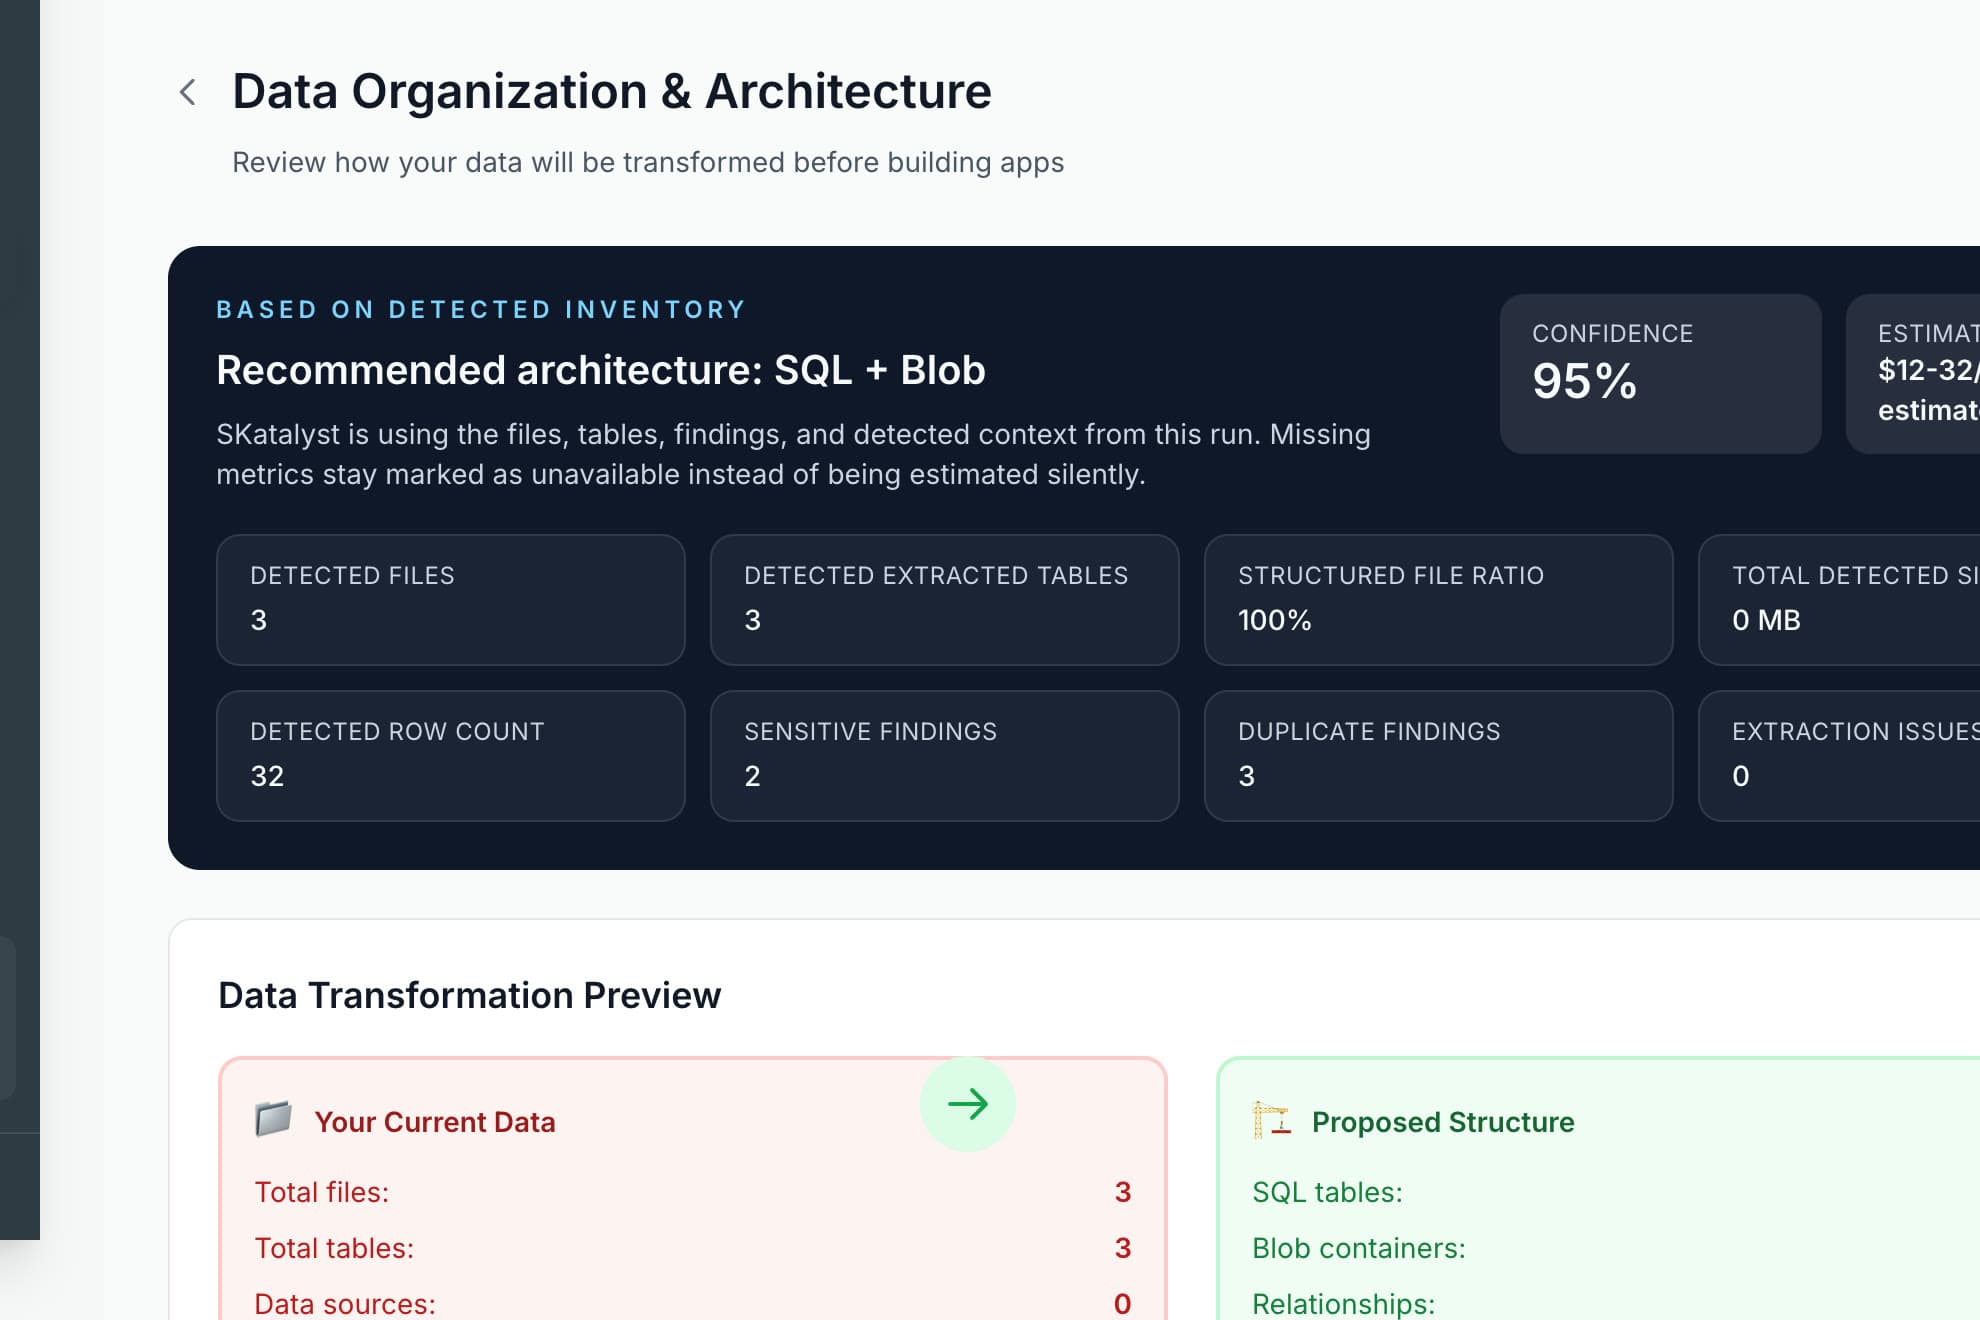
SKatalyst AI recommande une architecture SQL + Blob avec un niveau de confiance de 95 % à partir d'un inventaire détecté de trois tables, avec un aperçu de la transformation des données.

01 · Le problème

Pourquoi j’ai créé SKatalyst AI.
Il manque du contexte.

La plupart des organisations disposent déjà des informations dont elles ont besoin. Il existe simplement sous forme de fichiers et de lignes séparés, répartis sur des lecteurs, des boîtes aux lettres, des bases de données et des outils qui n'ont jamais été conçus pour s'expliquer les uns les autres.

Une personne comprend implicitement les relations : cette feuille de calcul appartient à ce projet, ce rapport décrit ce test, ce tableau contient les mesures, ce document définit le processus. Le logiciel ne voit normalement rien de tout cela. SKatalyst tente de reconstruire ce contexte organisationnel manquant et de le conserver.

  • "Cette feuille de calcul appartient à ce projet."
  • "Ce rapport décrit ce test."
  • "Cette table de base de données contient les mesures."
  • "Ce document définit le processus."
Fichiers ExcelPDFDocuments WordSharePointGoogle DriveOneDriveBases de donnéesStockage en nuageBriques de donnéesRapportsImagesOutils internesAPIExportations CSV
Une couche structuréeContexte organisationnelentités · relations · lignée · définitions

02 · L'idée

Données→Contexte→Structure→Demande

SKatalyst AI conserve et vérifie ce qu’il apprend des données d’une organisation, puis utilise ce contexte pour générer des logiciels.

  1. 01Se connecter

    Importez les données organisationnelles là où elles se trouvent déjà : téléchargements, lecteurs, compartiments et bases de données.

  2. 02Comprendre

    Numériser en lecture seule. Extrayez du texte et des tableaux, des images OCR, lisez des schémas, des métadonnées et des relations.

  3. 03Organiser

    Proposer une structure : des entités, un schéma, une taxonomie de dossiers, des résultats de qualité et une architecture recommandée.

  4. 04Magasin

    Conservez le résultat dans PostgreSQL afin que la compréhension survive à toute conversation IA.

  5. 05Conception

    Découvrez les KPI que les données peuvent réellement calculer et décidez quels modules les exposent.

  6. 06Générer

    Créez des composants d'application fonctionnels : tableau de bord, CRUD, rapport, chat RAG, ainsi qu'une base de données et une API.

  7. 07Valider

    Compilez un oracle de test à partir du modèle de données et comparez le comportement généré aux valeurs de référence.

  8. 08Fonctionner

    Prévisualisez dans un environnement d'exécution éphémère, exportez un package Docker appartenant au client, vérifiez, annulez si nécessaire.

03 · Comment ça marche

Des fichiers au contexte organisationnel

Chaque exécution lit les données sources et construit un contexte structuré, consultable et réutilisable.

Une analyse en lecture seule produit un inventaire approuvé par l'utilisateur. Un plan structurant propose des entités, un schéma et une taxonomie de dossiers. Une recommandation d'architecture explique sa confiance et ce qui a été exclu du devis. La découverte de KPI n'offre que des métriques que les données peuvent calculer. Chaque étape est stockée dans PostgreSQL avec un lien vers les fichiers sources, et le contexte utilisé par une exécution est gelé et haché au démarrage afin de pouvoir être reconstruit ultérieurement.

Le LLM ne doit pas être la base de données.

Le modèle interprète. La compréhension qui en résulte se trouve dans des tableaux structurés et persistants, de sorte que les connaissances organisationnelles ne sont pas reconstruites à partir de zéro à chaque invite.
  1. 01Sources brutes
  2. 02Ingestion
  3. 03Extraction
  4. 04Métadonnées
  5. 05Relations
  6. 06Analyse du contexte
  7. 07Entités structurées
  8. 08Base de données
  9. 09Contexte organisationnel réutilisable
  10. 10Applications et IA
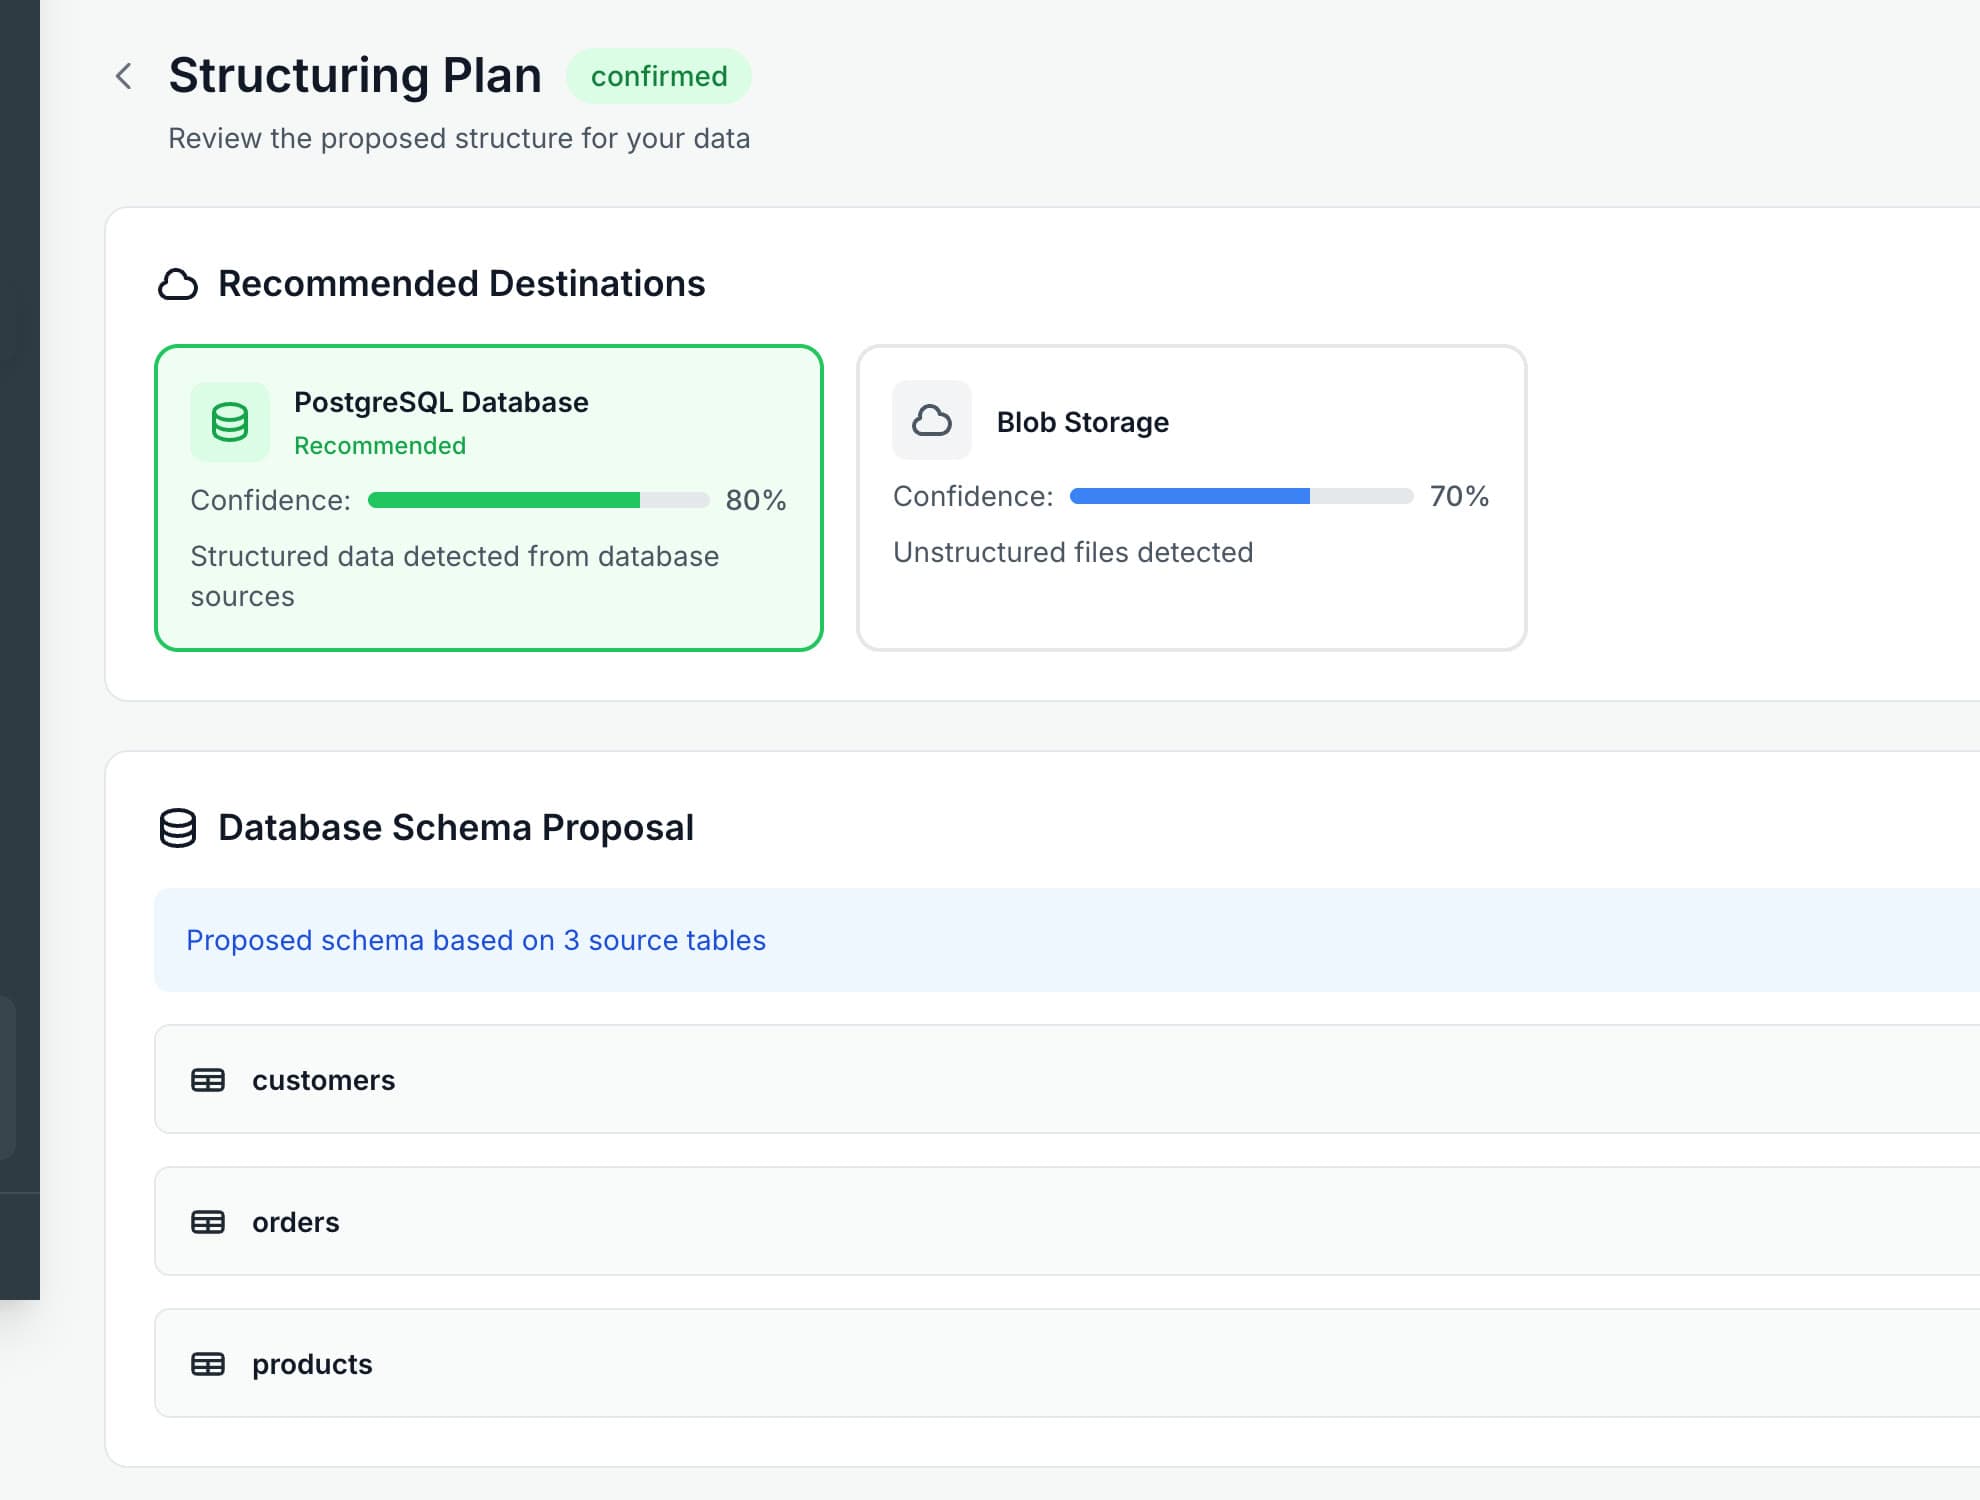
Plan de structuration : destinations recommandées en toute confiance, et proposition de schéma de base de données clients, commandes et produits.
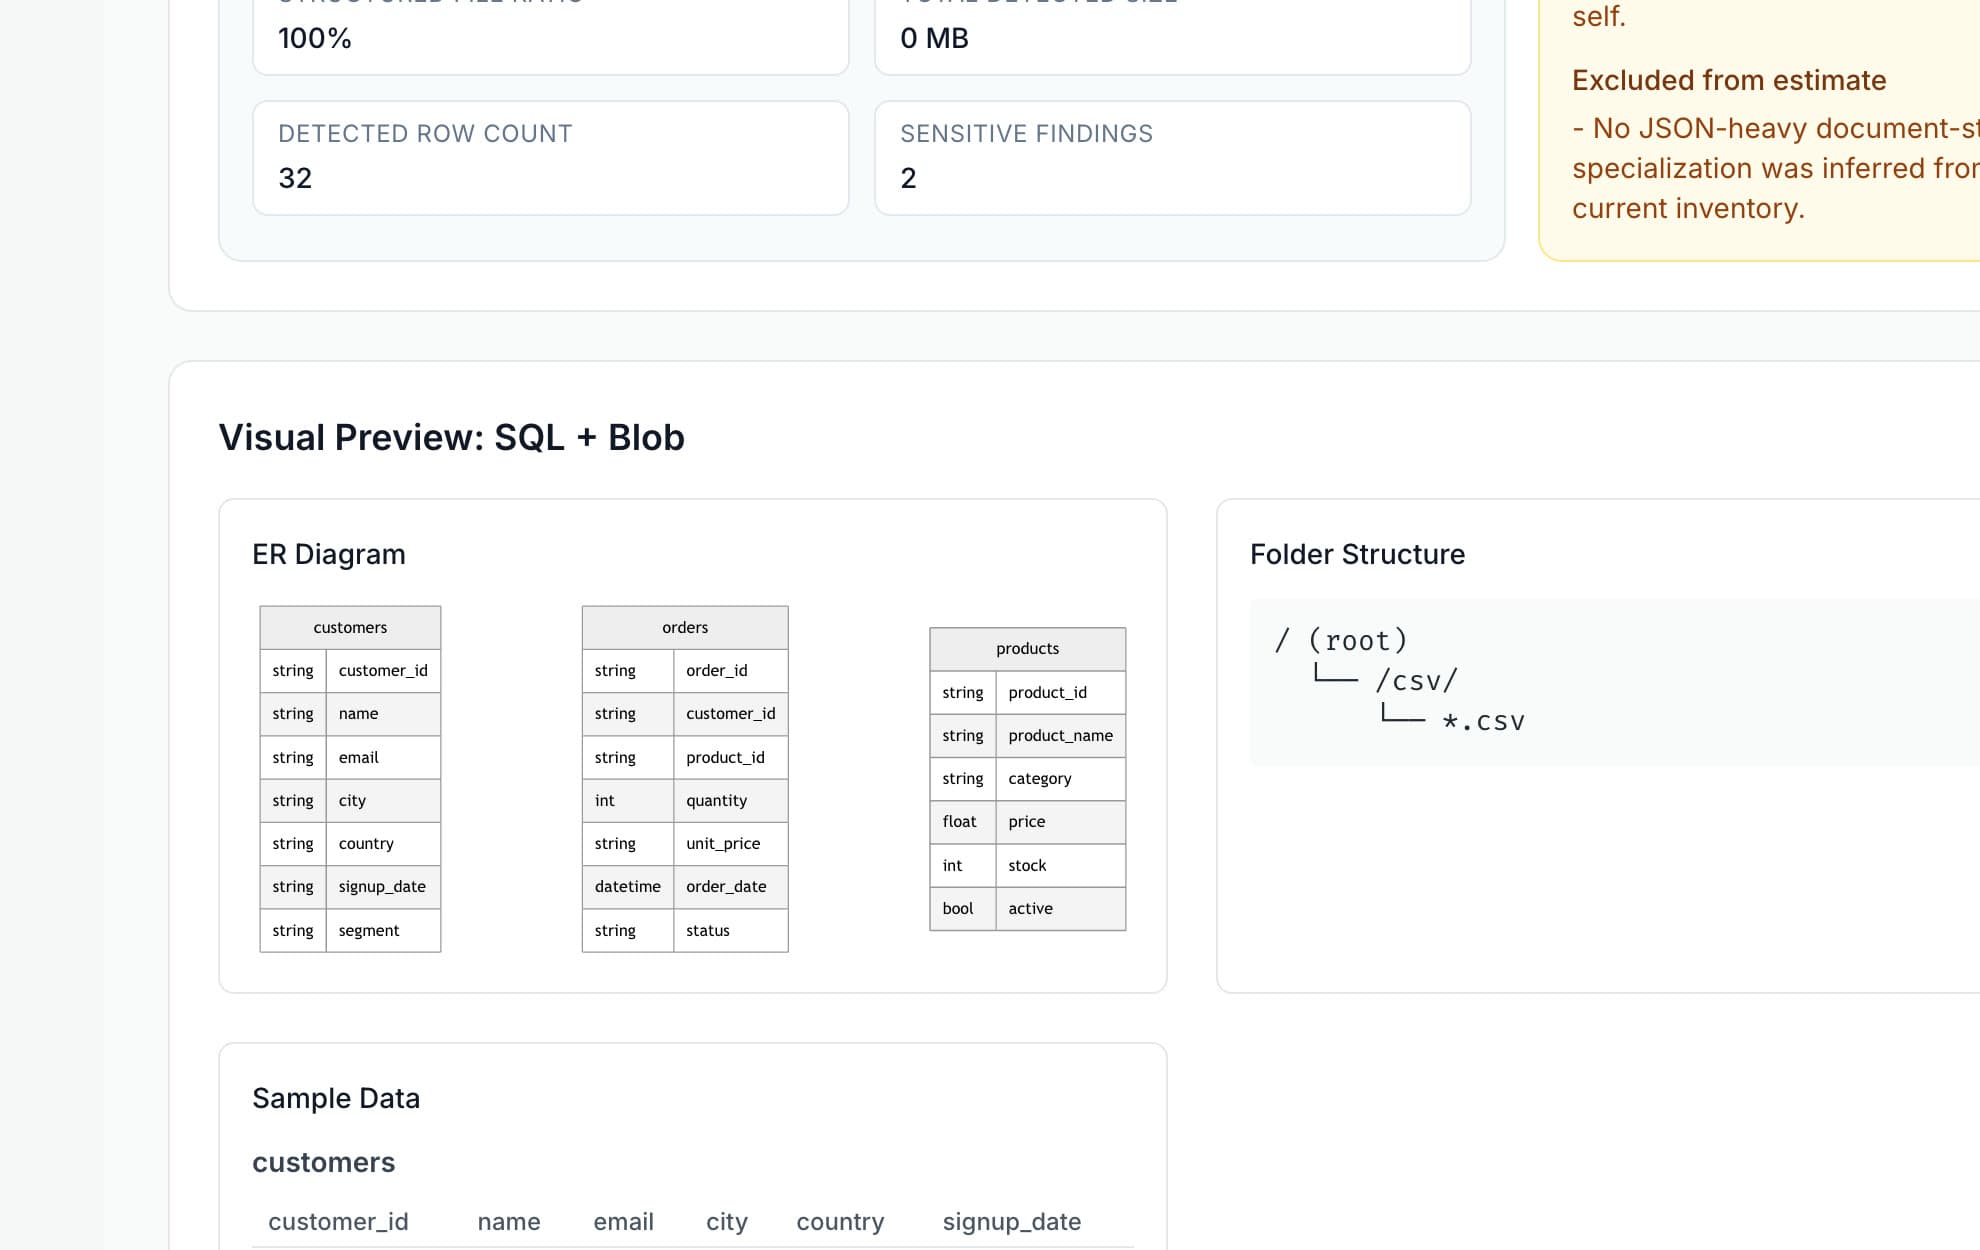
Aperçu visuel de l'architecture SQL + Blob proposée : un diagramme ER pour les clients, les commandes et les produits, une structure de dossiers et des exemples de données.

04 · La couche de renseignement

Où j’utilise l’IA dans le pipeline.

SKatalyst combine un logiciel déterministe avec le raisonnement de l'IA et garde la frontière visible. Le fournisseur de plateforme par défaut est une heuristique déterministe ; un modèle est ajouté lorsqu'une clé est configurée et les fonctionnalités qui en ont besoin se dégradent vers un chemin non-IA au lieu d'échouer.

Couche déterministe

Garanti par le code, les tests et la base de données.

  • Connecteurs sources
  • OAuth et séances
  • Gestion et extraction de fichiers
  • Inspection du schéma
  • Extraction de métadonnées
  • Opérations de base de données
  • Isolement des locataires
  • Rôles et autorisations
  • Migrations
  • Exécution des applications
  • Règles de validation
  • Journalisation d'audit

Couche de raisonnement IA

Là où l’interprétation est véritablement nécessaire.

  • Classer les documents ambigus
  • Trouver des relations sémantiques
  • Proposer une organisation et un contexte
  • Interprétation du contenu du document
  • Recommander une architecture
  • Proposer des KPI et des modules
  • Génération du code de l'application
  • Expliquer les résultats de la validation

Le logiciel garantit ce qui peut être garanti. L’IA gère ce qui nécessite une interprétation. Ni l’une ni l’autre n’est supposée correcte : les propositions sont fiables, les mesures indisponibles sont marquées comme indisponibles et un humain confirme avant que quoi que ce soit ne soit construit.

05 · Architecture du système

Les sept couches du système.

Vérifié par rapport à la source de la plateforme. Chaque couche ne dépend que de celles qui se trouvent au-dessus ; la validation se situe volontairement entre la génération et la livraison.

  1. 01

    Couche source

    • Téléchargement local
    • Agent de dossier local (Go)
    • Google Drive
    • OneDrive
    • SharePoint
    • Boîte de dépôt
    • Amazone S3
    • Blob azur
    • Briques de données
    • PostgreSQL
    • MonSQL
    • SQL Serveur

    12 types de sources. Les connecteurs cloud et de base de données lisent aujourd'hui les métadonnées ; l'exécution reste Aperçu jusqu'à ce qu'elle soit prouvée par rapport à un compte réel.

  2. 02

    Ingestion et compréhension

    • Analyse en lecture seule avec délais d'attente et annulation
    • 7 extracteurs : PDF, DOCX, XLSX, CSV, JSON, Markdown, texte
    • OCR : Tesseract ou Google Vision
    • Compréhension visuelle budgétisée des images
    • Résultats de l’inventaire et de la qualité des données
    • Notation de taxonomie contextuelle

    Chaque exécution commence par un inventaire approuvé par l'utilisateur.

  3. 03

    Contexte et couche de données

    • Bibliothèque de contexte réutilisable
    • Instantanés de contexte gelés avec hachages SHA-256
    • Plans et inventaires structurants
    • Découvertes de KPI avec scores de confiance
    • Mappages de lignage du fichier à la sortie
    • PostgreSQL 16, 51 migrations, environ 80 tables

    La compréhension est stockée, versionnée et traçable, et non redérivée par invite.

  4. 04

    Intelligence et orchestration

    • Exécuter Orchestrator : analyser, fusionner, approuver, planifier
    • Recommandation architecturale
    • Découverte des KPI
    • Négociation de conception
    • Génération de code
    • Fournisseur Claude plus une solution de repli heuristique déterministe

    Chaque étape IA a un chemin non-IA ou une porte BYOK ; la plate-forme ne devine jamais silencieusement.

  5. 05

    Génération d'applications

    • Tableau de bord
    • Application CRUD
    • Rapport
    • Chat / RAG (saisi par le client lors de l'exécution)
    • Sortie React + Express + Docker
    • Provisionnement de schémas et amorçage d'échantillons

    Expédition de 4 générateurs ; 10 types de modules déclarés.

  6. 06

    Validation

    • Tester le compilateur Oracle
    • Exécuteur de référence
    • Coureur de sonde comportementale
    • Comparateur sensible aux tolérances
    • Rapport de validation avec provenance
    • Runtime éphémère limité par TTL

    L'oracle ne lit jamais le code généré, donc une erreur du générateur ne peut pas se cacher.

  7. 07

    Livraison

    • Aperçus de l'architecture, de la mise en œuvre et de l'exécution
    • Runtime d’aperçu éphémère
    • Exportation Docker avec fichiers de documentation et de propriété
    • Vérification du déploiement et restauration guidée
    • Hébergement géré construit, signalement

    L'exportation est bloquée alors que la validation échoue. Ce blocage est intentionnel.

Aux côtés de la plateforme : un agent de serveur local en lecture seule écrit en Go (environ 1 600 lignes) pour les dossiers sur site, avec une liste d'autorisation de chemin, des exclusions de modèles, un kill switch et un battement de cœur. Pas d'écriture, pas de télémétrie.

Connecteurs

Connecter les sources de données existantes.

SKatalyst n'exige pas que l'organisation déplace tout dans un nouvel écosystème avant de pouvoir commencer à comprendre les données.

Douze types de sources sont implémentés, du téléchargement local vers Databricks. Les étiquettes ci-dessous appartiennent au produit : un connecteur ne peut pas quitter l'aperçu tant qu'une lecture réelle d'un octet sur un compte externe réel n'a pas été prouvée et enregistrée. La connexion et la navigation fonctionnent déjà ; Le téléchargement local exécute le pipeline complet aujourd'hui.

  • Téléchargement localFabrication
  • Agent de dossier localBêta
  • OneDriveAperçu
  • SharePointAperçu
  • Google DriveAperçu
  • Boîte de dépôtAperçu
  • Amazone S3Aperçu
  • Stockage Blob AzureAperçu
  • Briques de donnéesAperçu
  • PostgreSQLAperçu
  • MonSQLAperçu
  • SQL ServeurAperçu
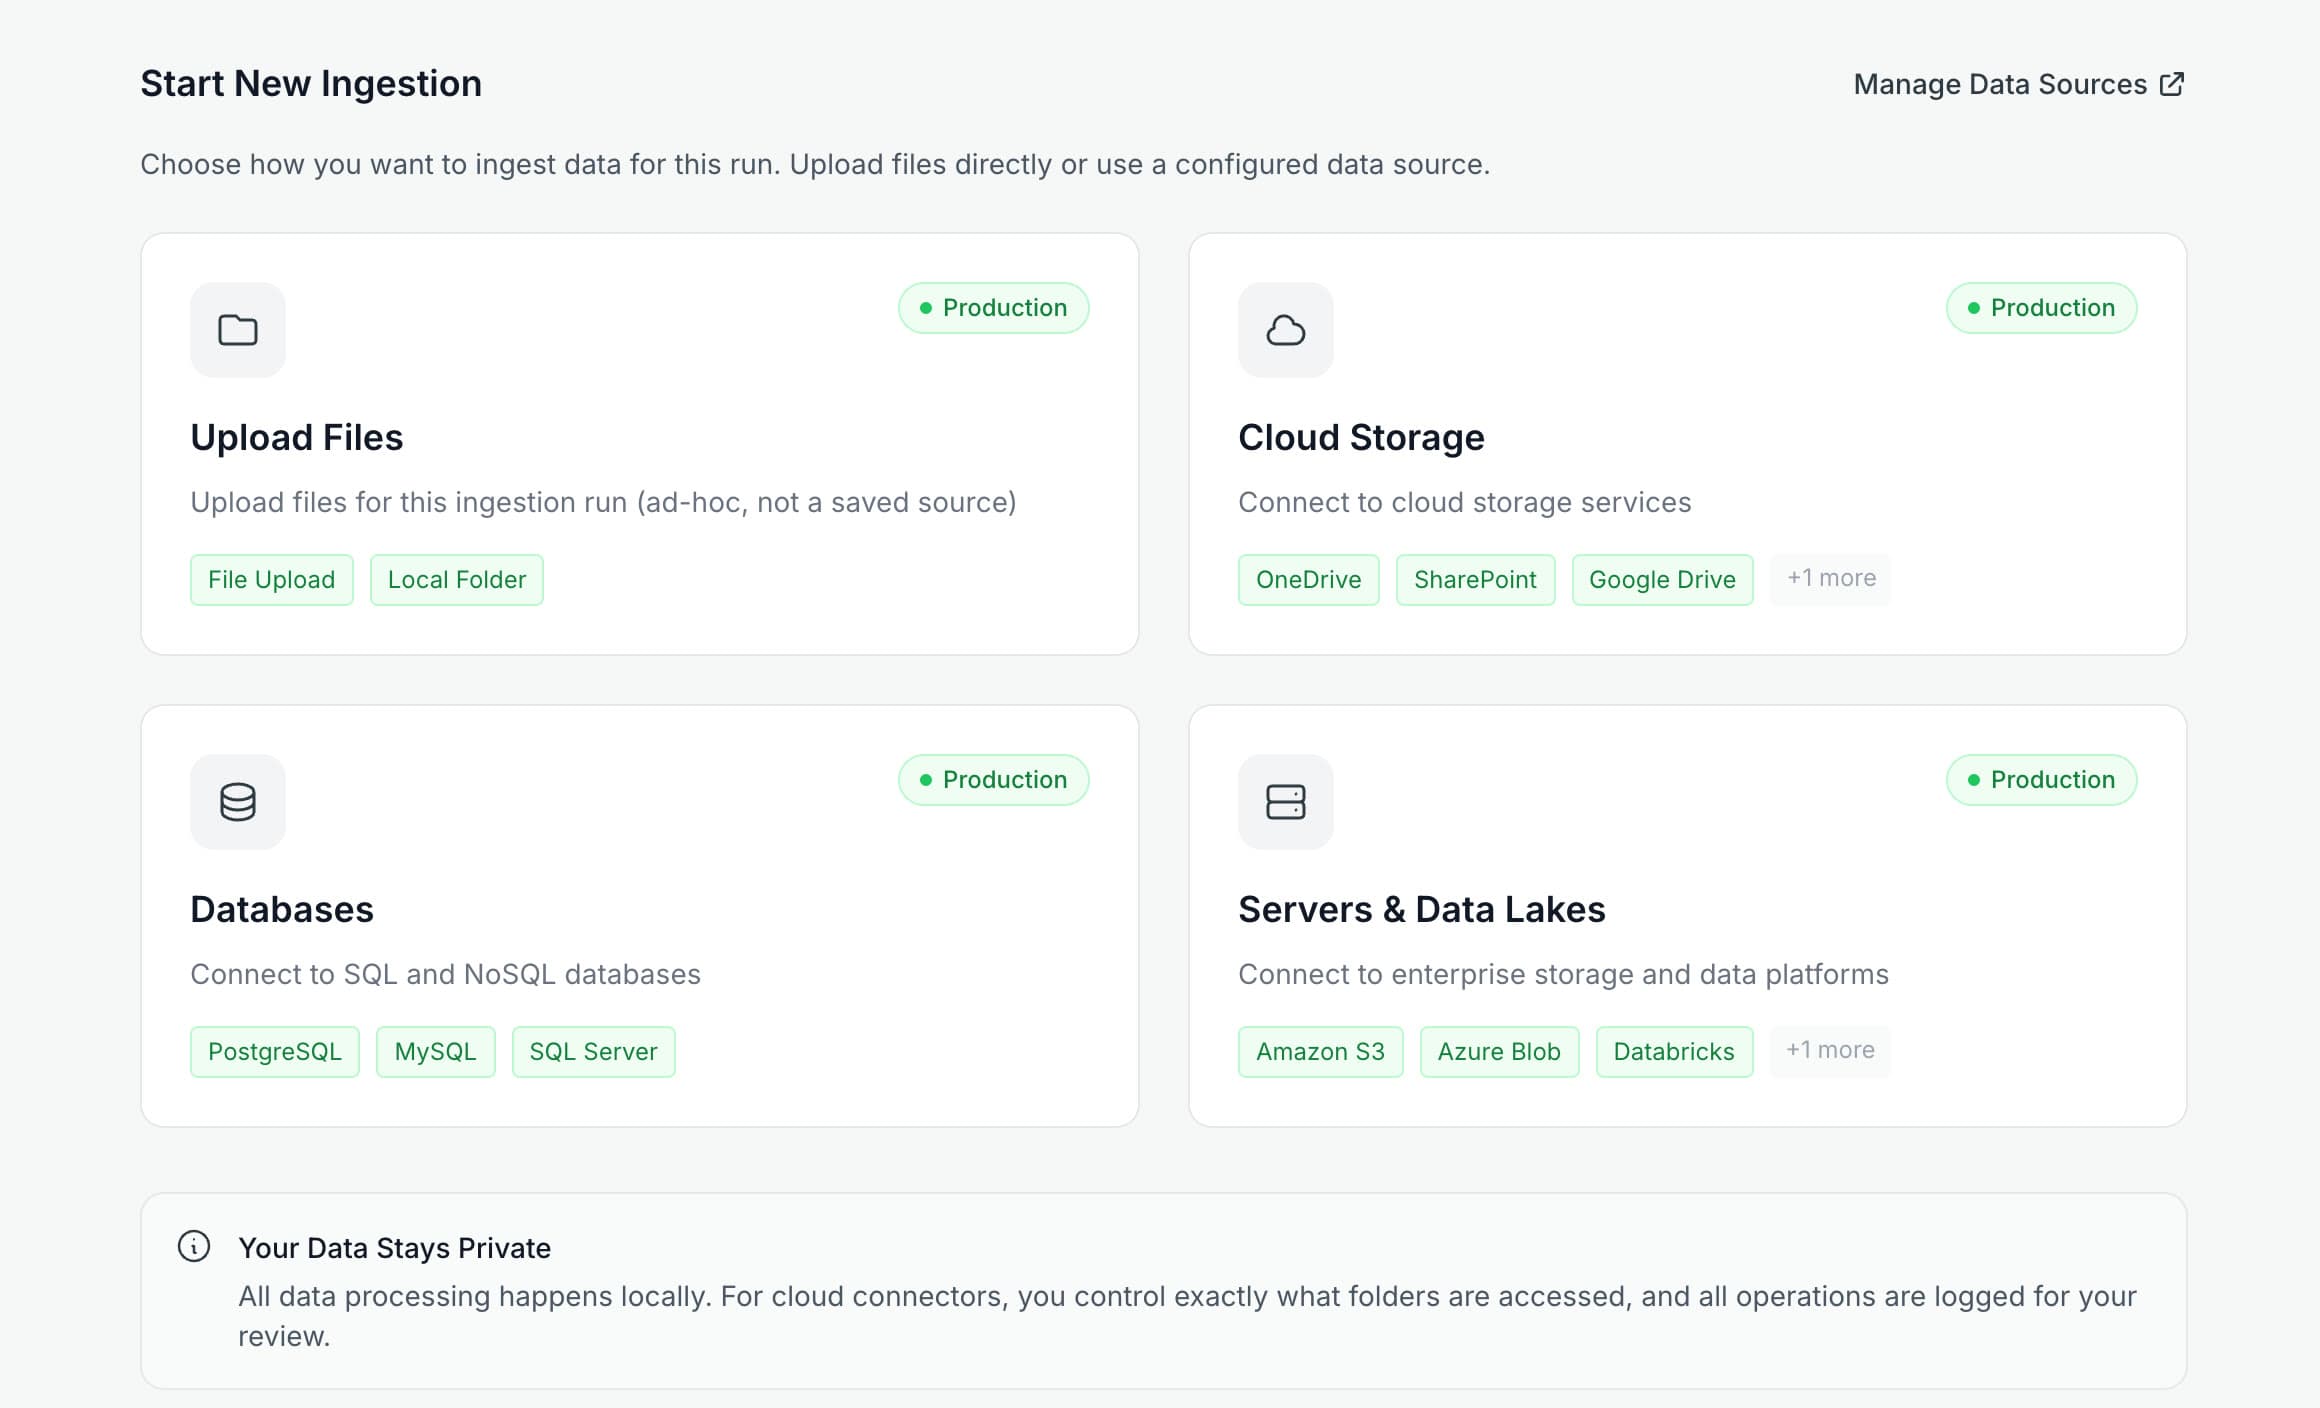
Ajouter des données : quatre familles de connecteurs dans le produit, télécharger des fichiers, stockage dans le cloud (OneDrive, SharePoint, Google Drive), bases de données (PostgreSQL, MySQL, SQL Server) et serveurs et lacs de données (Amazon S3, Azure Blob, Databricks), avec une note selon laquelle tous les traitements se produisent localement et sont enregistrés.

06 · Ce qu'il peut construire

Ce que la plateforme peut générer.

Applications CRUD

Interfaces opérationnelles structurées sur les entités détectées, avec des points de terminaison d'API générés pour chacune.

Expédition

Tableaux de bord

Cartes et graphiques KPI construits uniquement à partir de métriques que les données peuvent calculer ; les métriques indisponibles sont marquées, jamais falsifiées.

Expédition

Chat / RAG

Accès en langage naturel ancré dans le contexte organisationnel. Les clés d'exécution restent chez le client.

Expédition

Rapports

Reporting structuré du même contexte, exporté avec le package applicatif.

Expédition

Prédiction et analyse

Modules analytiques orientés données où les données sous-jacentes les prennent en charge.

Feuille de route

API, automatisation, agent, workflow

Types de modules déclarés en attente de générateurs.

Feuille de route
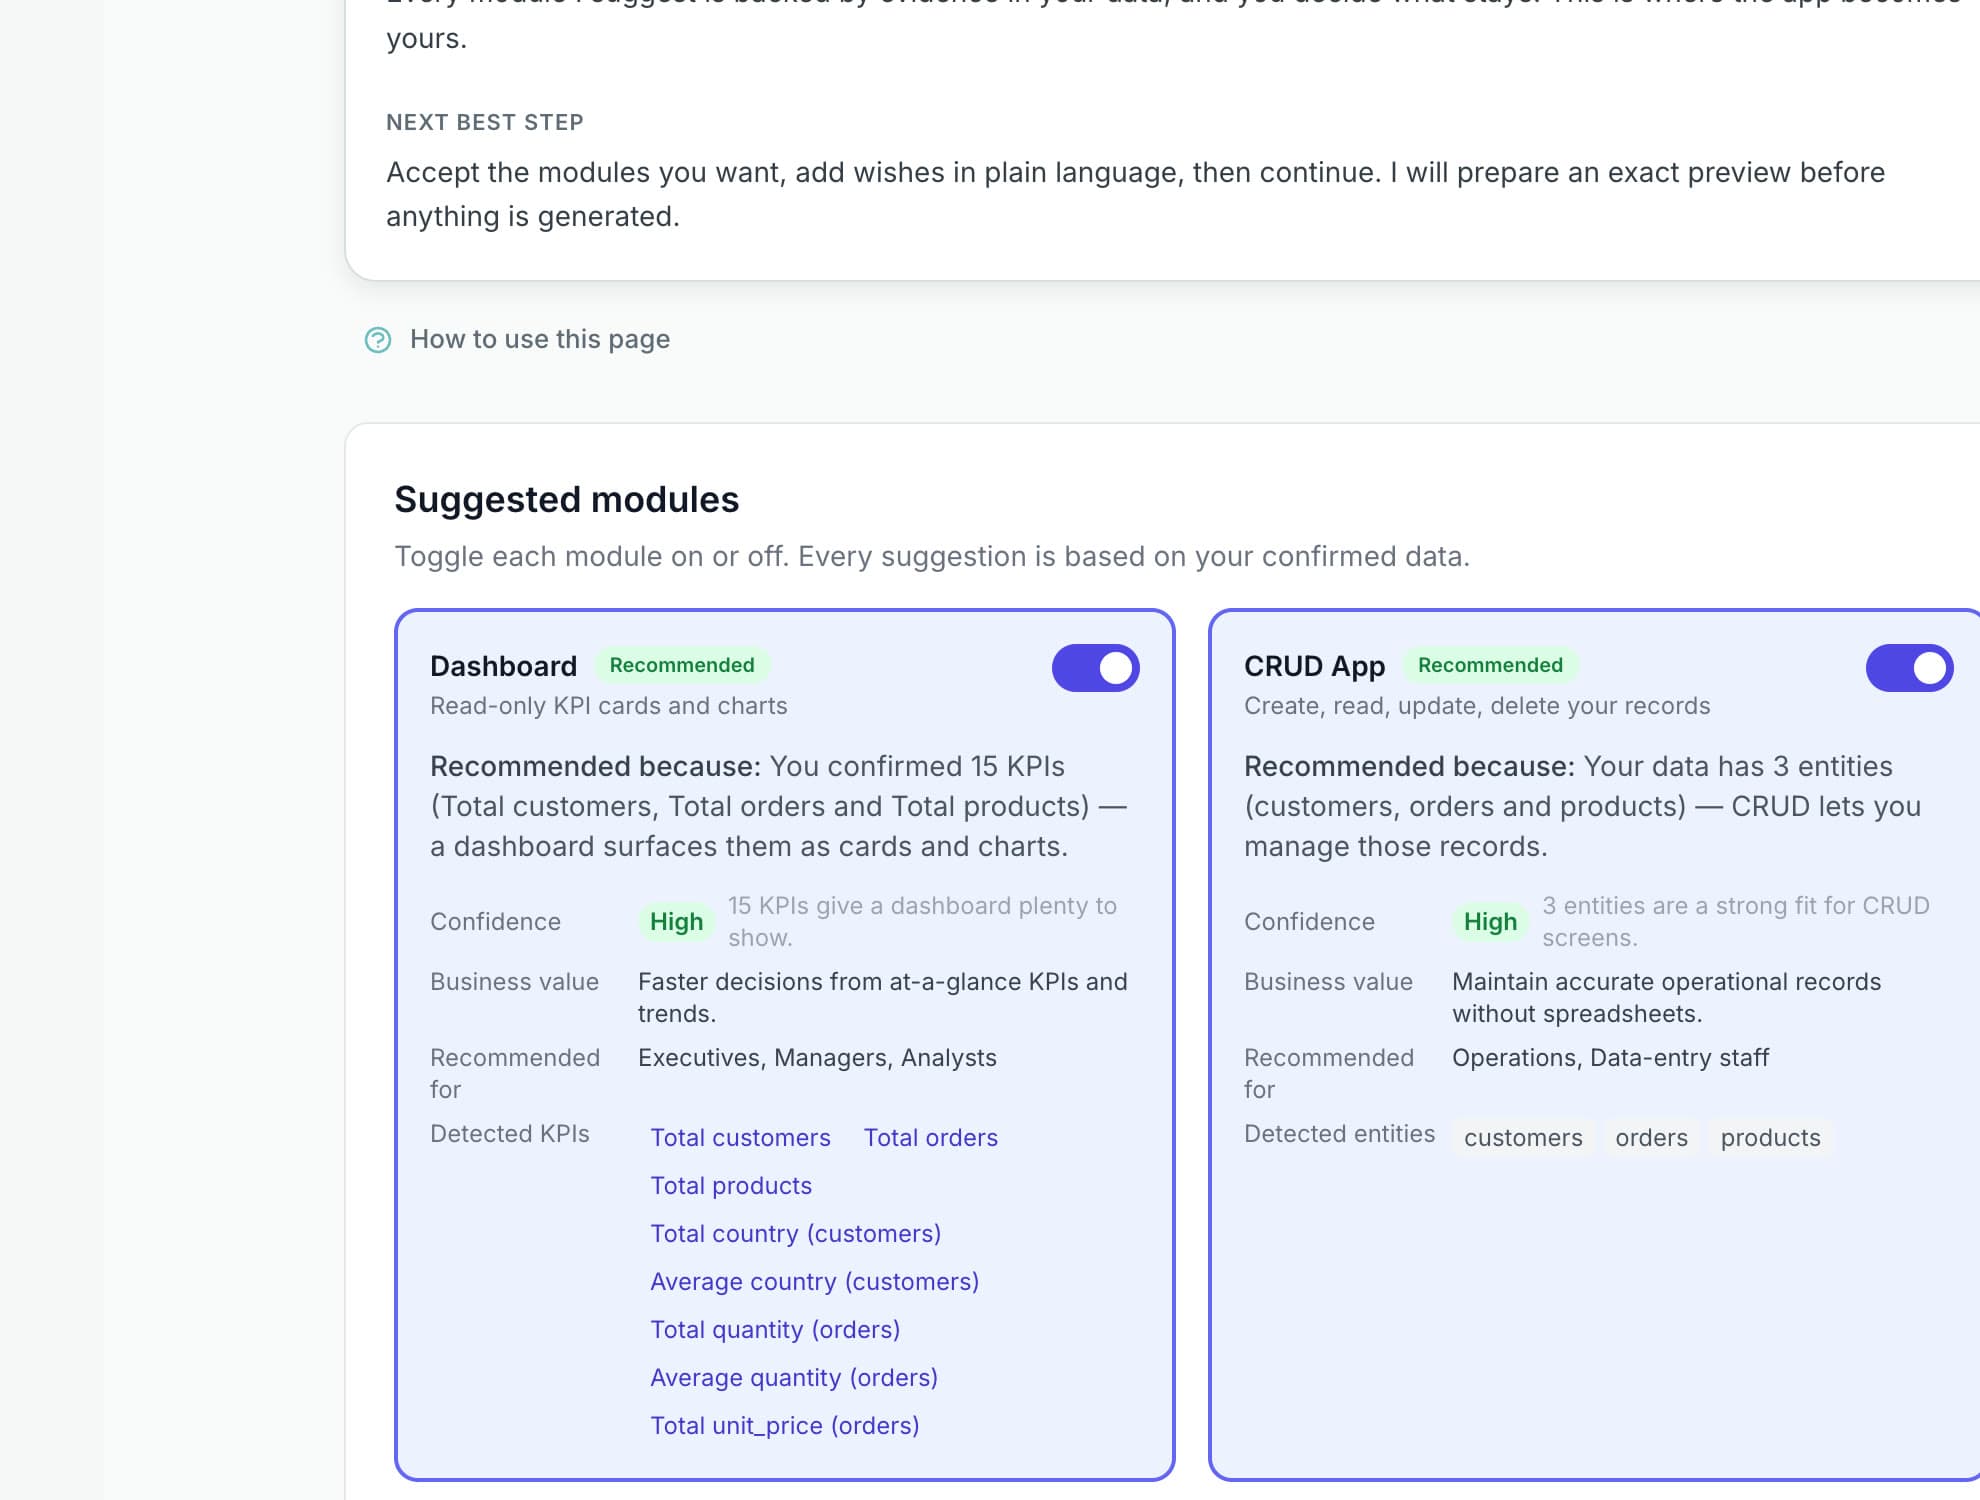
Modules suggérés dans l'étape de conception : Tableau de bord et application CRUD recommandés avec les preuves derrière chaque recommandation, confiance, valeur commerciale et KPI ou entités détectés.
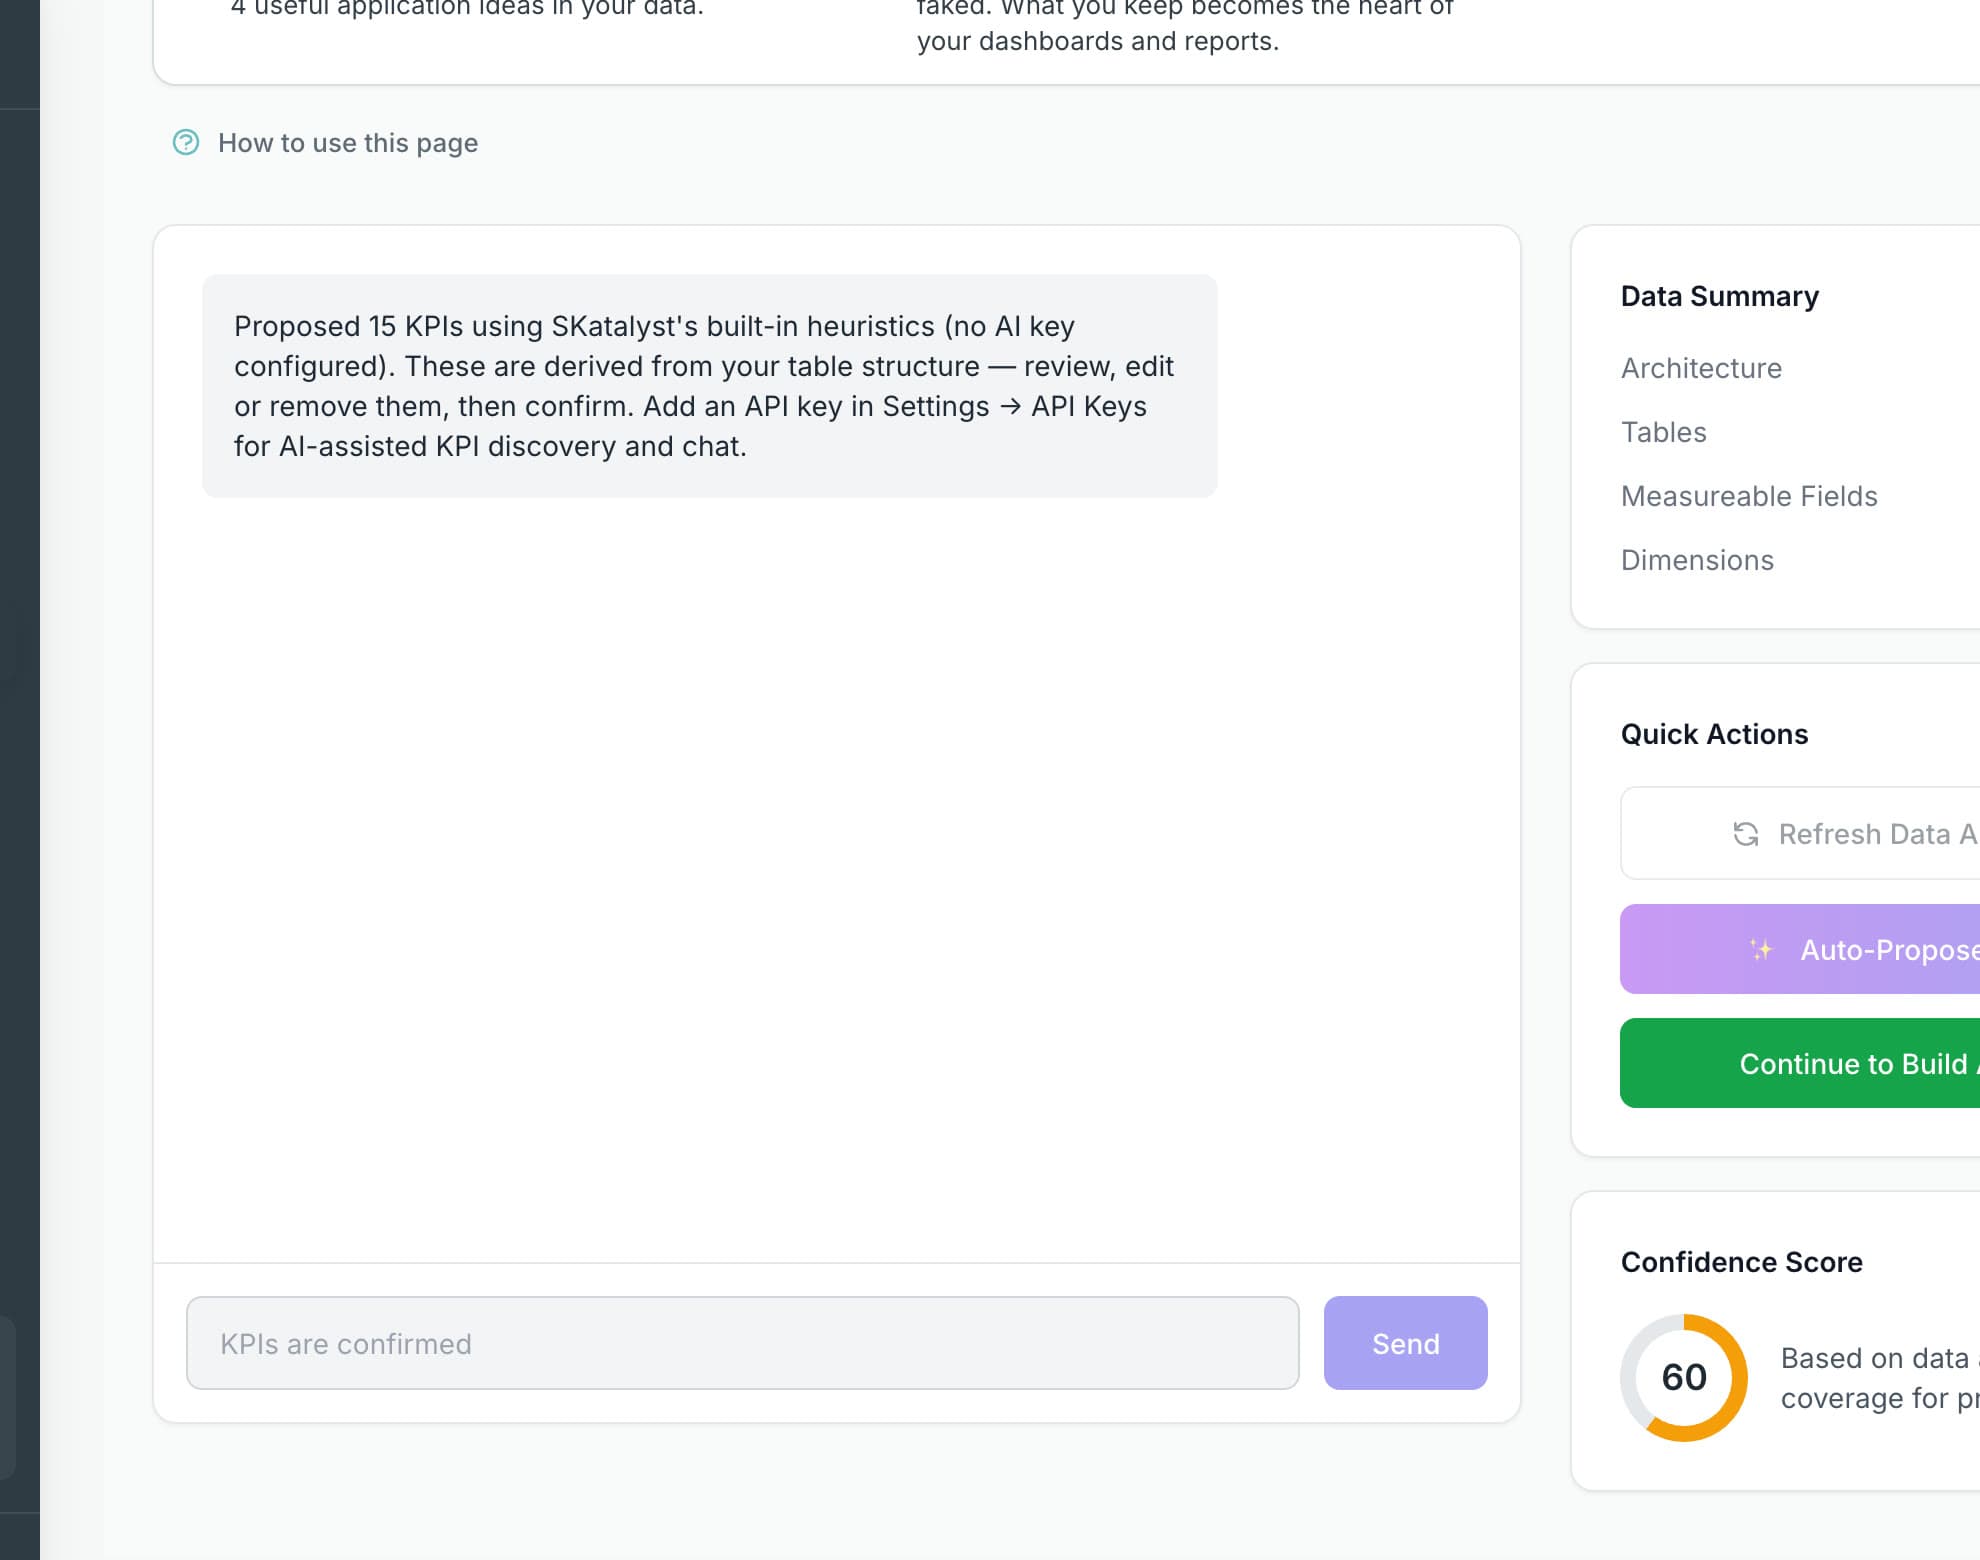
Découverte des KPI : l'assistant propose des KPI à partir de trois tableaux et cinq colonnes mesurables, avec une synthèse des données et un score de confiance.

07 · Confiance et validation

Vérifier les résultats générés.

Si l’IA doit générer des logiciels à partir de données organisationnelles, la génération ne peut pas être l’étape finale. SKatalyst traite la validation comme faisant partie de l'architecture : les attentes sont compilées à partir de la compréhension des données, jamais à partir du code généré, de sorte que l'erreur d'un générateur ne peut pas se justifier.

  1. Construire
  2. Tester
  3. Comparez
  4. Expliquez
  5. Réparation / Révision

Compiler les attentes

TestOracleCompiler

Transforme les KPI, les entités, le schéma et le contexte commercial confirmés en assertions comportementales. Pur et déterministe : pas de base de données, pas de réseau, pas de modèle, et jamais une ligne de code généré.

Calculez quelle devrait être la réponse

ReferenceExecutor

Évalue chaque assertion par rapport à l’instantané d’échantillon au moment de l’ingestion : sommes, décomptes, moyennes, minimums et maximums. Lecture seule ; n'ouvre jamais un connecteur sous tension.

Exercer l'application générée

BehavioralProbeRunner

Démarre l'application dans un environnement d'exécution isolé contenant le même échantillon et sonde ses points de terminaison, y compris les tests négatifs qui doivent être rejetés.

Comparer avec la tolérance

Comparator

Comparaison exacte ou relative des valeurs observées par rapport aux valeurs de référence, de sorte qu'une différence d'arrondi n'est pas un échec mais un mauvais KPI l'est.

Expliquez le résultat

ValidationReportService

Chaque assertion porte une provenance : quel KPI, quel tableau, quelle formule. Le rapport est la preuve contre laquelle un humain approuve.

Orchestrer et dégrader en toute sécurité

ValidationOrchestrator

Exécute la compilation, la référence, la sonde et la persistance ; revient à un rapport de référence uniquement lorsque le moteur d'exécution n'est pas disponible ; détruit toujours le temps d'exécution.

5 types d'assertionsValeur KPI · entité CRUD · intégrité de la relation · forme du schéma · plage de domaines
Tests négatifsUne clé étrangère orpheline ou une écriture violant le domaine doit être rejetée par l'application générée.
Anomalies avant générationL'exécution de référence sert également à vérifier la compréhension elle-même : une attente brisée fait surface avant qu'un code n'existe.
La réparation reste humaineLa réparation automobile limitée est conçue mais délibérément pas construite. Les échecs reviennent à une personne détenant la preuve, et l'exportation reste bloquée tant que la validation échoue.
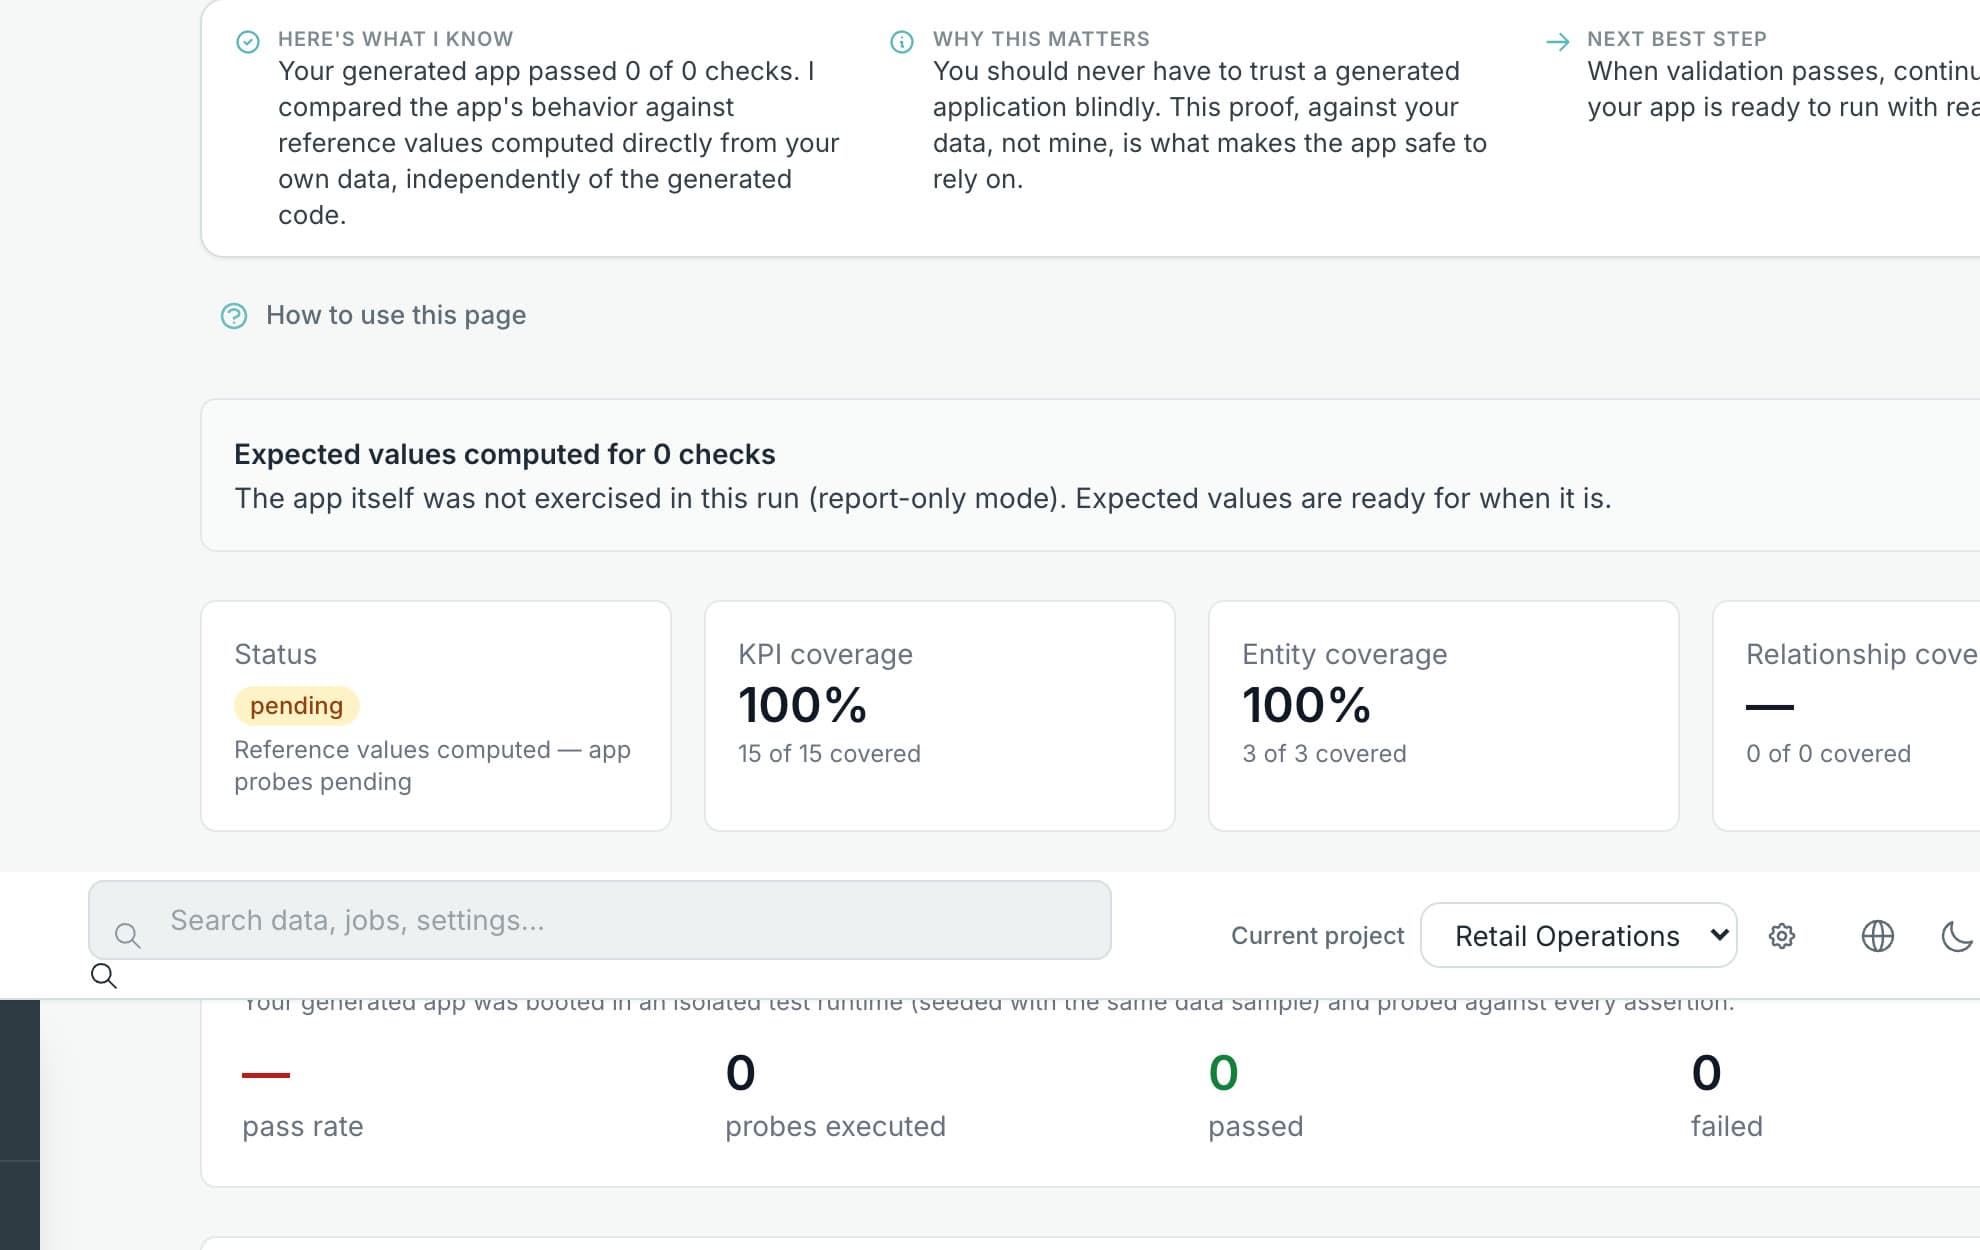
Rapport de validation : test oracle compilé à partir de la compréhension des données, couverture 100 % des KPI (15 sur 15), couverture 100 % des entités (3 sur 3), panel de validation comportementale.
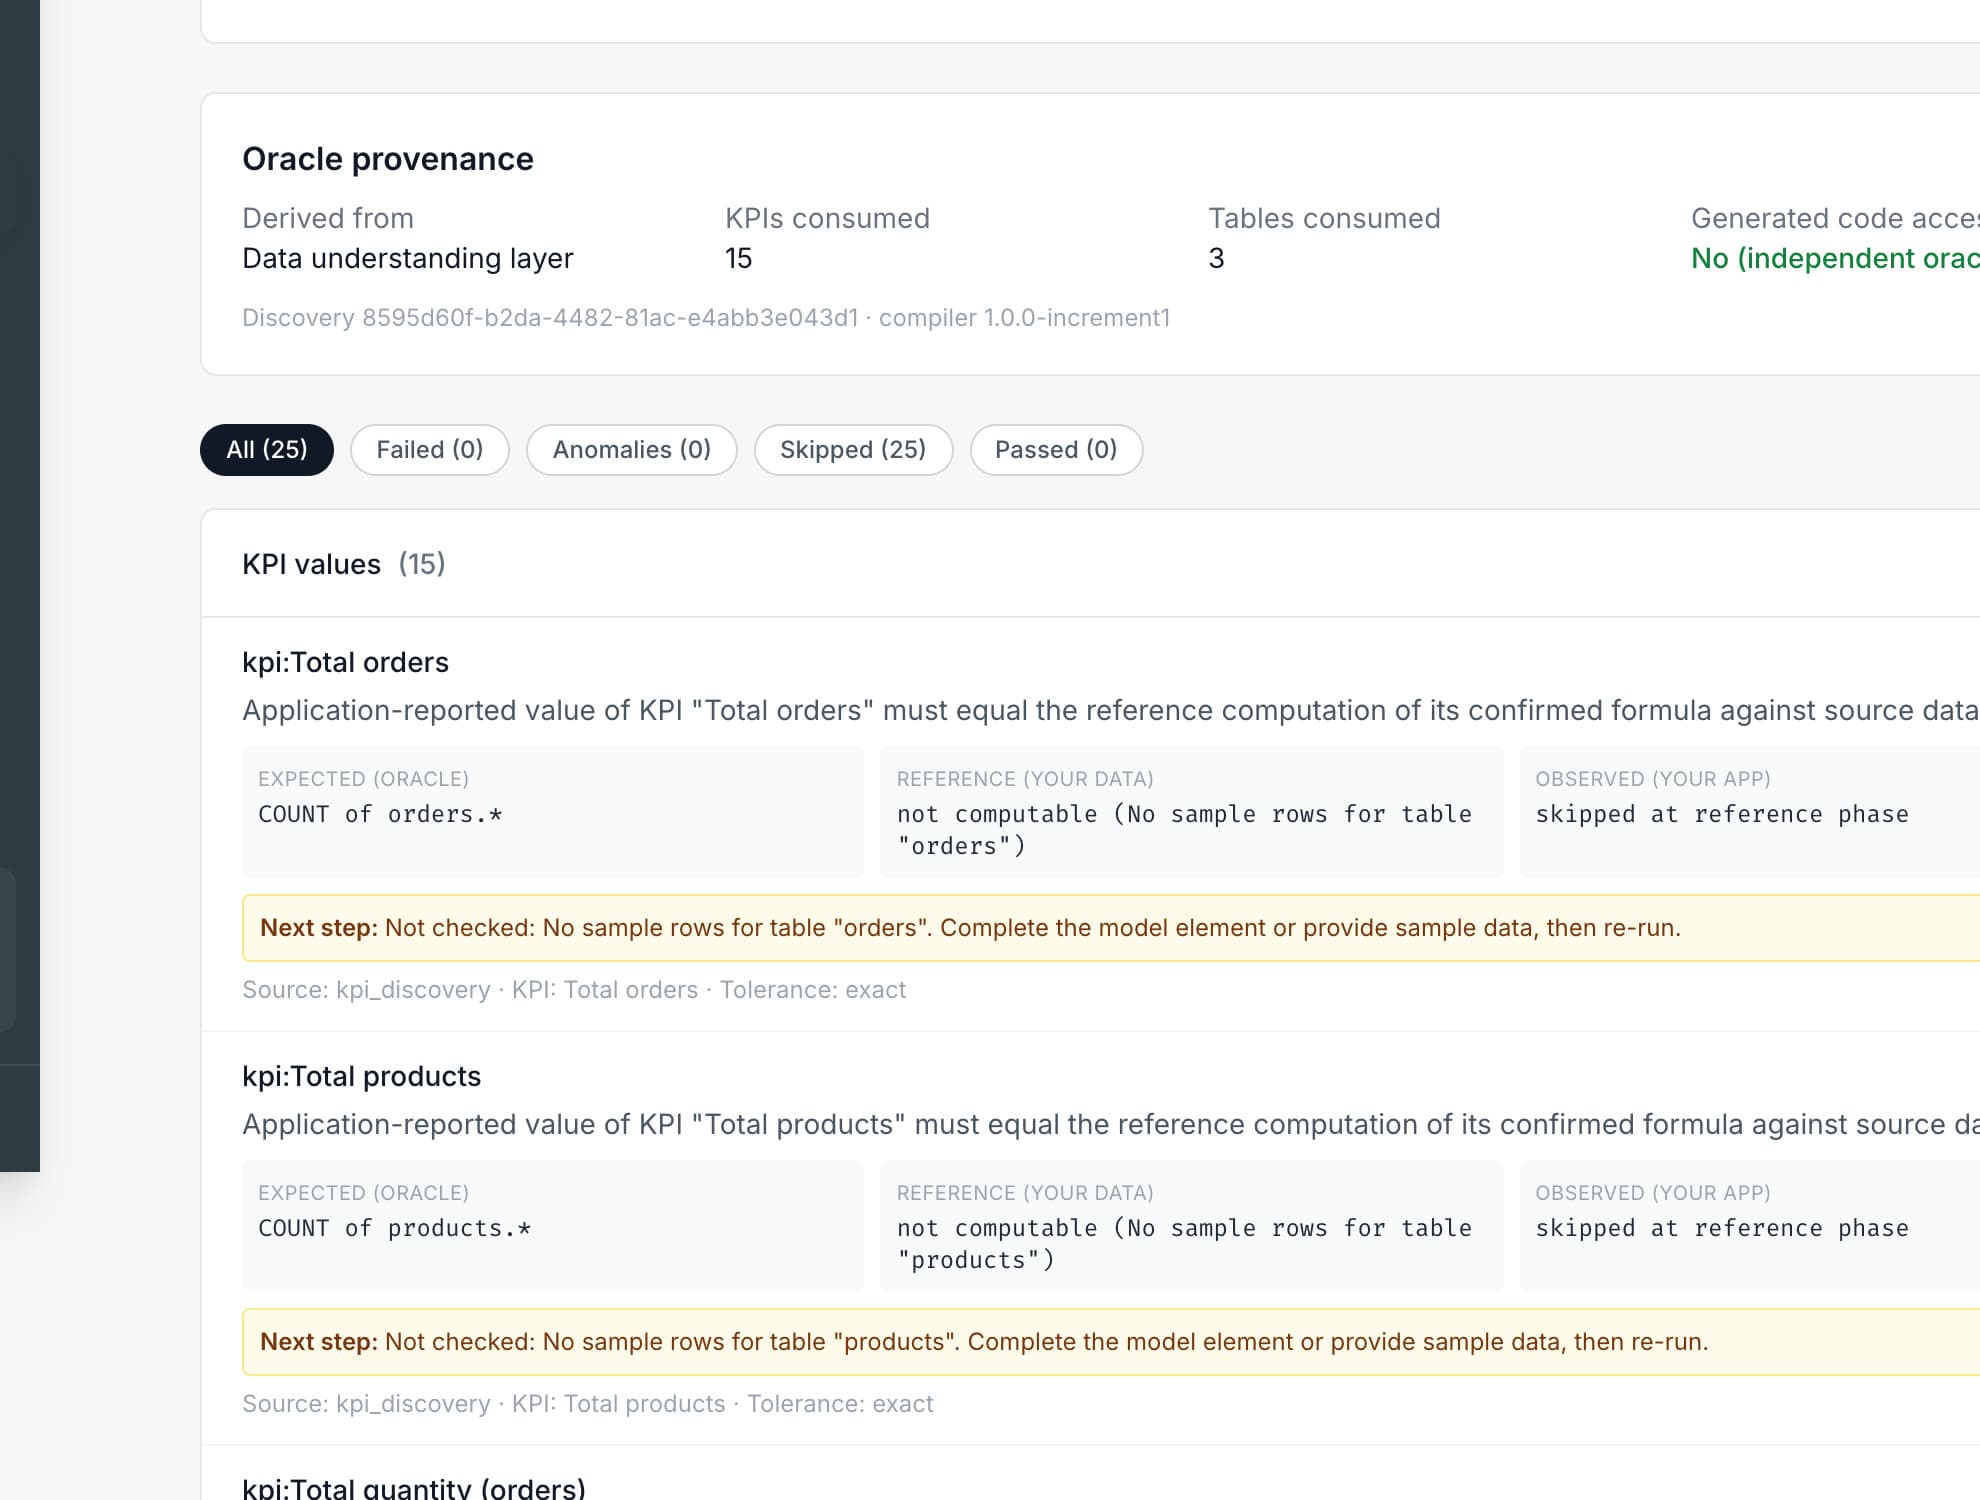
Détail du rapport de validation : provenance d'Oracle montrant 15 KPI et 3 tables consommées et générées, code consulté : non, suivi des assertions de valeur KPI compilées avec leurs formules attendues.

Approbation humaine

Les étapes de validation humaine.

Le système propose : une personne décide aux moments qui comptent. Deux portes sont distinctes par leur conception : approuver une spécification avant que quoi que ce soit ne soit construit et accepter un aperçu après sa construction.

  • Approbation de l'inventaire avant qu’un plan structurant soit généré.
  • Confirmation du plan et de l'architecture avant que les KPI ne soient découverts.
  • Approbation de la conception avant le début d'une construction.
  • Aperçu de l'acceptation, de la révision ou du rejet après la construction, avec une boucle de révision vers la conception.
  • Rapport de validation comme preuve de cette décision ; l'exportation est bloquée en cas d'échec.
  • Piste d'audit: chaque transition écrit un événement et une ligne d'audit en ajout uniquement dans la même transaction, ou la transition revient en arrière.
  1. L'IA propose
  2. Avis humains
  3. Constructions du système
  4. Le système valide
  5. L'humain accepte

Cycle de vie de la solution · 12 états

  1. brouillon
  2. concevoir
  3. en attente d'approbation
  4. approuvé
  5. bâtiment
  6. aperçu
  7. accepté
  8. révision demandée
  9. rejeté
  10. déployé
  11. fonctionnement
  12. archivé

Les états mis en évidence sont les portes humaines. Les transitions sont un tableau explicite ; les illégaux sont refusés, les répétés sont idempotents et la désarchivage ne redémarre jamais un runtime.

08 · Expérience produit

Les étapes d’une exécution.

Le stepper intégré à l'application suit huit étapes sur chaque page d'exécution. Chaque étape explique ce que le système sait, pourquoi c'est important et la meilleure action suivante, avec la propre voix du produit.

  1. 01Se connecter
  2. 02Contexte
  3. 03Comprendre
  4. 04Recommander
  5. 05Conception
  6. 06Construire
  7. 07Valider
  8. 08Déployer
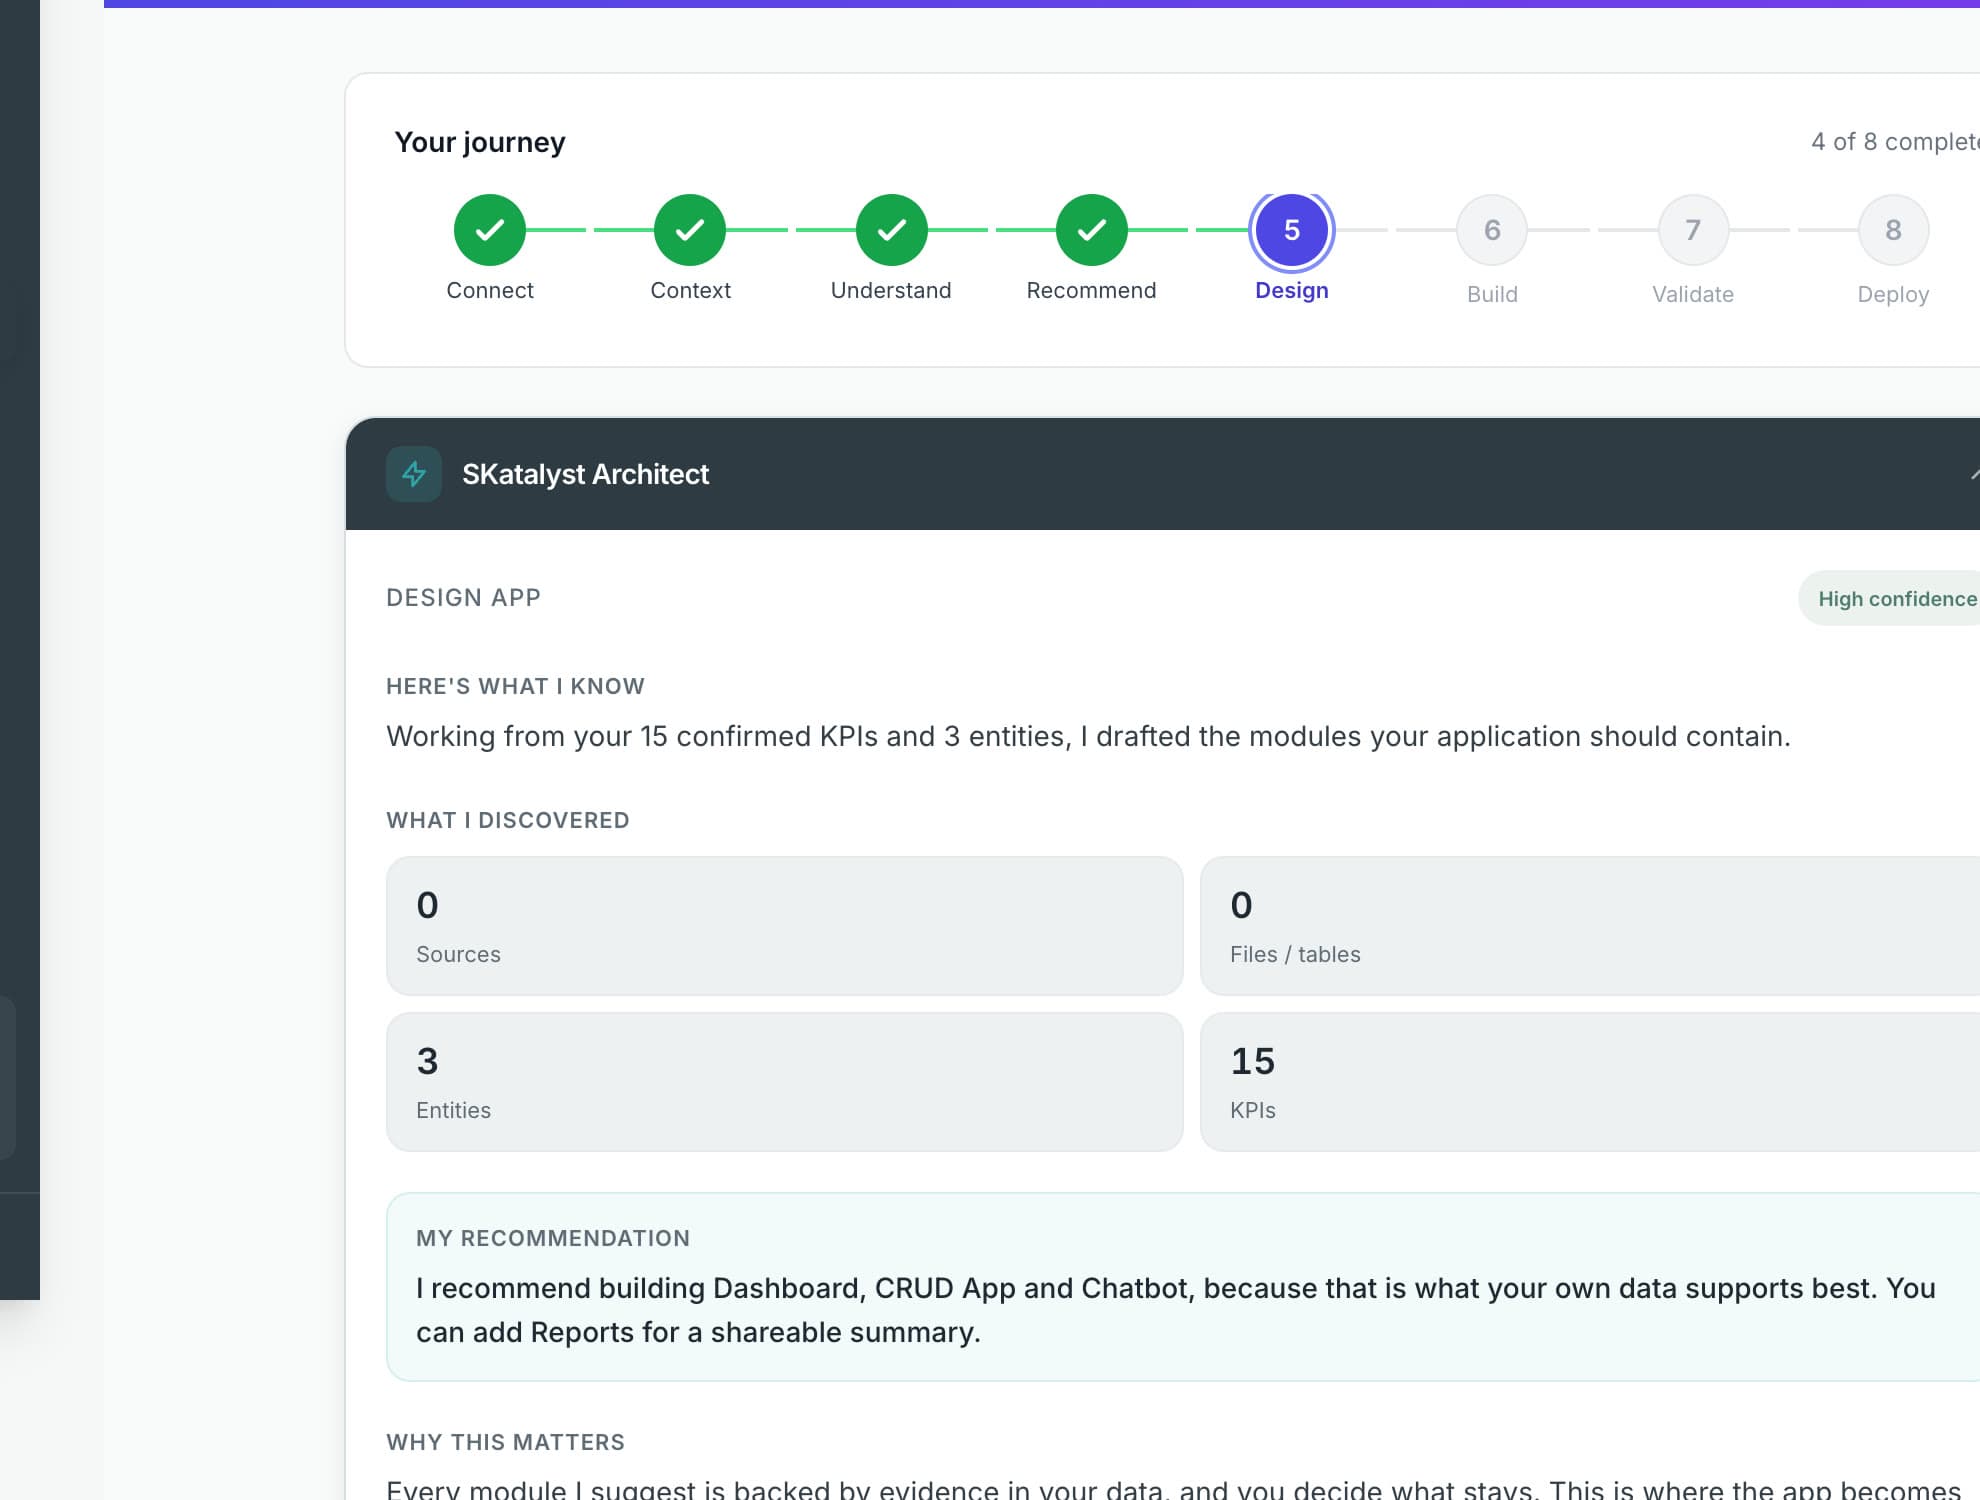
Étape de conception avec le stepper de voyage en huit étapes en haut et le panneau SKatalyst Architect : ce que j'ai découvert, ma recommandation, pourquoi c'est important.
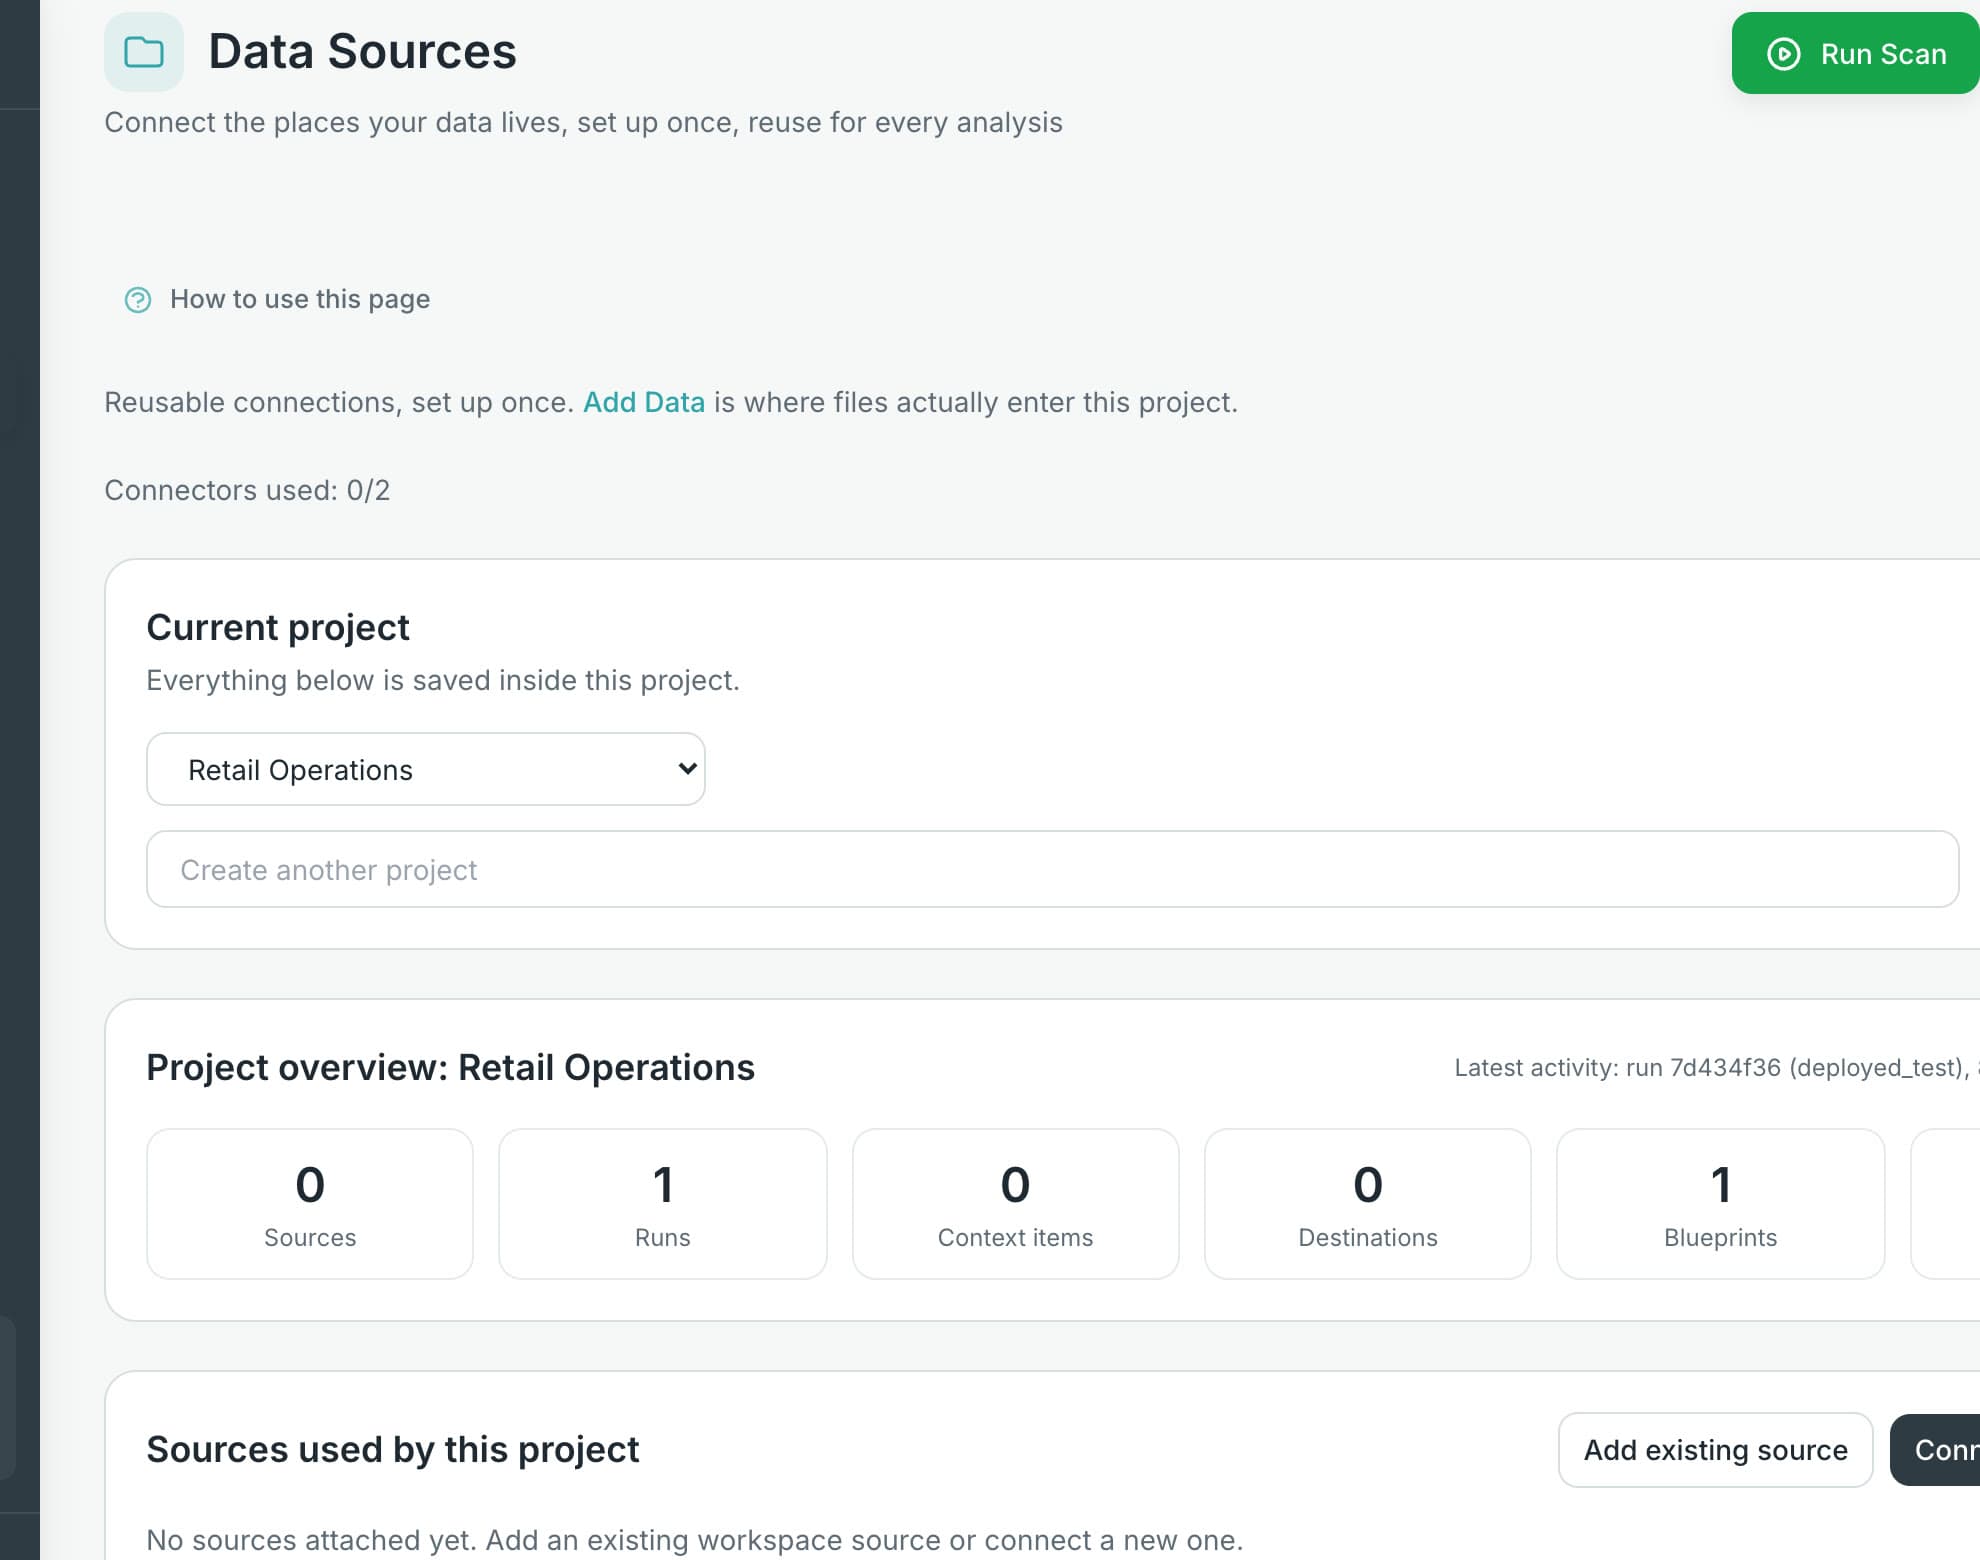
Page Sources de données : sélecteur de projet actuel, nombre d'aperçus du projet pour les sources, les exécutions, les éléments de contexte, les destinations, les plans et les métriques.
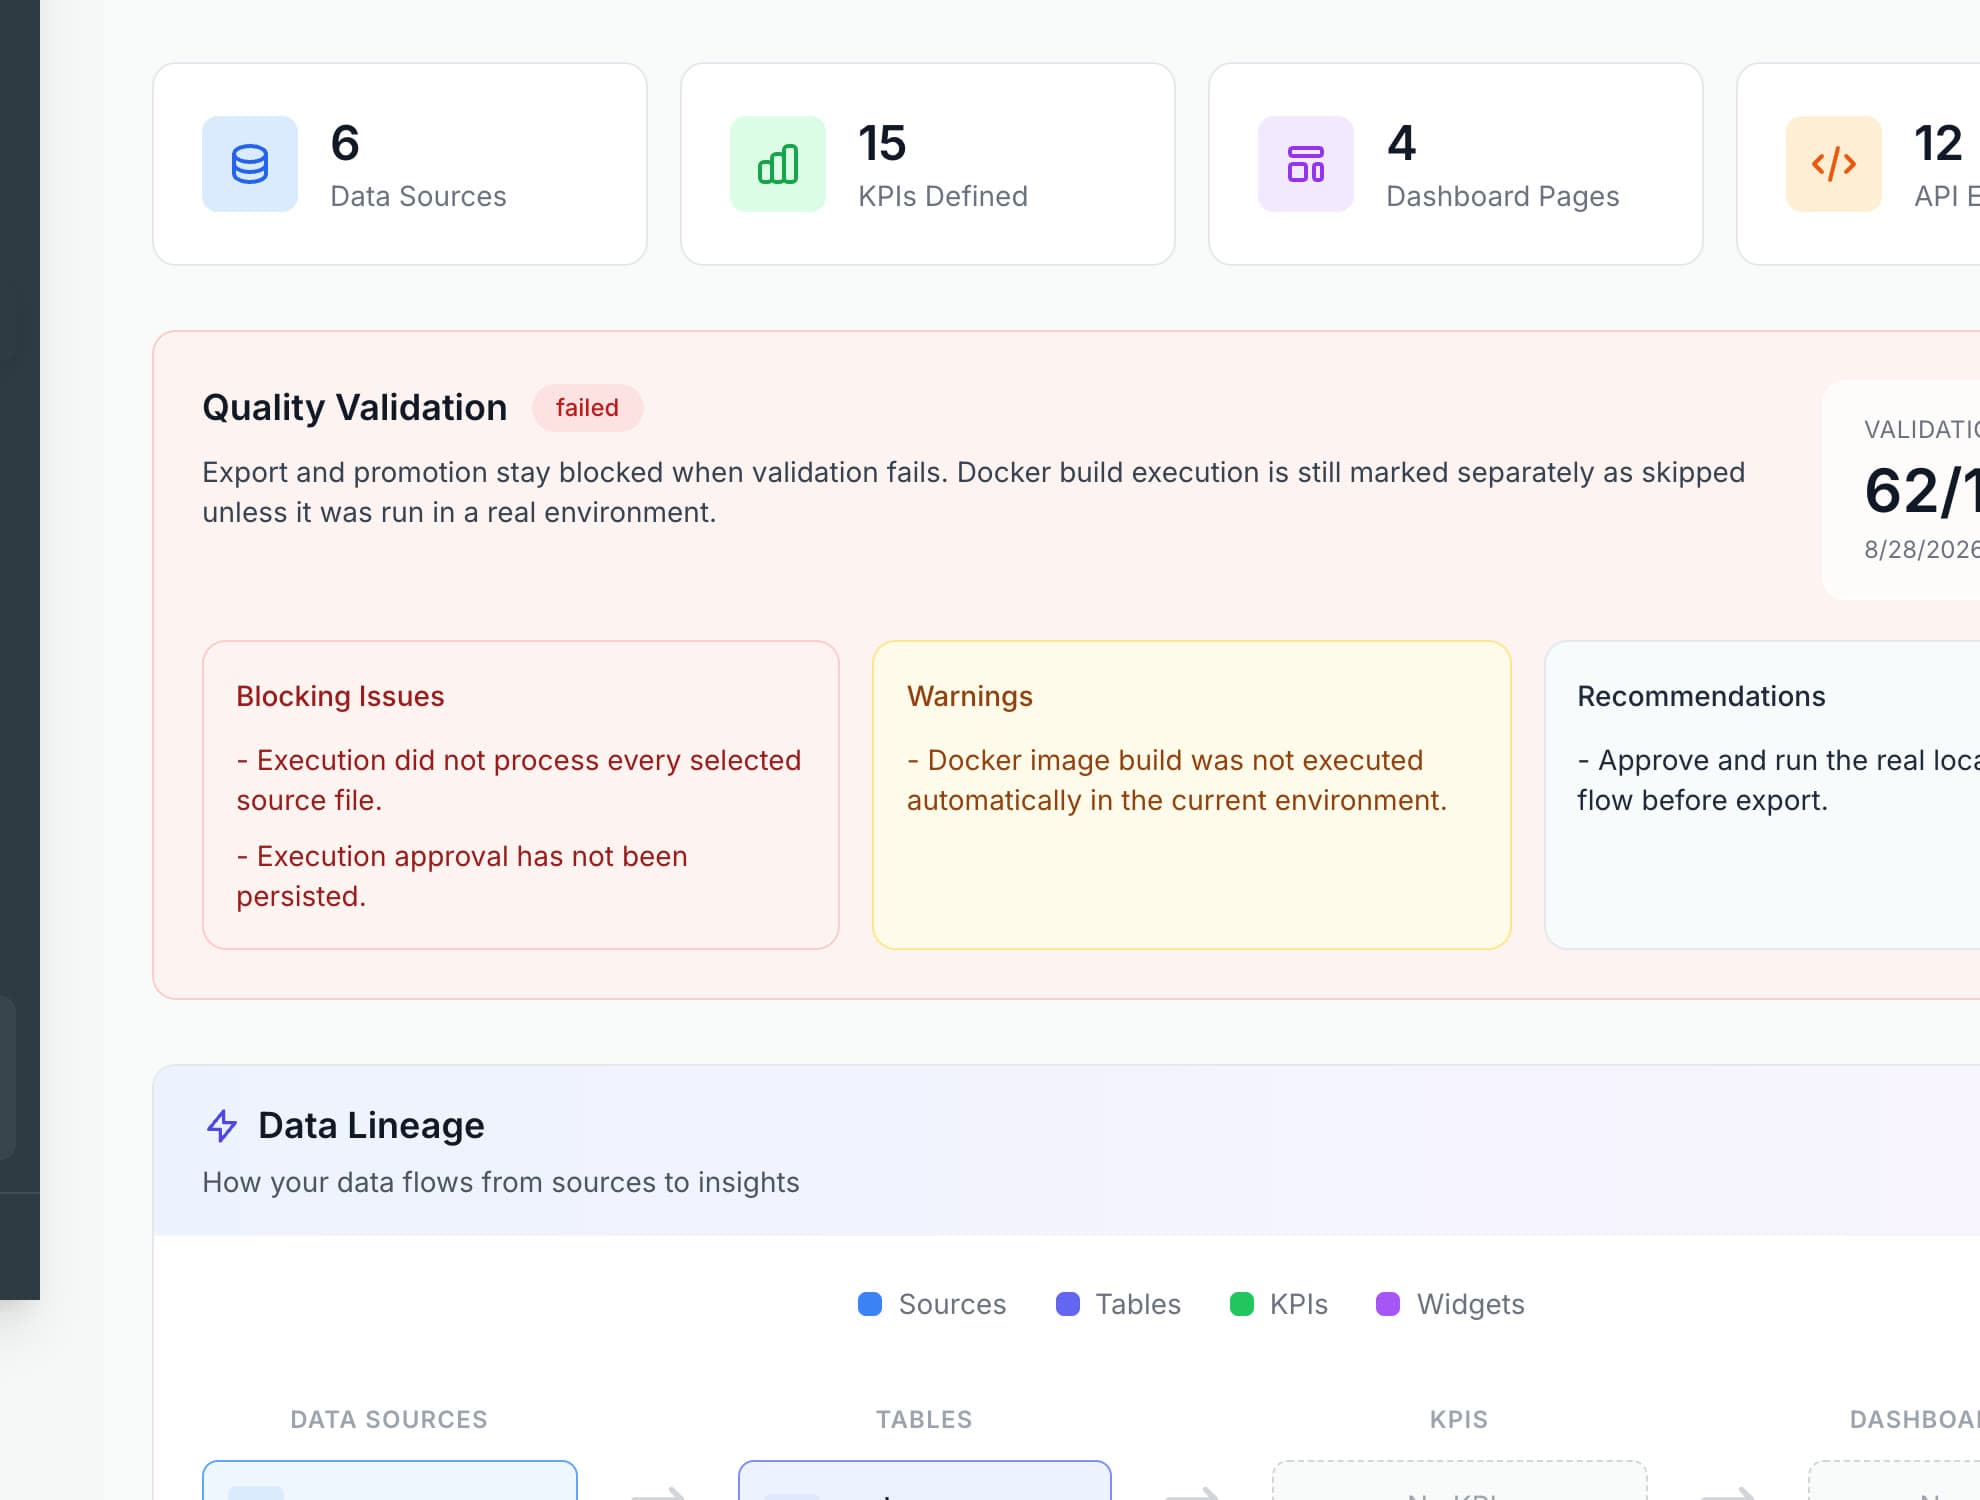
Résumé de la construction : 6 sources de données, 15 KPI, 4 pages de tableau de bord, 12 points de terminaison d'API et un panneau de validation de qualité qui bloque l'exportation en cas d'échec de la validation, répertoriant les problèmes de blocage, les avertissements et les recommandations.
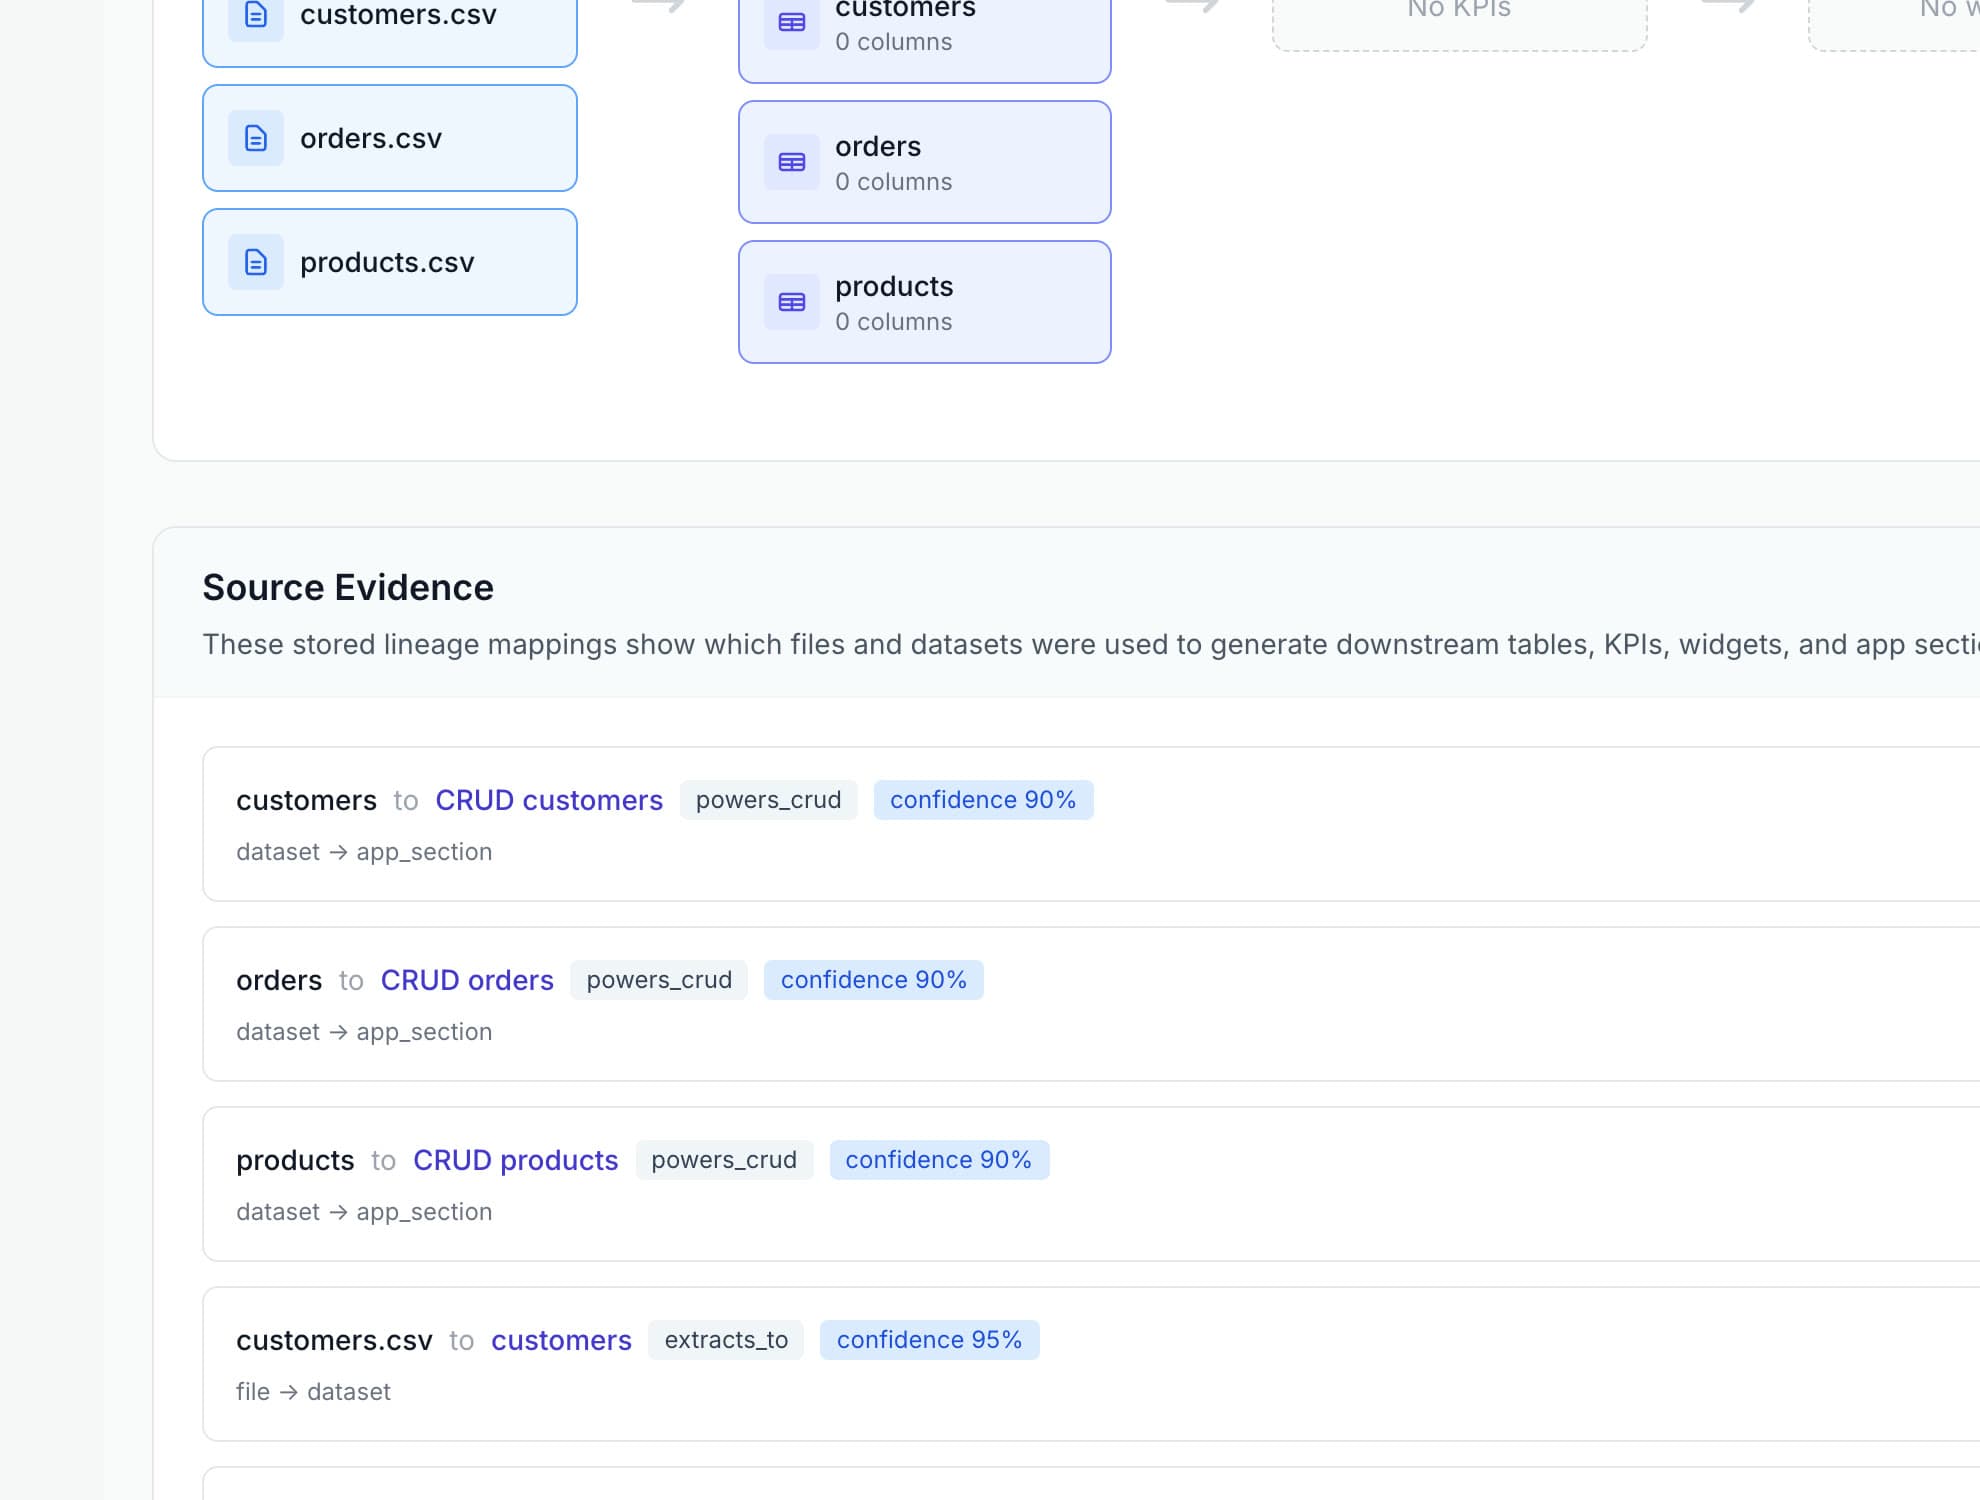
Traçabilité des données et preuves sources : mappages stockés montrant quels fichiers et ensembles de données alimentent chaque table, KPI et widget générés, en toute confiance.
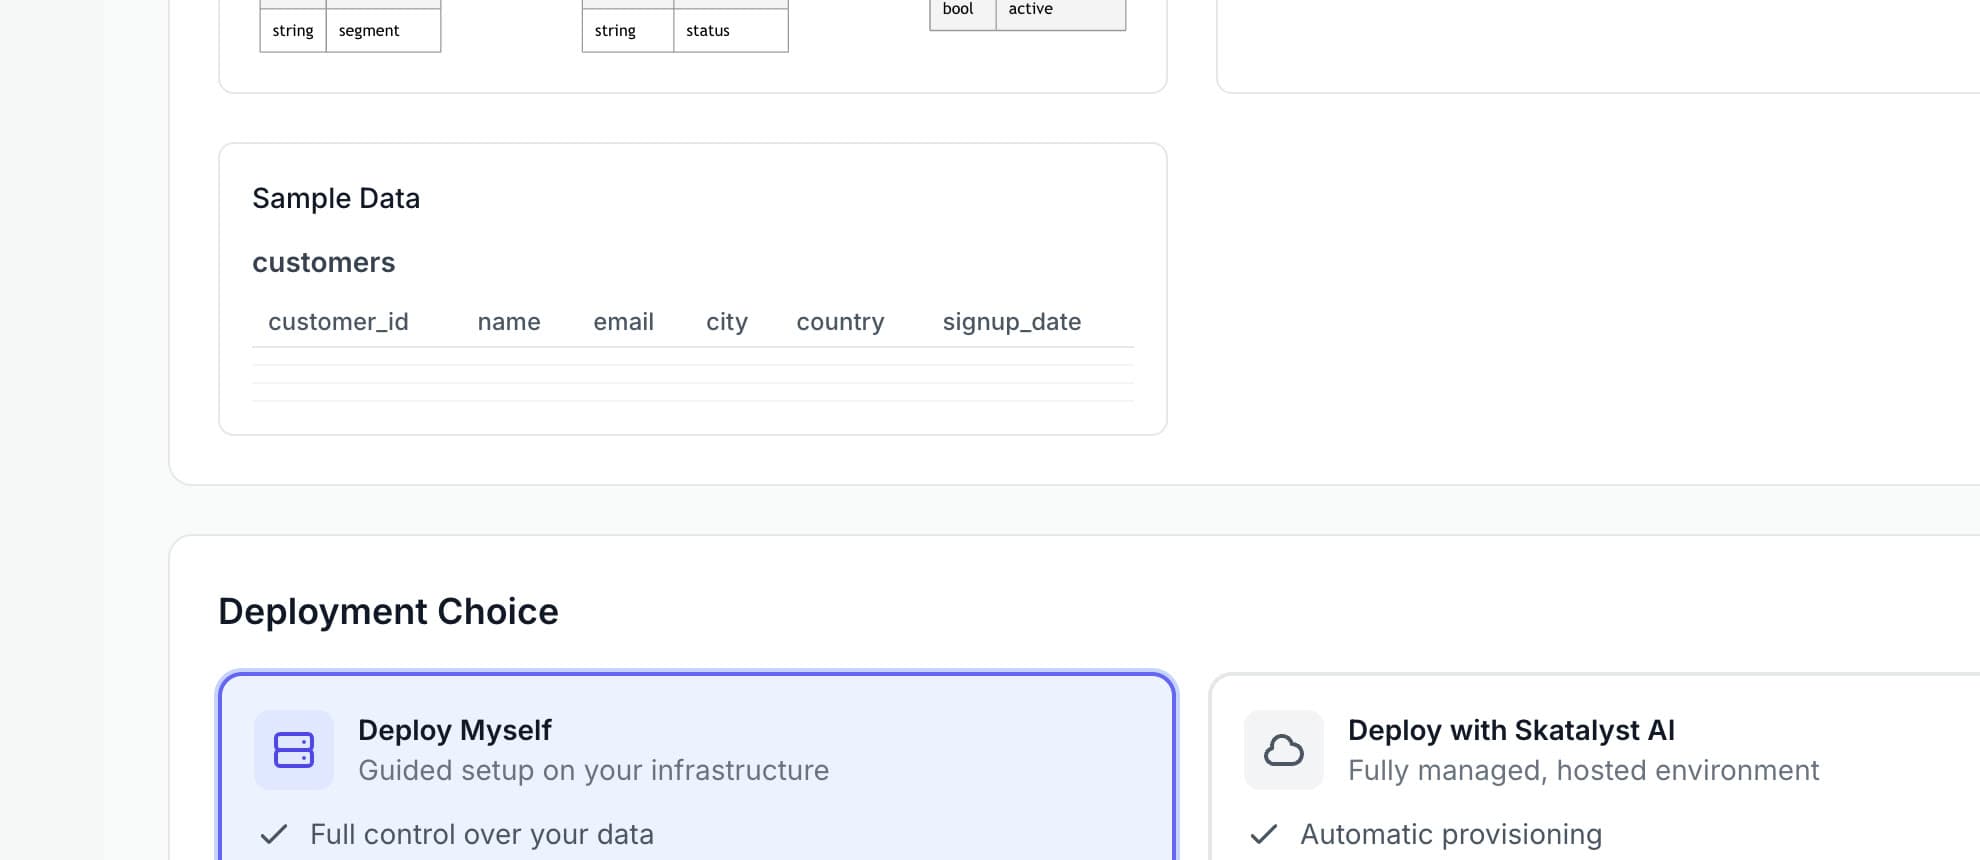
Choix de déploiement : déployer moi-même avec un contrôle total, des schémas téléchargeables et des instructions étape par étape, ou déployer avec l'hébergement géré SKatalyst AI.
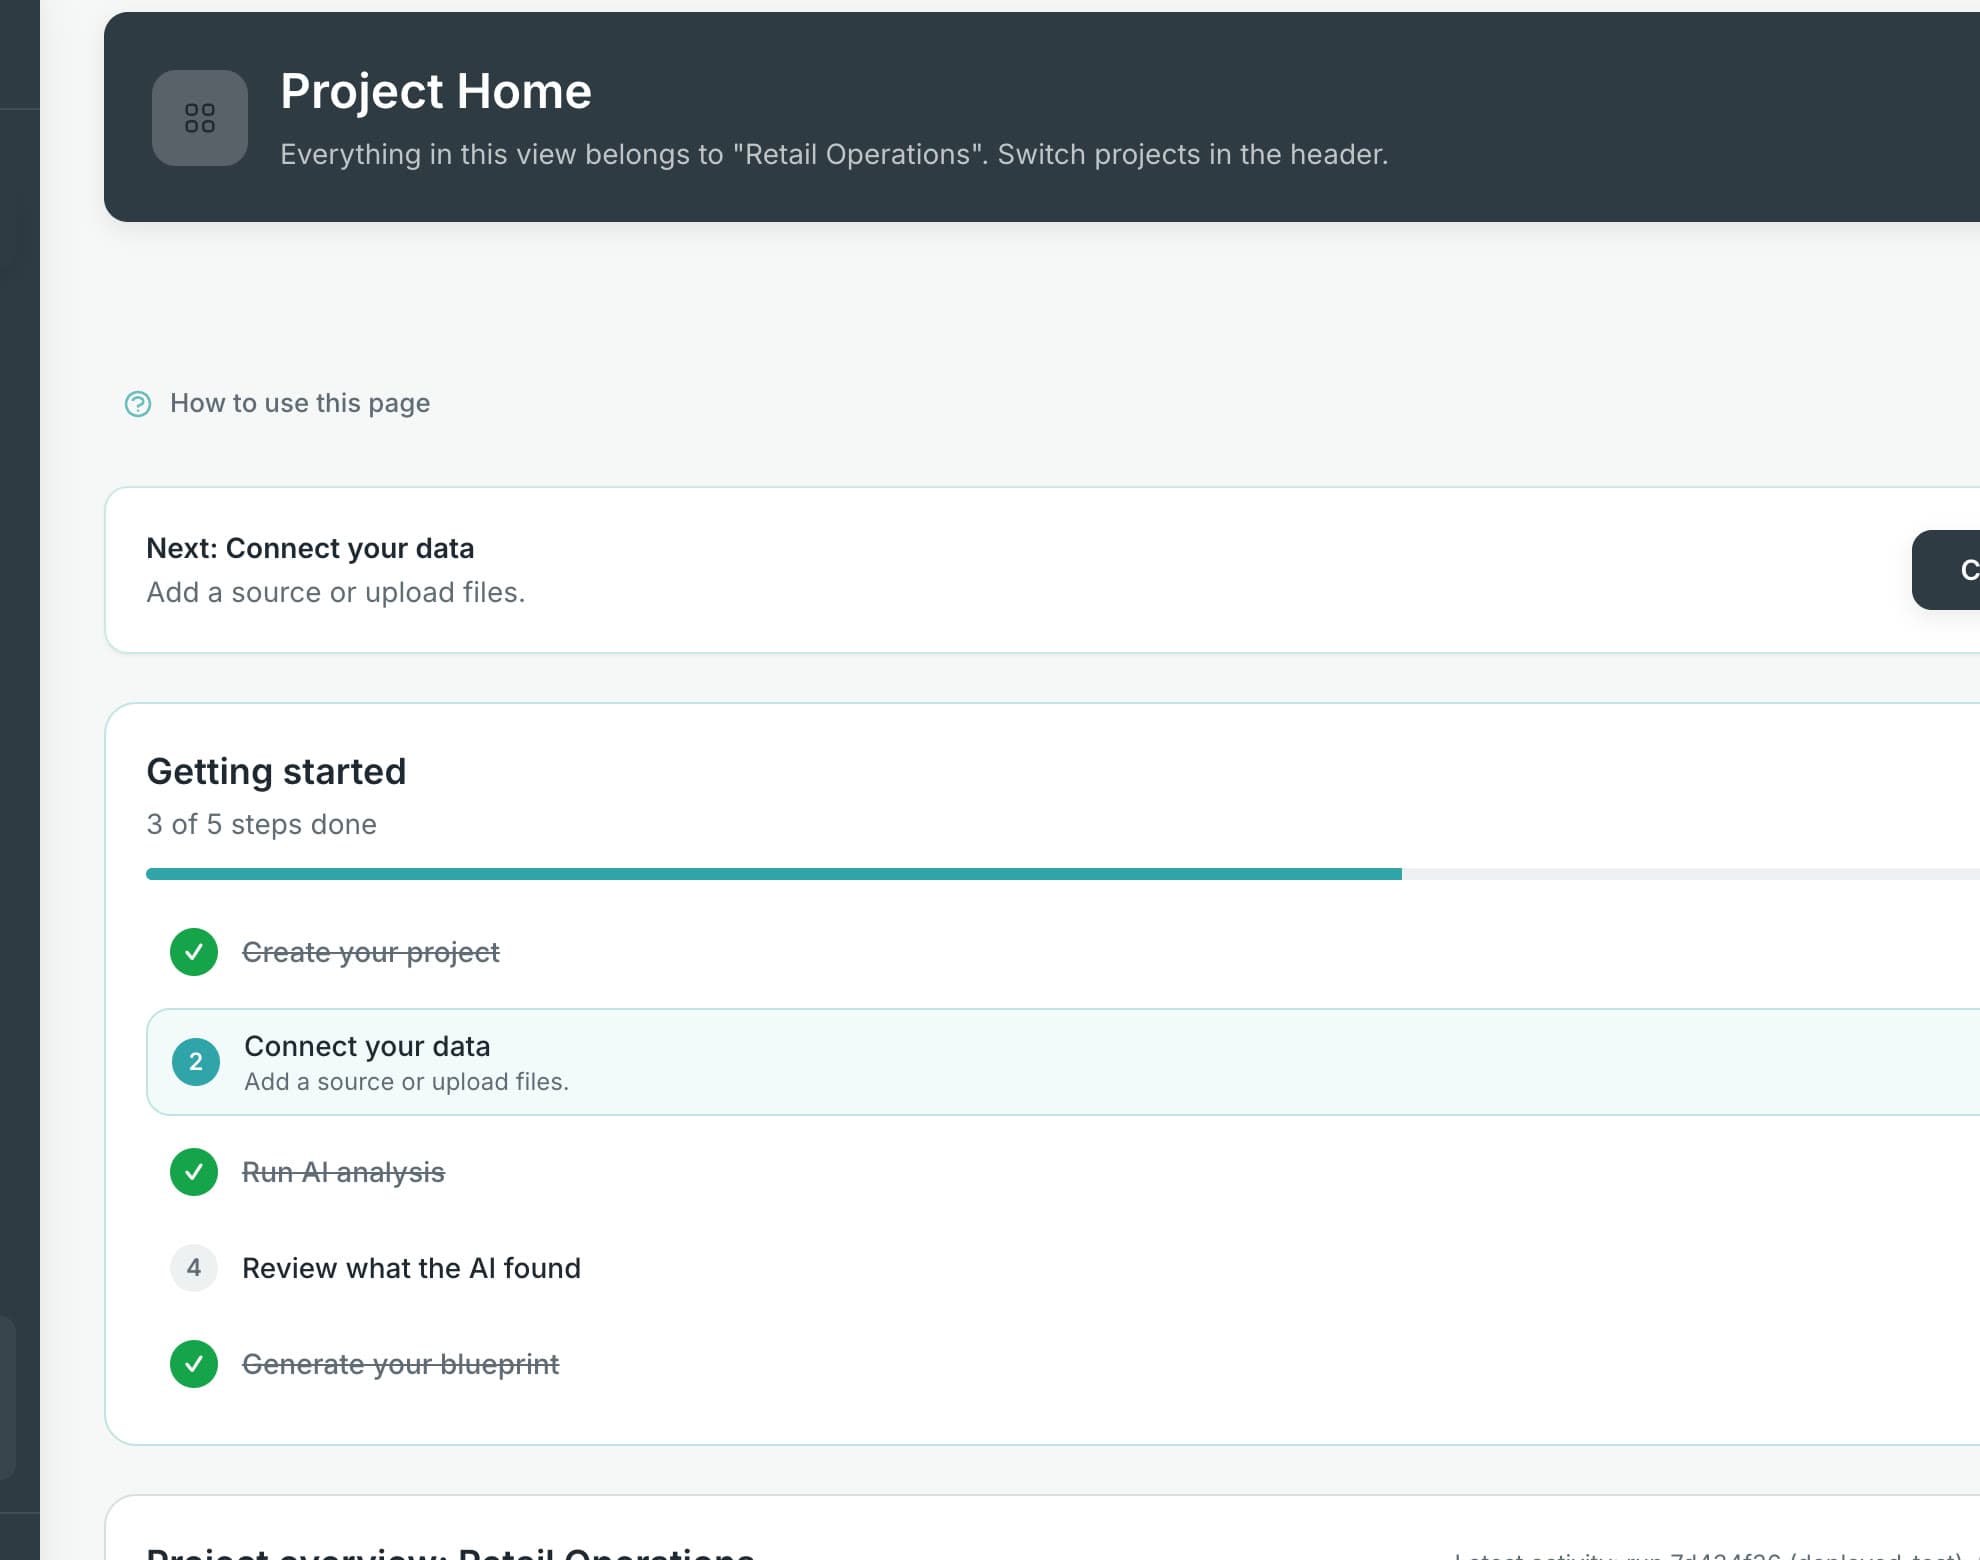
Accueil du projet avec une liste de contrôle de démarrage : créez votre projet, connectez vos données, exécutez une analyse de l'IA, examinez ce que l'IA a trouvé, générez votre plan.

09 · Ingénierie

Sous le capot

Vérifié à partir du référentiel, organisé par objectif. La plate-forme est un système Node et PostgreSQL avec une petite surface d'IA explicite.

Front-end

  • Réagir 18
  • Réagir au routeur 6
  • Tailwind CSS
  • i18suivant
  • réagir-dropzone
  • Diagrammes de sirène
  • Jest + Bibliothèque de tests (45 suites)

Back-end

  • Node.js (ESM)
  • Express 4 avec casque, limitation de débit, CORS
  • Générateur de requêtes Knex + pg
  • Validation Zod
  • File d'attente de tâches BullMQ + Redis
  • Multer, analyse PDF, mammouth, xlsx, Sharp, ffmpeg

Données

  • PostgreSQL 16
  • 51 migrations additives, environ 80 tables
  • Journal d'audit en ajout uniquement appliqué par le déclencheur
  • Instantanés de contexte avec intégrité SHA-256
  • Cartographies de lignage et résultats d'exécution

Nuage

  • Google Cloud Run (Europe-ouest1)
  • Cloud Build avec des images git-SHA
  • Hébergement Firebase pour l'application
  • Nuage SQL pour PostgreSQL
  • Exportation Docker pour l'auto-hébergement du client

Authentification

  • Google, Microsoft et GitHub OAuth
  • Sessions d'accès et d'actualisation JWT
  • Liaison d'un compte de messagerie vérifié
  • 4 rôles : propriétaire, administrateur, membre, spectateur
  • Porte d'accès bêta

Intégrations

  • Microsoft Graph (OneDrive, SharePoint)
  • API Google Drive, étendues en lecture seule
  • API Dropbox
  • API Databricks
  • Kits SDK AWS S3 et Azure Blob
  • Pilotes MySQL, SQL Server et PostgreSQL

IA

  • SDK Anthropique (plateforme)
  • BYOK : Claude, OpenAI, Gemini
  • Fournisseur heuristique déterministe comme solution de secours par défaut
  • 8 options d'exécution-IA pour les applications de chat générées
  • Tesseract et Google Vision OCR
  • Fonctionnalités de contrôle avec des alternatives infaillibles

Validation

  • Tester le compilateur Oracle
  • Exécuteur de référence
  • Sondes comportementales avec tests négatifs
  • Comparateur sensible aux tolérances
  • Rapport de validation avec provenance
  • Environ 600 tests automatisés sur plus de 100 fichiers

Architecture multi-tenant et sécurité

  • Isolement des locataires dans la base de données. Une clé étrangère composite lie chaque solution à son projet et à son locataire ; une ligne entre locataires n’est pas insérable et n’est pas simplement filtrée. Une exécution provenant d'un autre locataire se comporte exactement comme une exécution manquante, de sorte que l'API ne peut pas divulguer l'existence d'un identifiant.
  • Rôles. Propriétaire, administrateur, membre et spectateur, refus par défaut, avec une liste autorisée explicite pour les opérations en lecture seule.
  • Journal d’audit en ajout uniquement. Un déclencheur de base de données rejette les mises à jour et les suppressions ; les services ne peuvent jamais y écrire d'informations d'identification, de jetons ou de contenu de fichier.
  • Informations d'identification cryptées. Les secrets du connecteur et les clés BYOK sont cryptés AES-256-GCM avec une clé principale requise ; le frontend ne voit qu'une empreinte digitale.
  • Durcissement. Casque, limitation de débit soutenue par la base de données, validation du schéma, saisie nettoyée, flux de droits de données RGPD et politique de conservation écrite.

Choisir et connecter les modèles.

SKatalyst n'est pas lié à un seul fournisseur de modèles. Les locataires apportent leurs propres clés pour Claude, OpenAI ou Gemini ; les clés sont chiffrées au repos, déchiffrées uniquement lors de l'exécution, et une clé active par fournisseur est appliquée. Les applications de chat générées utilisent le propre fournisseur d'exécution du client, choisi au moment du déploiement, jamais demandé lors de la conception.

La valeur réside autour des modèles : le contexte, les workflows, les données structurées, l'architecture applicative et le système de validation.

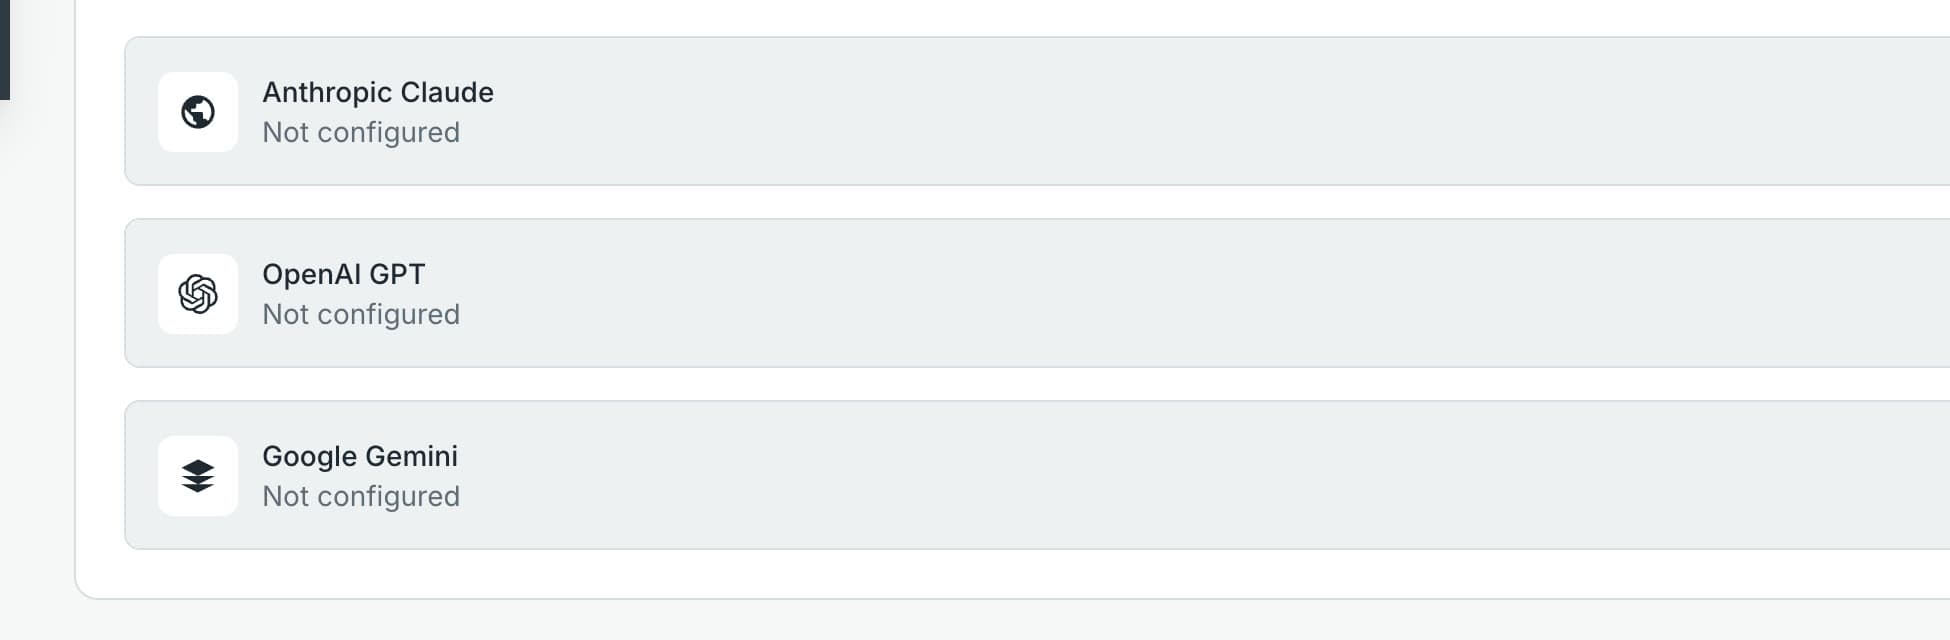
Paramètres, clés API LLM : apportez votre propre clé pour Anthropic Claude, OpenAI GPT et Google Gemini.
12
types de sources
10
types de modules de solution
4
expédition de générateurs
12
états du cycle de vie
2
portes d'approbation humaine
5
types d'assertions
3
Fournisseurs OAuth
4
rôles des locataires
3
Fournisseurs de modèles BYOK
51
migration de bases de données
390+
Points de terminaison de l'API
~600
tests automatisés

Tous les chiffres comptés à partir du référentiel le 28 août 2026 : 180 commits depuis juin 2025. Le nombre de points de terminaison est un plancher (391 dans le routeur principal plus 11 modules de route).

10 · Évolution

Du prototype à la plateforme

  1. Semence

    Structure initiale du projet.

  2. Ingestion de données

    Pipeline d’ingestion de documents, classification assistée par LLM avec une solution de repli heuristique et un registre de fournisseurs indépendant du fournisseur.

  3. Compréhension du contexte jusqu'à la génération

    Modèle de métriques, génération de plans et première exportation d'artefacts : de l'organisation des données à la génération de logiciels en quelques jours.

  4. Stockage structuré, location, connecteurs

    Schéma multi-tenant, OAuth, coffre-fort chiffré et BYOK, OCR et compréhension visuelle, dix backends de connecteurs, instantanés de contexte immuables, exécutions orchestrées et découverte de KPI.

  5. Audit de préparation à la production

    Un audit autocritique a répertorié les lacunes : porte bêta, limitation de débit, en-têtes, bibliothèque de validation, isolation non prouvée. La plupart ont été fermés dans les semaines suivantes.

  6. Validation comportementale

    La boucle de validation agentique a été divulguée et construite par incréments : compilateur Oracle, exécution de référence avec détection d'anomalies, sondes comportementales. Dossier de brevet déposé.

  7. Cycle de vie d'approbation

    L'entité Solution avec sa machine à 12 états, ses deux portes humaines distinctes et ses événements d'audit transactionnel.

  8. Bêta opérationnelle

    Administrateur d'atterrissage, compteurs de limite de débit, déploiement et vérification des runbooks, intégration et application authentifiée gelée pour la version bêta de septembre 2026.