← Alle Projekte

Projekt 01 · Agentische KI · Datenintelligenz · Anwendungsgenerierung · KI-Engineering

SKatalyst AI

Verwandeln Sie Organisationsdaten in Kontext und Kontext in Software.

Organisationen verfügen bereits über enorme Mengen nützlicher Daten, diese sind jedoch fragmentiert auf Dateien, Datenbanken, Cloud-Speicher, Dokumente, Berichte und interne Systeme. SKatalyst AI ist ein Versuch, die Schicht zwischen diesen Rohdaten der Organisation und der Software aufzubauen, die die Mitarbeiter tatsächlich benötigen.

Anstatt mit einer Anwendung zu beginnen und Daten manuell darin zu verknüpfen, beginnt SKatalyst mit den vorhandenen Informationen der Organisation. Es nimmt es auf. Versteht es. Strukturiert es. Baut einen Kontext darauf auf. Anschließend nutzt es dieses strukturierte Verständnis, um nützliche Anwendungen zu generieren.

Status
Private Beta, September 2026
Rolle
Gründerin, Produkt, Architektur, Ingenieurwesen
Seitdem
2025
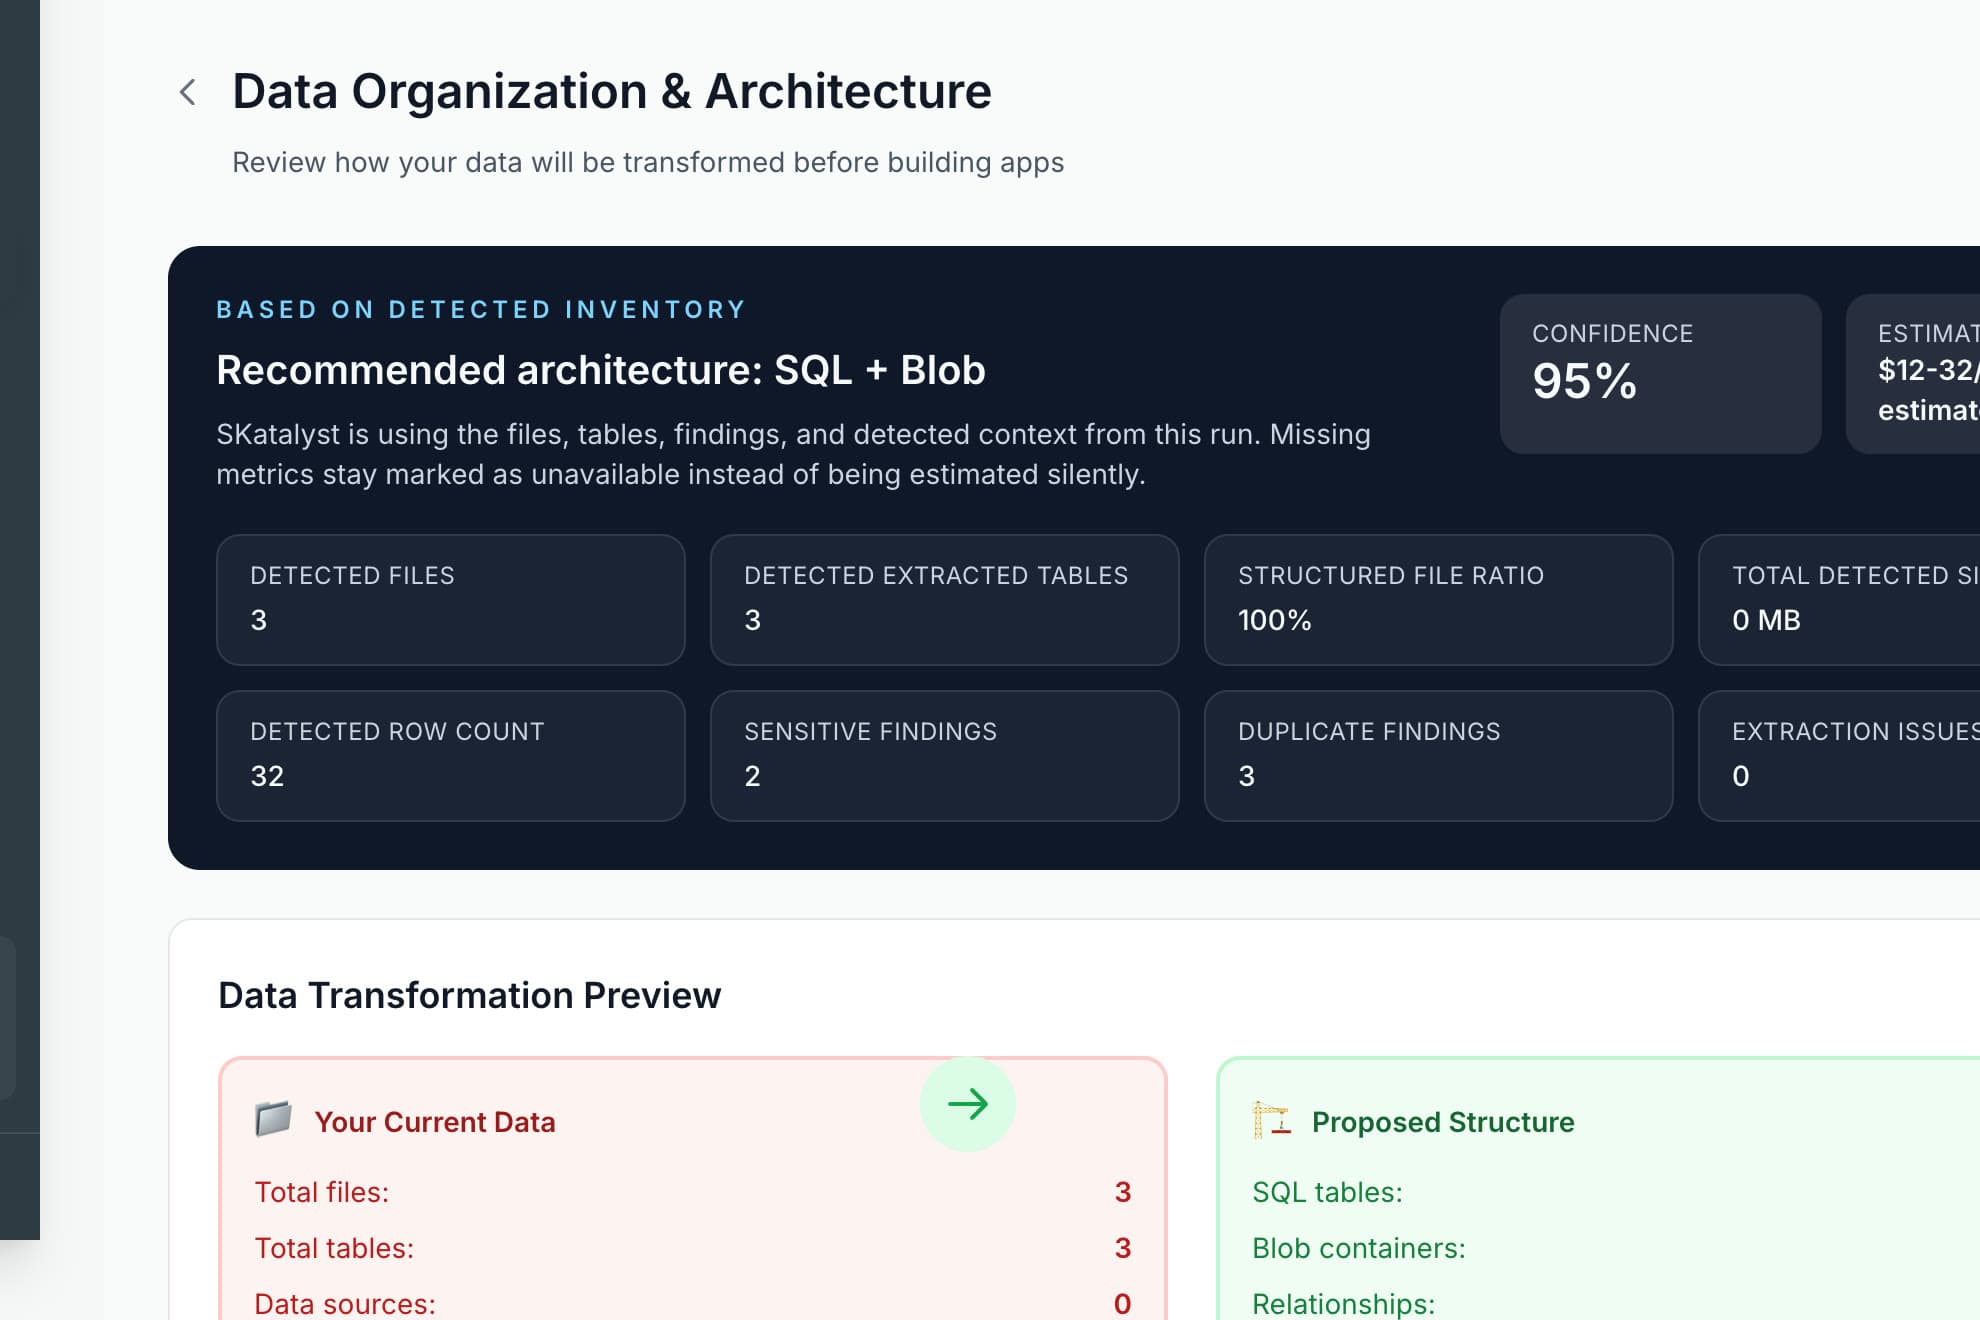
SKatalyst AI empfiehlt eine SQL + Blob-Architektur mit 95 % Konfidenz aus einem erkannten Inventar von drei Tabellen, mit einer Datentransformationsvorschau.

01 · Das Problem

Warum ich SKatalyst AI gegründet habe.
Es fehlt der Kontext.

Die meisten Organisationen verfügen bereits über die benötigten Informationen. Es existiert lediglich als separate Dateien und Zeilen, verteilt auf Laufwerke, Postfächer, Datenbanken und Tools, die nie darauf ausgelegt sind, sich gegenseitig zu erklären.

Eine Person versteht die Zusammenhänge implizit: Diese Tabelle gehört zu diesem Projekt, dieser Bericht beschreibt diesen Test, diese Tabelle enthält die Messungen, dieses Dokument definiert den Prozess. Normalerweise sieht die Software nichts davon. SKatalyst versucht, diesen fehlenden organisatorischen Kontext zu rekonstruieren und beizubehalten.

  • „Diese Tabelle gehört zu diesem Projekt.“
  • „Dieser Bericht beschreibt diesen Test.“
  • „Diese Datenbanktabelle enthält die Messungen.“
  • „Dieses Dokument definiert den Prozess.“
Excel-DateienPDFsWord-DokumenteSharePointGoogle DriveOneDriveDatenbankenCloud-SpeicherDatensteineBerichteBilderInterne WerkzeugeAPIsCSV-Exporte
Eine strukturierte SchichtOrganisatorischer KontextEntitäten · Beziehungen · Abstammung · Definitionen

02 · Die Idee

Daten→Kontext→Struktur→Bewerbung

SKatalyst AI speichert und prüft, was es über die Daten einer Organisation lernt, und nutzt diesen Kontext, um Software zu erzeugen.

  1. 01Verbinden

    Bringen Sie Unternehmensdaten dort ein, wo sie sich bereits befinden: Uploads, Laufwerke, Buckets und Datenbanken.

  2. 02Verstehe

    Nur lesend scannen. Extrahieren Sie Texte und Tabellen, OCR Bilder, lesen Sie Schemata, Metadaten und Beziehungen.

  3. 03Organisieren

    Schlagen Sie eine Struktur vor: Entitäten, ein Schema, eine Ordnertaxonomie, Qualitätsergebnisse und eine empfohlene Architektur.

  4. 04Speichern

    Behalten Sie das Ergebnis in PostgreSQL bei, damit das Verständnis jedes einzelne KI-Gespräch überdauert.

  5. 05Design

    Entdecken Sie KPIs, die die Daten tatsächlich berechnen können, und entscheiden Sie, welche Module sie verfügbar machen.

  6. 06Generieren

    Erstellen Sie funktionierende Anwendungskomponenten: Dashboard, CRUD, Bericht, RAG-Chat sowie eine Datenbank und API.

  7. 07Validieren

    Kompilieren Sie ein Testorakel aus dem Datenmodell und vergleichen Sie das generierte Verhalten mit Referenzwerten.

  8. 08Betreiben

    Vorschau in einer kurzlebigen Laufzeit, Export eines Docker-Pakets, das dem Kunden gehört, Überprüfung, Rollback bei Bedarf.

03 · Wie es funktioniert

Von Dateien bis zum organisatorischen Kontext

Jeder Lauf liest die Quelldaten und baut strukturierten Kontext auf, der geprüft und wiederverwendet werden kann.

Bei einem schreibgeschützten Scan wird ein Inventar erstellt, das vom Benutzer genehmigt wird. Ein Strukturierungsplan schlägt Entitäten, ein Schema und eine Ordnertaxonomie vor. Eine Architekturempfehlung erläutert deren Zuverlässigkeit und was von der Schätzung ausgeschlossen wurde. Die KPI-Erkennung bietet nur Metriken, die die Daten berechnen können. Jeder Schritt wird in PostgreSQL mit Herkunft zurück zu den Quelldateien gespeichert, und der von einem Lauf verwendete Kontext wird beim Start eingefroren und gehasht, damit er später rekonstruiert werden kann.

Das LLM sollte nicht die Datenbank sein.

Das Modell interpretiert. Das daraus resultierende Verständnis wird in strukturierten, persistenten Tabellen gespeichert, sodass das Organisationswissen nicht bei jeder Eingabeaufforderung von Grund auf neu aufgebaut wird.
  1. 01Rohquellen
  2. 02Einnahme
  3. 03Extraktion
  4. 04Metadaten
  5. 05Beziehungen
  6. 06Kontextanalyse
  7. 07Strukturierte Einheiten
  8. 08Datenbank
  9. 09Wiederverwendbarer Organisationskontext
  10. 10Anwendungen und KI
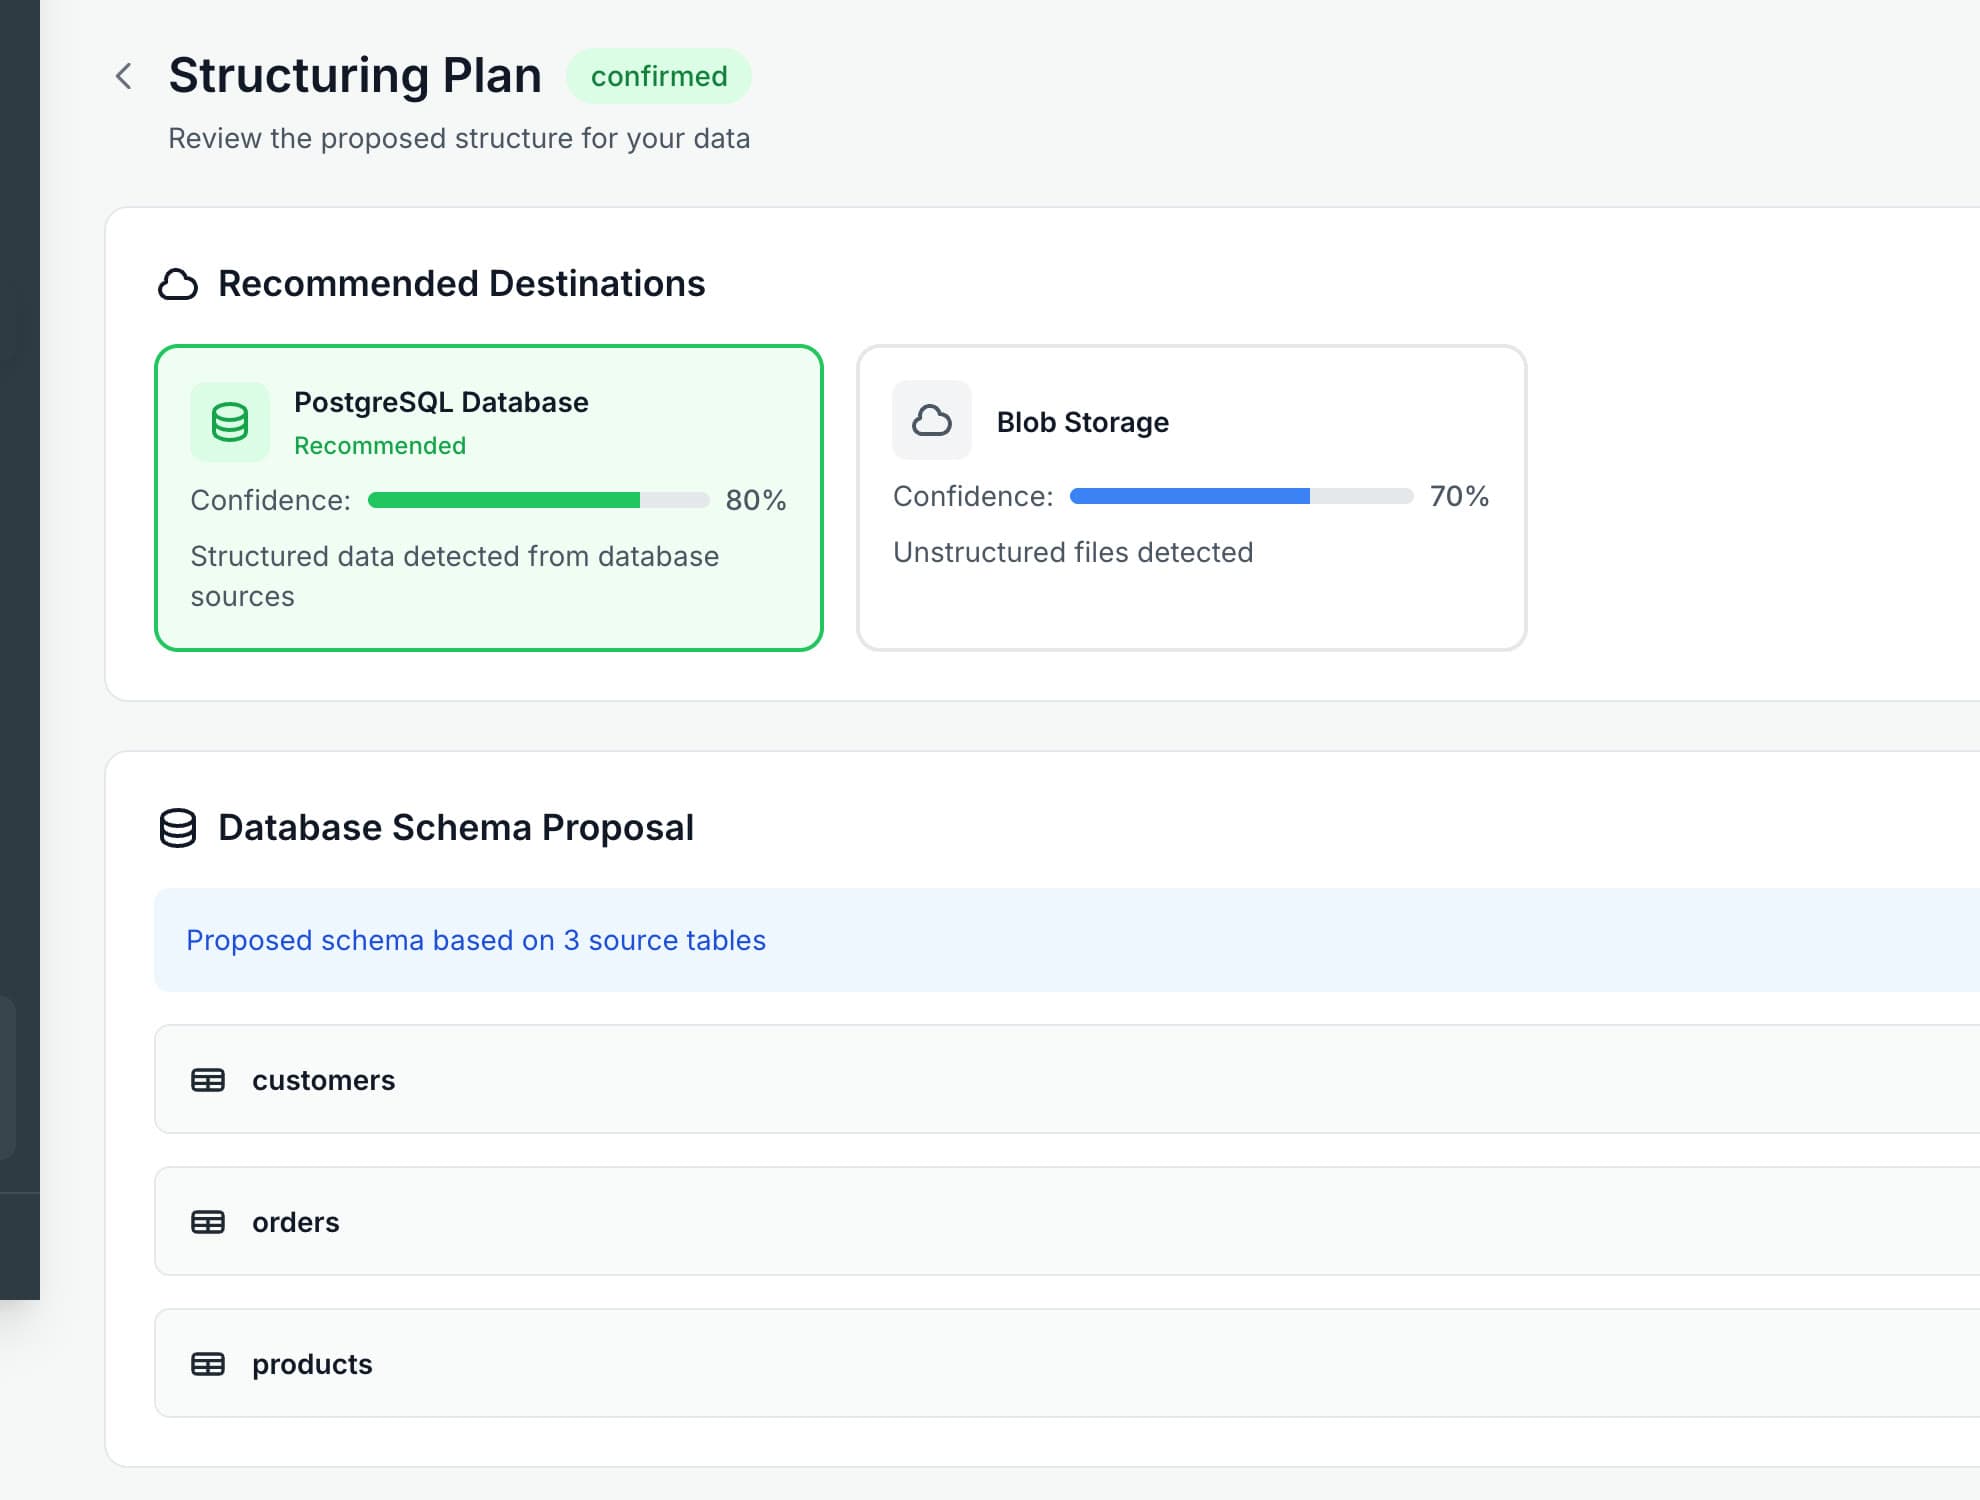
Strukturierungsplan: Mit Vertrauen empfohlene Ziele und ein Datenbankschemavorschlag für Kunden, Bestellungen und Produkte.
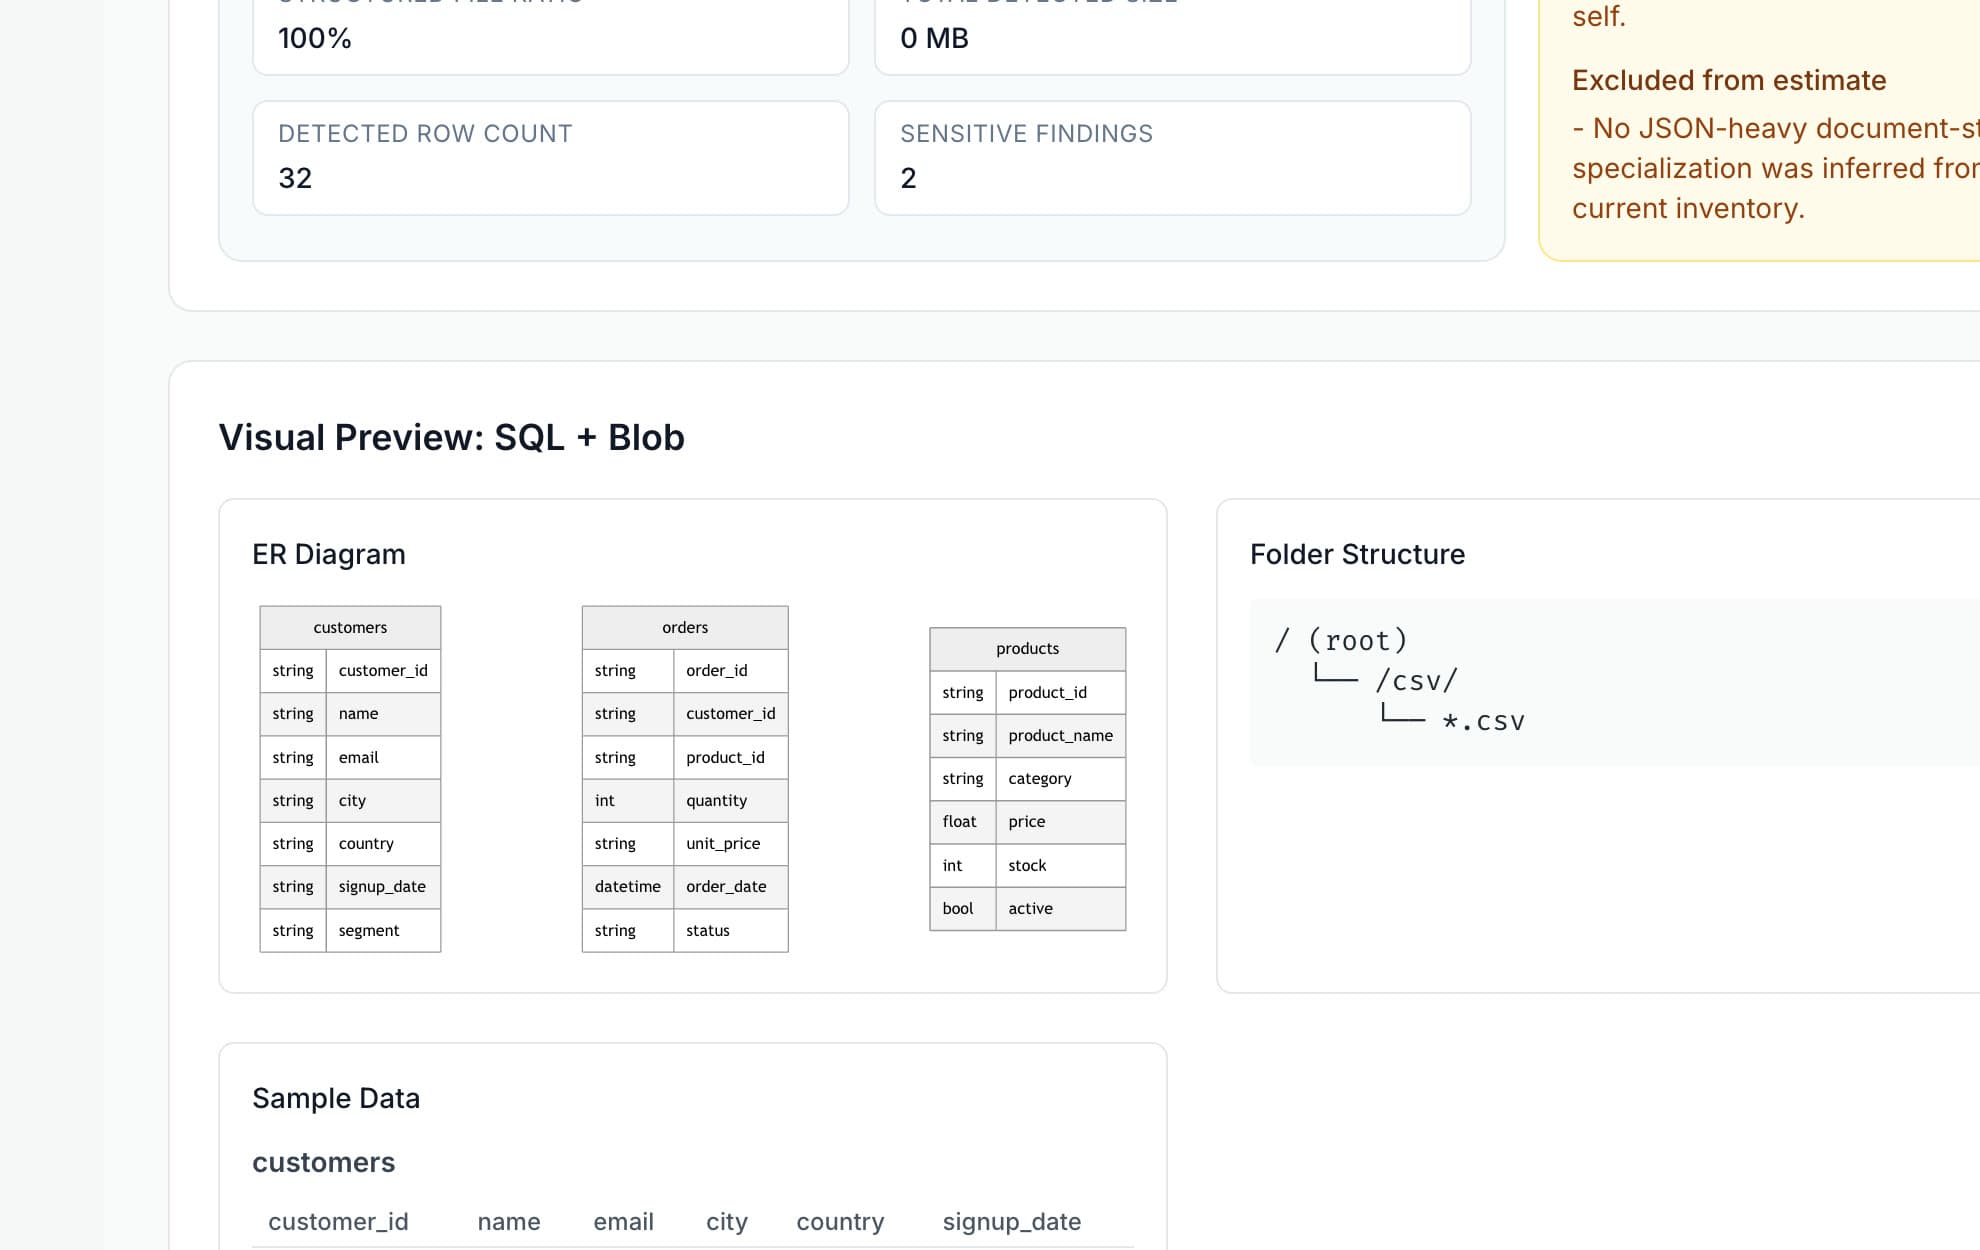
Visuelle Vorschau der vorgeschlagenen SQL + Blob-Architektur: ein ER-Diagramm für Kunden, Bestellungen und Produkte, eine Ordnerstruktur und Beispieldaten.

04 · Die Intelligenzschicht

Wo ich KI in der Pipeline einsetze.

SKatalyst kombiniert deterministische Software mit KI-Argumentation und sorgt dafür, dass die Grenzen sichtbar bleiben. Der Standardplattformanbieter ist eine deterministische Heuristik; Ein Modell wird hinzugefügt, wenn ein Schlüssel konfiguriert wird, und Funktionen, die eines benötigen, werden auf einen Nicht-KI-Pfad herabgestuft, anstatt auszufallen.

Deterministische Schicht

Garantiert durch Code, Tests und die Datenbank.

  • Quellanschlüsse
  • OAuth und Sitzungen
  • Dateiverwaltung und -extraktion
  • Schemainspektion
  • Metadatenextraktion
  • Datenbankoperationen
  • Isolation der Mieter
  • Rollen und Berechtigungen
  • Migrationen
  • Anwendungslaufzeit
  • Validierungsregeln
  • Audit-Protokollierung

KI-Argumentationsebene

Wo eine Interpretation wirklich erforderlich ist.

  • Klassifizierung mehrdeutiger Dokumente
  • Semantische Beziehungen finden
  • Organisation und Kontext vorschlagen
  • Dokumentinhalte interpretieren
  • Eine Architektur empfehlen
  • KPIs und Module vorschlagen
  • Anwendungscode generieren
  • Validierungsergebnisse erklären

Software garantiert, was garantiert werden kann. KI kümmert sich um das, was interpretiert werden muss. Beides gilt nicht als richtig: Vorschläge sind vertrauenswürdig, nicht verfügbare Metriken werden als nicht verfügbar markiert und ein Mensch bestätigt dies, bevor etwas erstellt wird.

05 · Systemarchitektur

Die sieben Schichten des Systems.

Verifiziert anhand der Quelle der Plattform. Jede Ebene hängt nur von den darüber liegenden Ebenen ab. Die Validierung liegt absichtlich zwischen Generierung und Lieferung.

  1. 01

    Quellebene

    • Lokaler Upload
    • Lokaler Ordner-Agent (Go)
    • Google Drive
    • OneDrive
    • SharePoint
    • Dropbox
    • Amazon S3
    • Azure Blob
    • Datensteine
    • PostgreSQL
    • MySQL
    • SQL-Server

    12 Quellentypen. Cloud- und Datenbankkonnektoren lesen heute Metadaten; Die Ausführung bleibt in der Vorschau, bis sie anhand eines echten Kontos nachgewiesen wird.

  2. 02

    Aufnahme und Verständnis

    • Nur-Lese-Scan mit Zeitüberschreitungen und Abbruch
    • 7 Extraktoren: PDF, DOCX, XLSX, CSV, JSON, Markdown, Text
    • OCR: Tesseract oder Google Vision
    • Budgetiertes visuelles Verständnis für Bilder
    • Erkenntnisse zur Bestandsaufnahme und Datenqualität
    • Bewertung der Kontexttaxonomie

    Jeder Lauf beginnt mit einer Bestandsaufnahme, die der Benutzer genehmigt.

  3. 03

    Kontext- und Datenschicht

    • Wiederverwendbare Kontextbibliothek
    • Eingefrorene Kontext-Snapshots mit SHA-256-Hashes
    • Strukturierung von Plänen und Inventaren
    • KPI-Entdeckungen mit Konfidenzwerten
    • Herkunftszuordnungen von der Datei zur Ausgabe
    • PostgreSQL 16, 51 Migrationen, etwa 80 Tabellen

    Das Verständnis wird gespeichert, versioniert und nachvollziehbar und nicht per Eingabeaufforderung neu abgeleitet.

  4. 04

    Intelligenz und Orchestrierung

    • Orchestrator ausführen: Scannen, Zusammenführen, Genehmigen, Planen
    • Architekturempfehlung
    • KPI-Erkennung
    • Designverhandlung
    • Codegenerierung
    • Claude-Anbieter plus ein deterministischer heuristischer Fallback

    Jeder KI-Schritt hat einen Nicht-KI-Pfad oder ein BYOK-Gate; Die Plattform rät nie stillschweigend.

  5. 05

    Anwendungsgenerierung

    • Armaturenbrett
    • CRUD-Anwendung
    • Bericht
    • Chat / RAG (vom Kunden zur Laufzeit eingegeben)
    • React + Express + Docker-Ausgabe
    • Schemabereitstellung und Beispiel-Seeding

    4 Generatoren versandt; 10 Modultypen deklariert.

  6. 06

    Validierung

    • Testen Sie den Oracle-Compiler
    • Referenzvollstrecker
    • Verhaltenssondenläufer
    • Toleranzbewusster Komparator
    • Validierungsbericht mit Herkunft
    • Vergängliche, TTL-begrenzte Laufzeit

    Das Orakel liest niemals generierten Code, daher kann sich ein Generatorfehler nicht verstecken.

  7. 07

    Lieferung

    • Vorschau auf Architektur, Implementierung und Ausführung
    • Vergängliche Vorschau-Laufzeit
    • Docker-Export mit Dokumentation und Eigentumsdateien
    • Bereitstellungsüberprüfung und geführtes Rollback
    • Managed Hosting aufgebaut, Flag-Off

    Der Export ist blockiert, während die Validierung fehlschlägt. Diese Blockade ist beabsichtigt.

Neben der Plattform: ein schreibgeschützter lokaler Server-Agent, geschrieben in Go (ca. 1.600 Zeilen) für lokale Ordner, mit Pfad-Zulassungsliste, Musterausschlüssen, einem Kill-Switch und einem Heartbeat. Keine Schreibvorgänge, keine Telemetrie.

Anschlüsse

Bestehende Datenquellen anbinden.

SKatalyst verlangt nicht, dass das Unternehmen alles in ein neues Ökosystem verlagert, bevor es mit dem Verständnis der Daten beginnen kann.

Zwölf Quelltypen sind implementiert, vom lokalen Upload bis hin zu Databricks. Die folgenden Bezeichnungen sind produktspezifisch: Ein Konnektor verlässt die Vorschau möglicherweise erst, wenn ein echter Byte-Lesevorgang für ein echtes externes Konto nachgewiesen und aufgezeichnet wurde. Das Verbinden und Surfen funktioniert bereits; Der lokale Upload führt heute die gesamte Pipeline aus.

  • Lokaler UploadProduktion
  • Lokaler Ordner-AgentBeta
  • OneDriveVorschau
  • SharePointVorschau
  • Google DriveVorschau
  • DropboxVorschau
  • Amazon S3Vorschau
  • Azure Blob StorageVorschau
  • DatensteineVorschau
  • PostgreSQLVorschau
  • MySQLVorschau
  • SQL-ServerVorschau
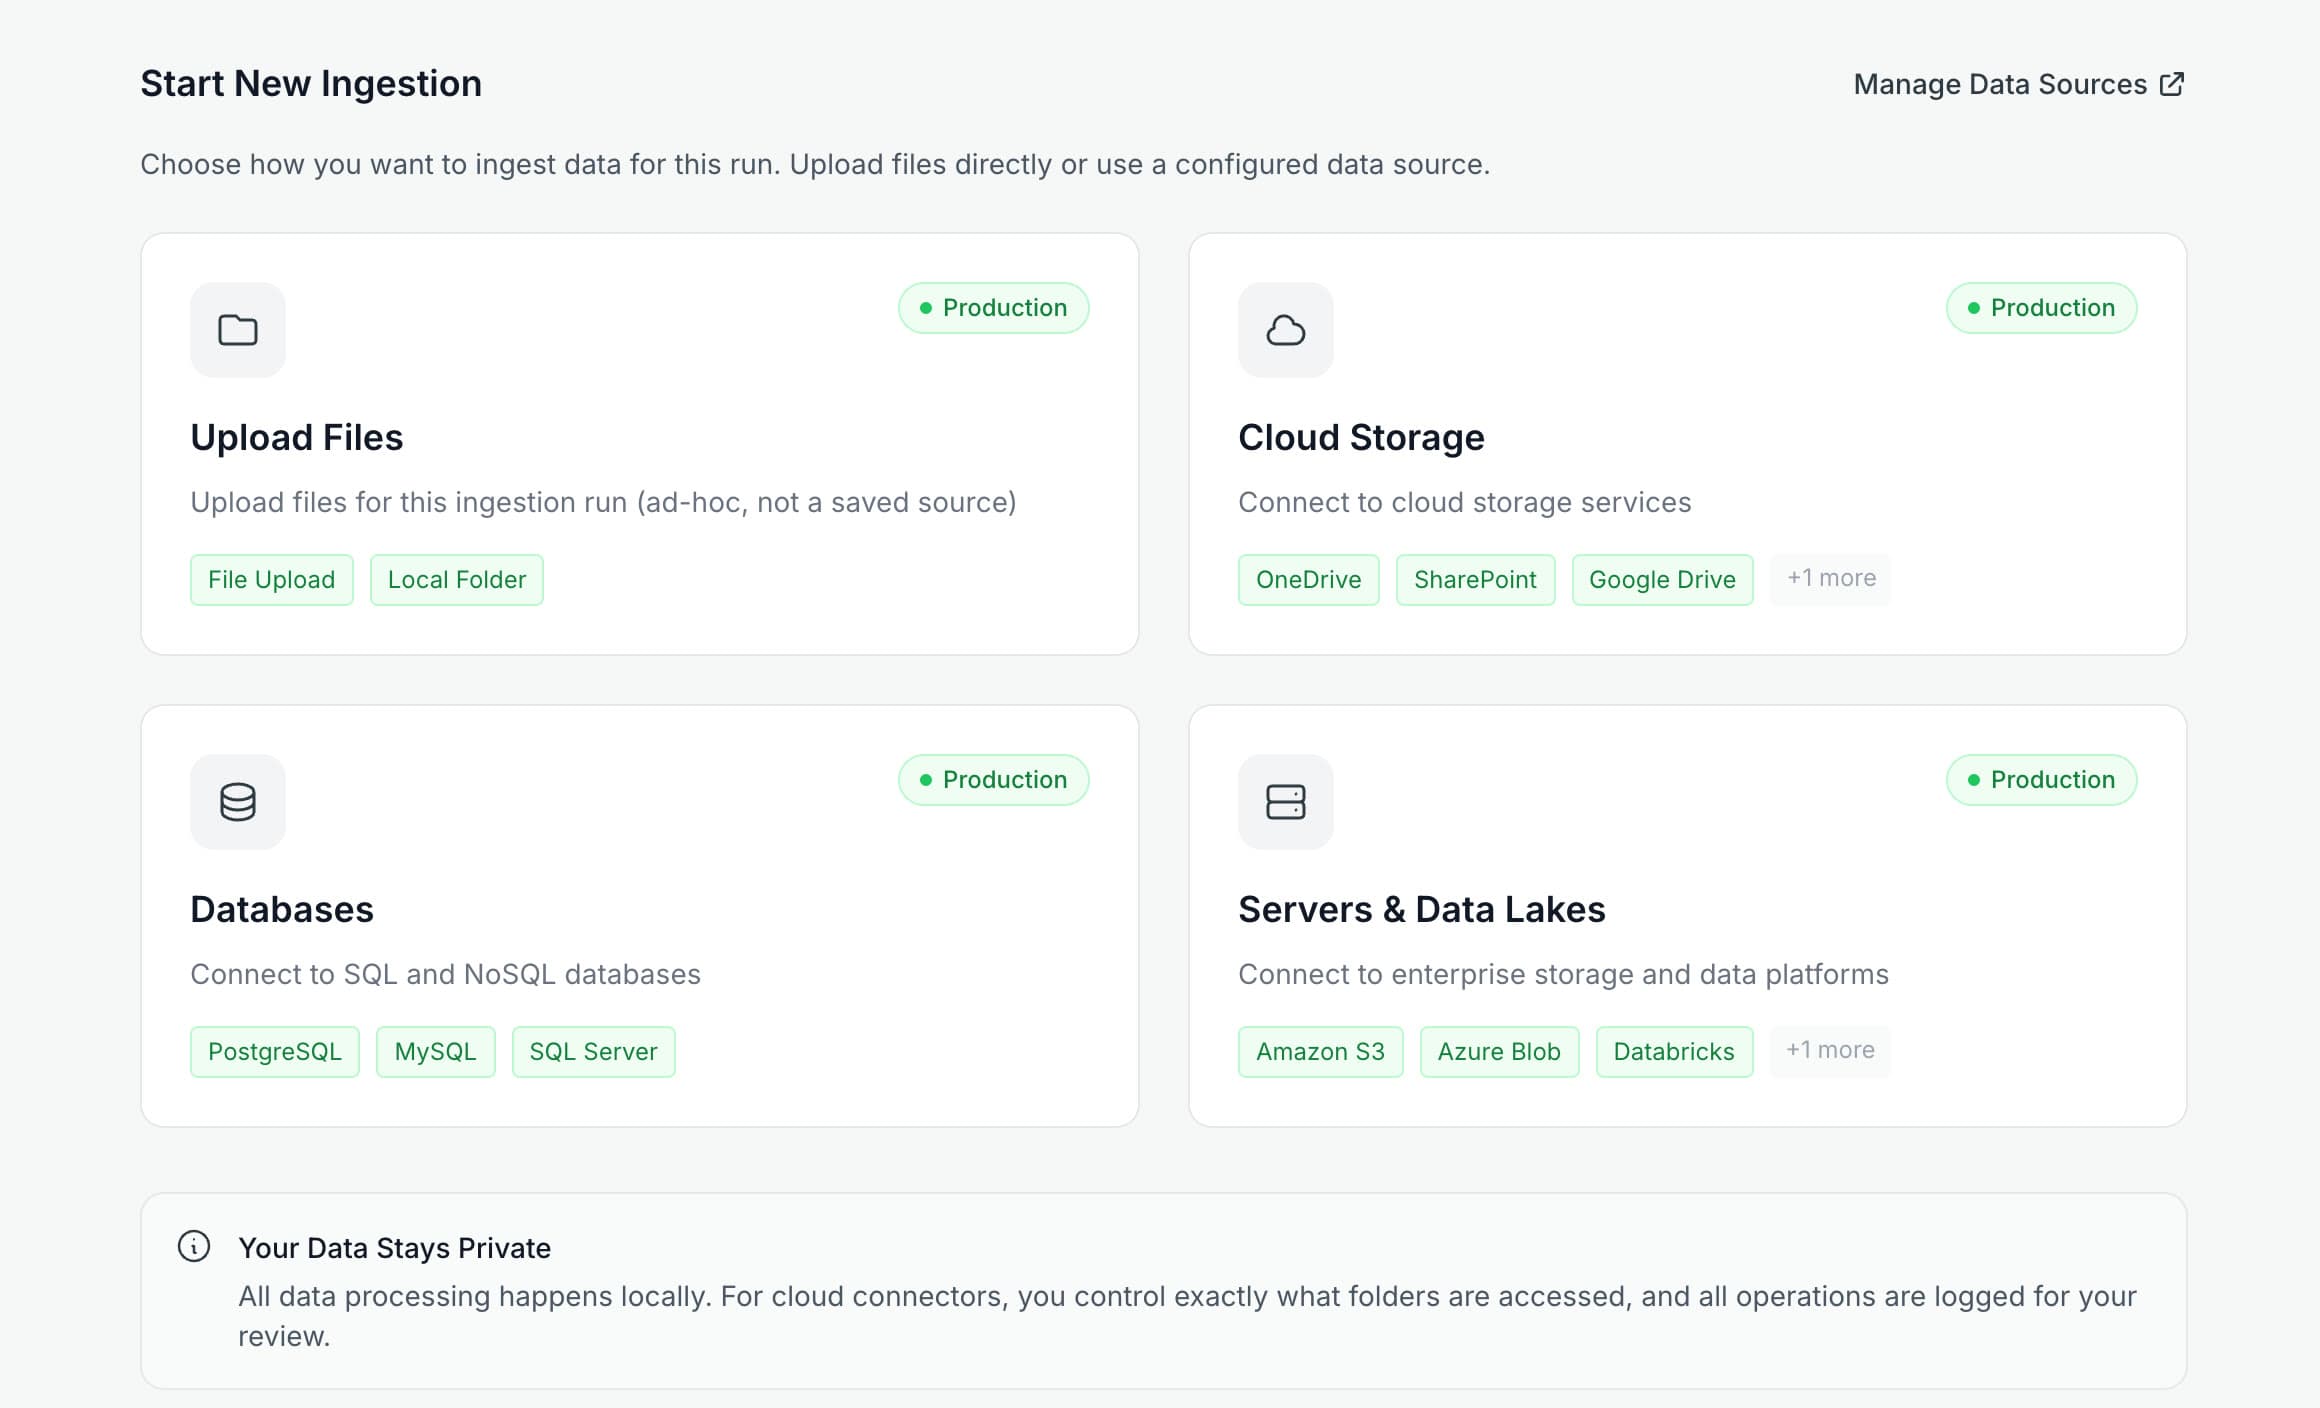
Daten hinzufügen: vier Connector-Familien im Produkt: Dateien hochladen, Cloud-Speicher (OneDrive, SharePoint, Google Drive), Datenbanken (PostgreSQL, MySQL, SQL Server) und Server und Data Lakes (Amazon S3, Azure Blob, Databricks), mit dem Hinweis, dass die gesamte Verarbeitung lokal erfolgt und protokolliert wird.

06 · Was es bauen kann

Was die Plattform erzeugen kann.

CRUD-Anwendungen

Strukturierte Betriebsschnittstellen für die erkannten Entitäten mit jeweils generierten API-Endpunkten.

Versand

Dashboards

KPI-Karten und Diagramme, die nur aus Metriken erstellt werden, die die Daten berechnen können; Nicht verfügbare Metriken werden markiert und niemals gefälscht.

Versand

Chat / RAG

Zugriff auf natürliche Sprache basierend auf dem organisatorischen Kontext. Laufzeitschlüssel verbleiben beim Kunden.

Versand

Berichte

Strukturierte Berichterstattung aus demselben Kontext, exportiert mit dem Anwendungspaket.

Versand

Vorhersage und Analyse

Datenorientierte Analysemodule, bei denen die zugrunde liegenden Daten sie unterstützen.

Roadmap

API, Automatisierung, Agent, Workflow

Deklarierte Modultypen warten auf Generatoren.

Roadmap
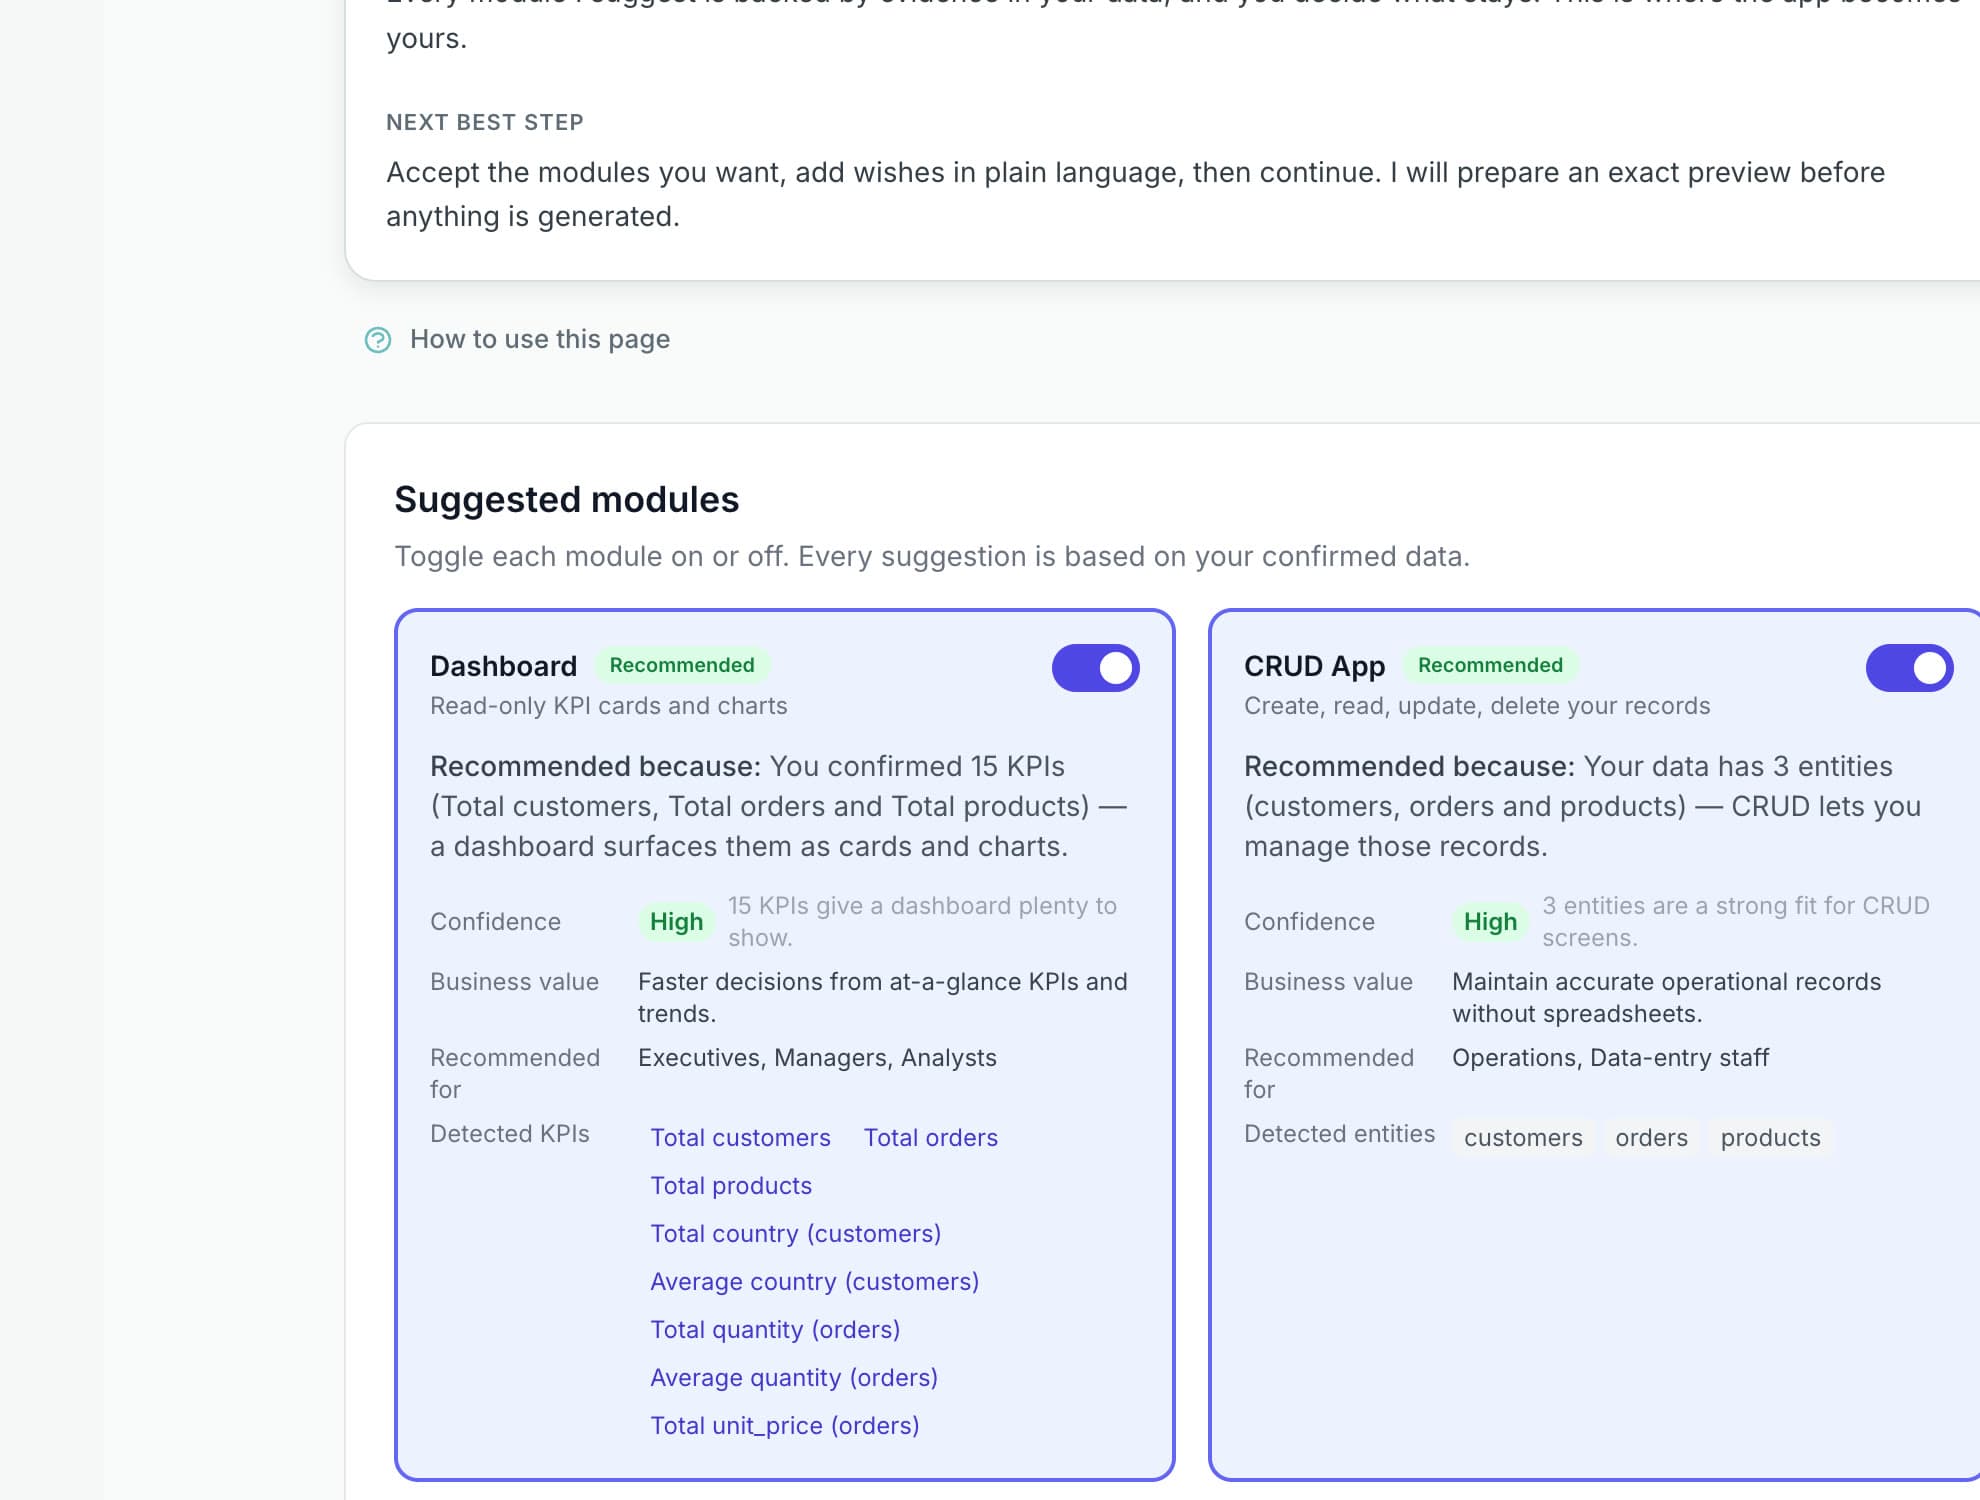
Vorgeschlagene Module im Entwurfsschritt: Empfohlenes Dashboard und CRUD-App mit den Beweisen hinter jeder Empfehlung, Vertrauen, Geschäftswert und erkannten KPIs oder Entitäten.
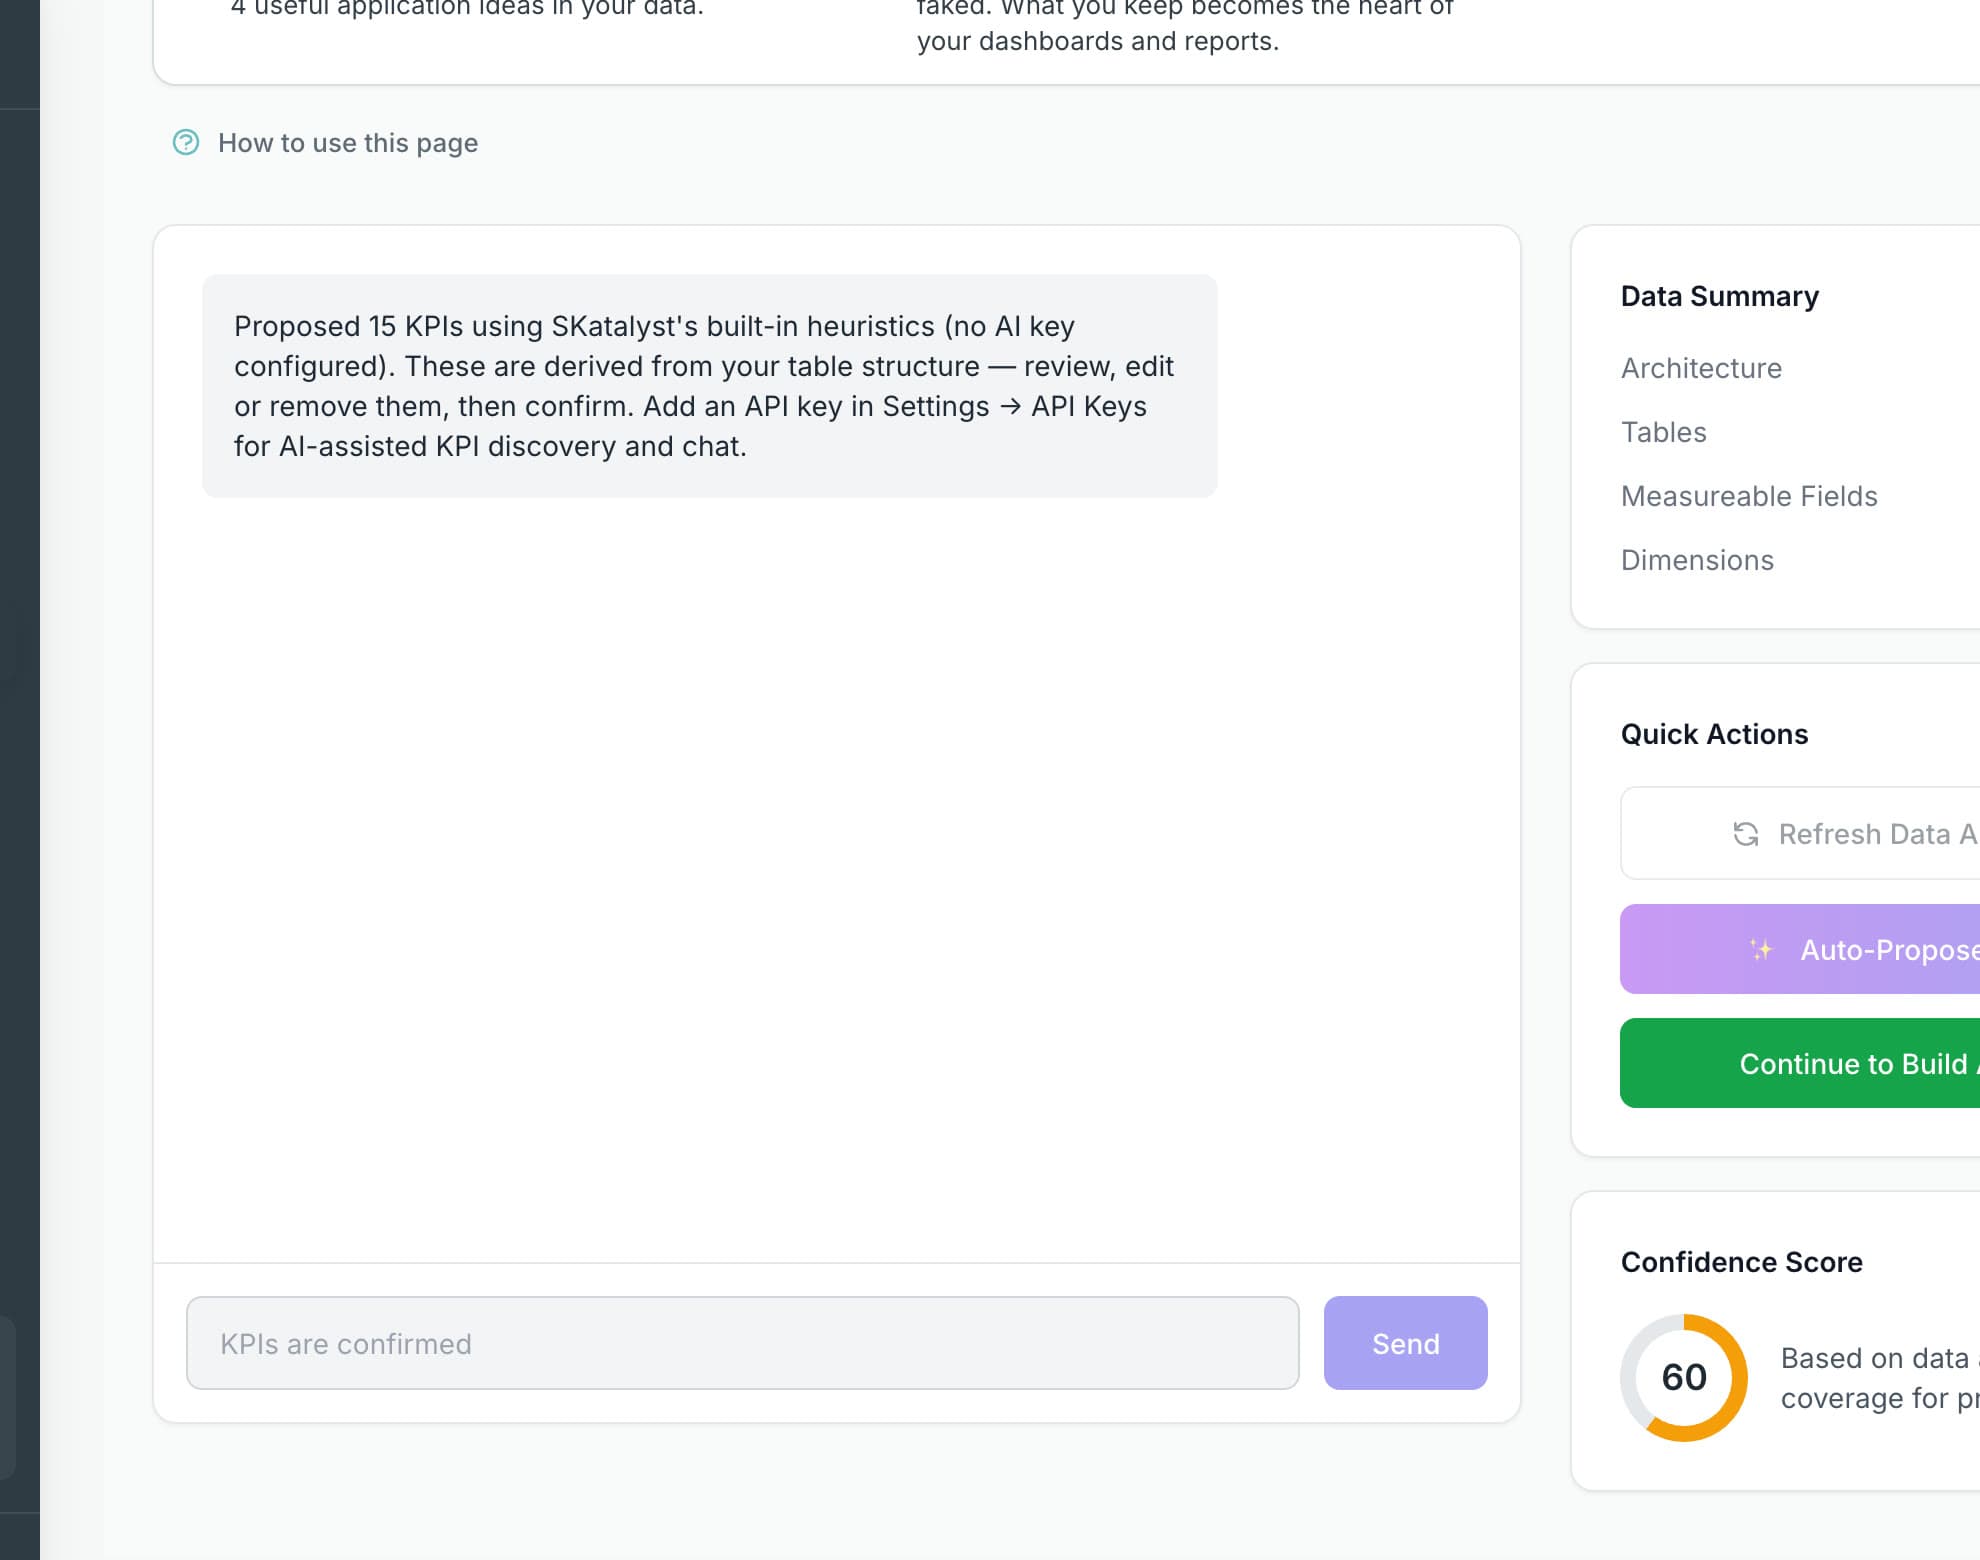
KPI-Erkennung: Der Assistent schlägt KPIs aus drei Tabellen und fünf messbaren Spalten mit einer Datenzusammenfassung und einem Konfidenzwert vor.

07 · Vertrauen und Bestätigung

Die erzeugten Ergebnisse prüfen.

Wenn KI Software aus Unternehmensdaten generieren soll, kann die Generierung nicht der letzte Schritt sein. SKatalyst behandelt die Validierung als Teil der Architektur: Erwartungen werden aus dem Datenverständnis zusammengestellt, niemals aus dem generierten Code, sodass ein Fehler eines Generators keine Garantie für sich selbst sein kann.

  1. Bauen
  2. Testen
  3. Vergleichen
  4. Erklären Sie
  5. Reparatur / Überprüfung

Stellen Sie die Erwartungen zusammen

TestOracleCompiler

Wandelt die bestätigten KPIs, Entitäten, Schemata und Geschäftskontexte in Verhaltensaussagen um. Rein und deterministisch: keine Datenbank, kein Netzwerk, kein Modell und niemals eine Zeile generierten Codes.

Berechnen Sie, wie die Antwort lauten sollte

ReferenceExecutor

Wertet jede Behauptung anhand des Beispiel-Snapshots zur Aufnahmezeit aus: Summen, Anzahlen, Durchschnittswerte, Mindest- und Höchstwerte. Schreibgeschützt; Öffnet niemals einen Live-Connector.

Trainieren Sie die generierte App

BehavioralProbeRunner

Startet die App in einer isolierten Laufzeit mit demselben Beispiel und prüft ihre Endpunkte, einschließlich negativer Tests, die abgelehnt werden müssen.

Vergleichen Sie mit der Toleranz

Comparator

Exakter oder relativer Vergleich der beobachteten Werte mit Referenzwerten, sodass eine Rundungsdifferenz kein Fehler ist und ein falscher KPI schon.

Erklären Sie das Ergebnis

ValidationReportService

Jede Aussage hat eine Herkunft: welcher KPI, welche Tabelle, welche Formel. Der Bericht ist der Beweis, dem ein Mensch zustimmt.

Sicher orchestrieren und abbauen

ValidationOrchestrator

Führt Kompilieren, Referenzieren, Prüfen und Beibehalten aus; greift auf einen reinen Referenzbericht zurück, wenn die Laufzeit nicht verfügbar ist; reißt immer die Laufzeit runter.

5 BehauptungstypenKPI-Wert · Entitäts-CRUD · Beziehungsintegrität · Schemaform · Domänenbereich
Negative TestsEin verwaister Fremdschlüssel oder ein domänenverletzender Schreibvorgang muss von der generierten App abgelehnt werden.
Anomalien vor der GenerationDie Referenzausführung dient gleichzeitig als Überprüfung des Verständnisses selbst: Eine gebrochene Erwartung taucht auf, bevor Code existiert.
Reparatur bleibt menschlichBounded Auto-Repair ist konzipiert, aber bewusst nicht gebaut. Fehler gehen an die Person zurück, die über die Beweise verfügt, und der Export bleibt blockiert, solange die Validierung fehlschlägt.
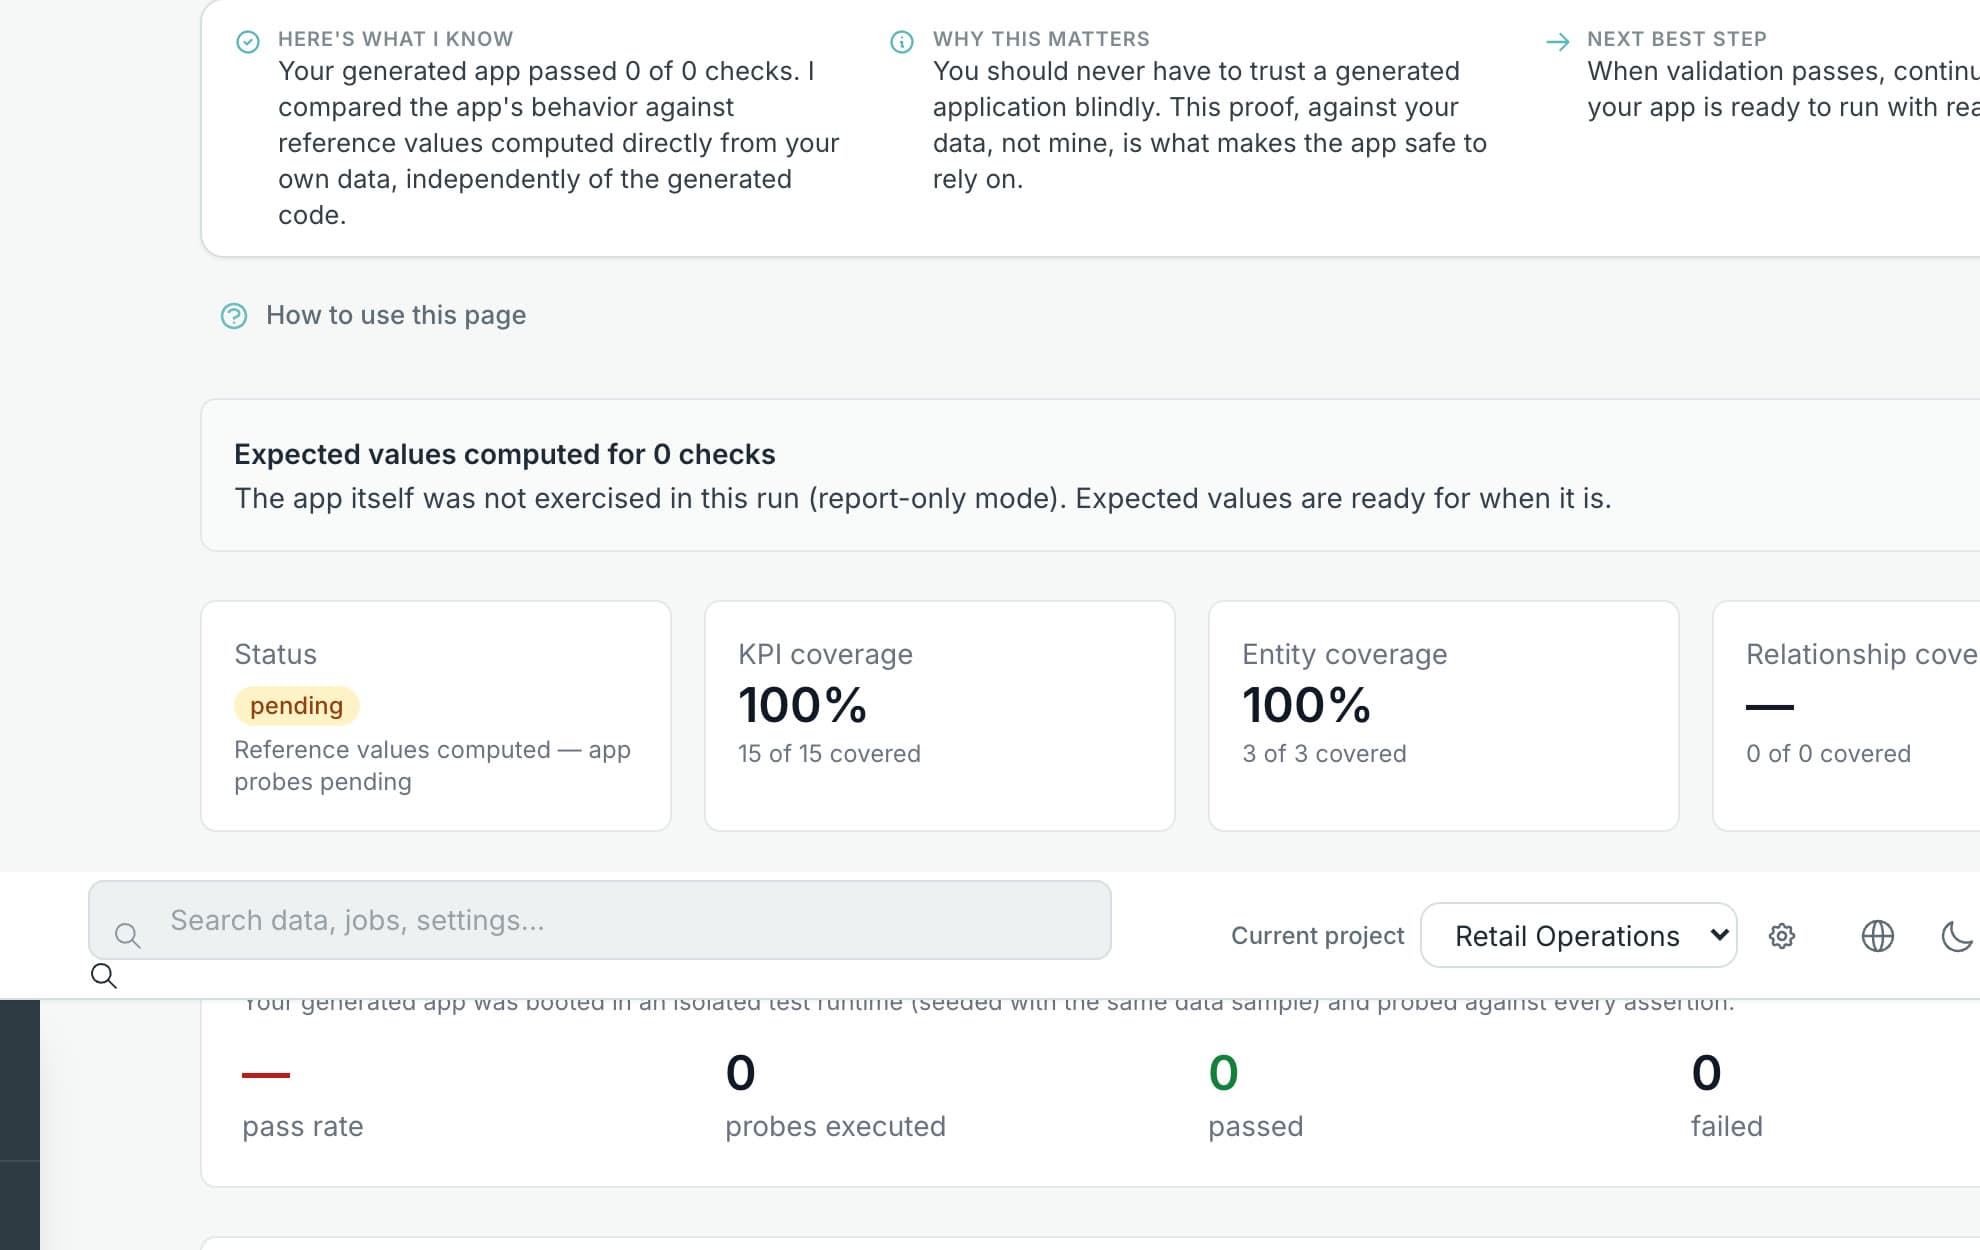
Validierungsbericht: Testorakel, zusammengestellt aus dem Datenverständnis, 100 % KPI-Abdeckung (15 von 15), 100 % Entitätsabdeckung (3 von 3), Verhaltensvalidierungspanel.
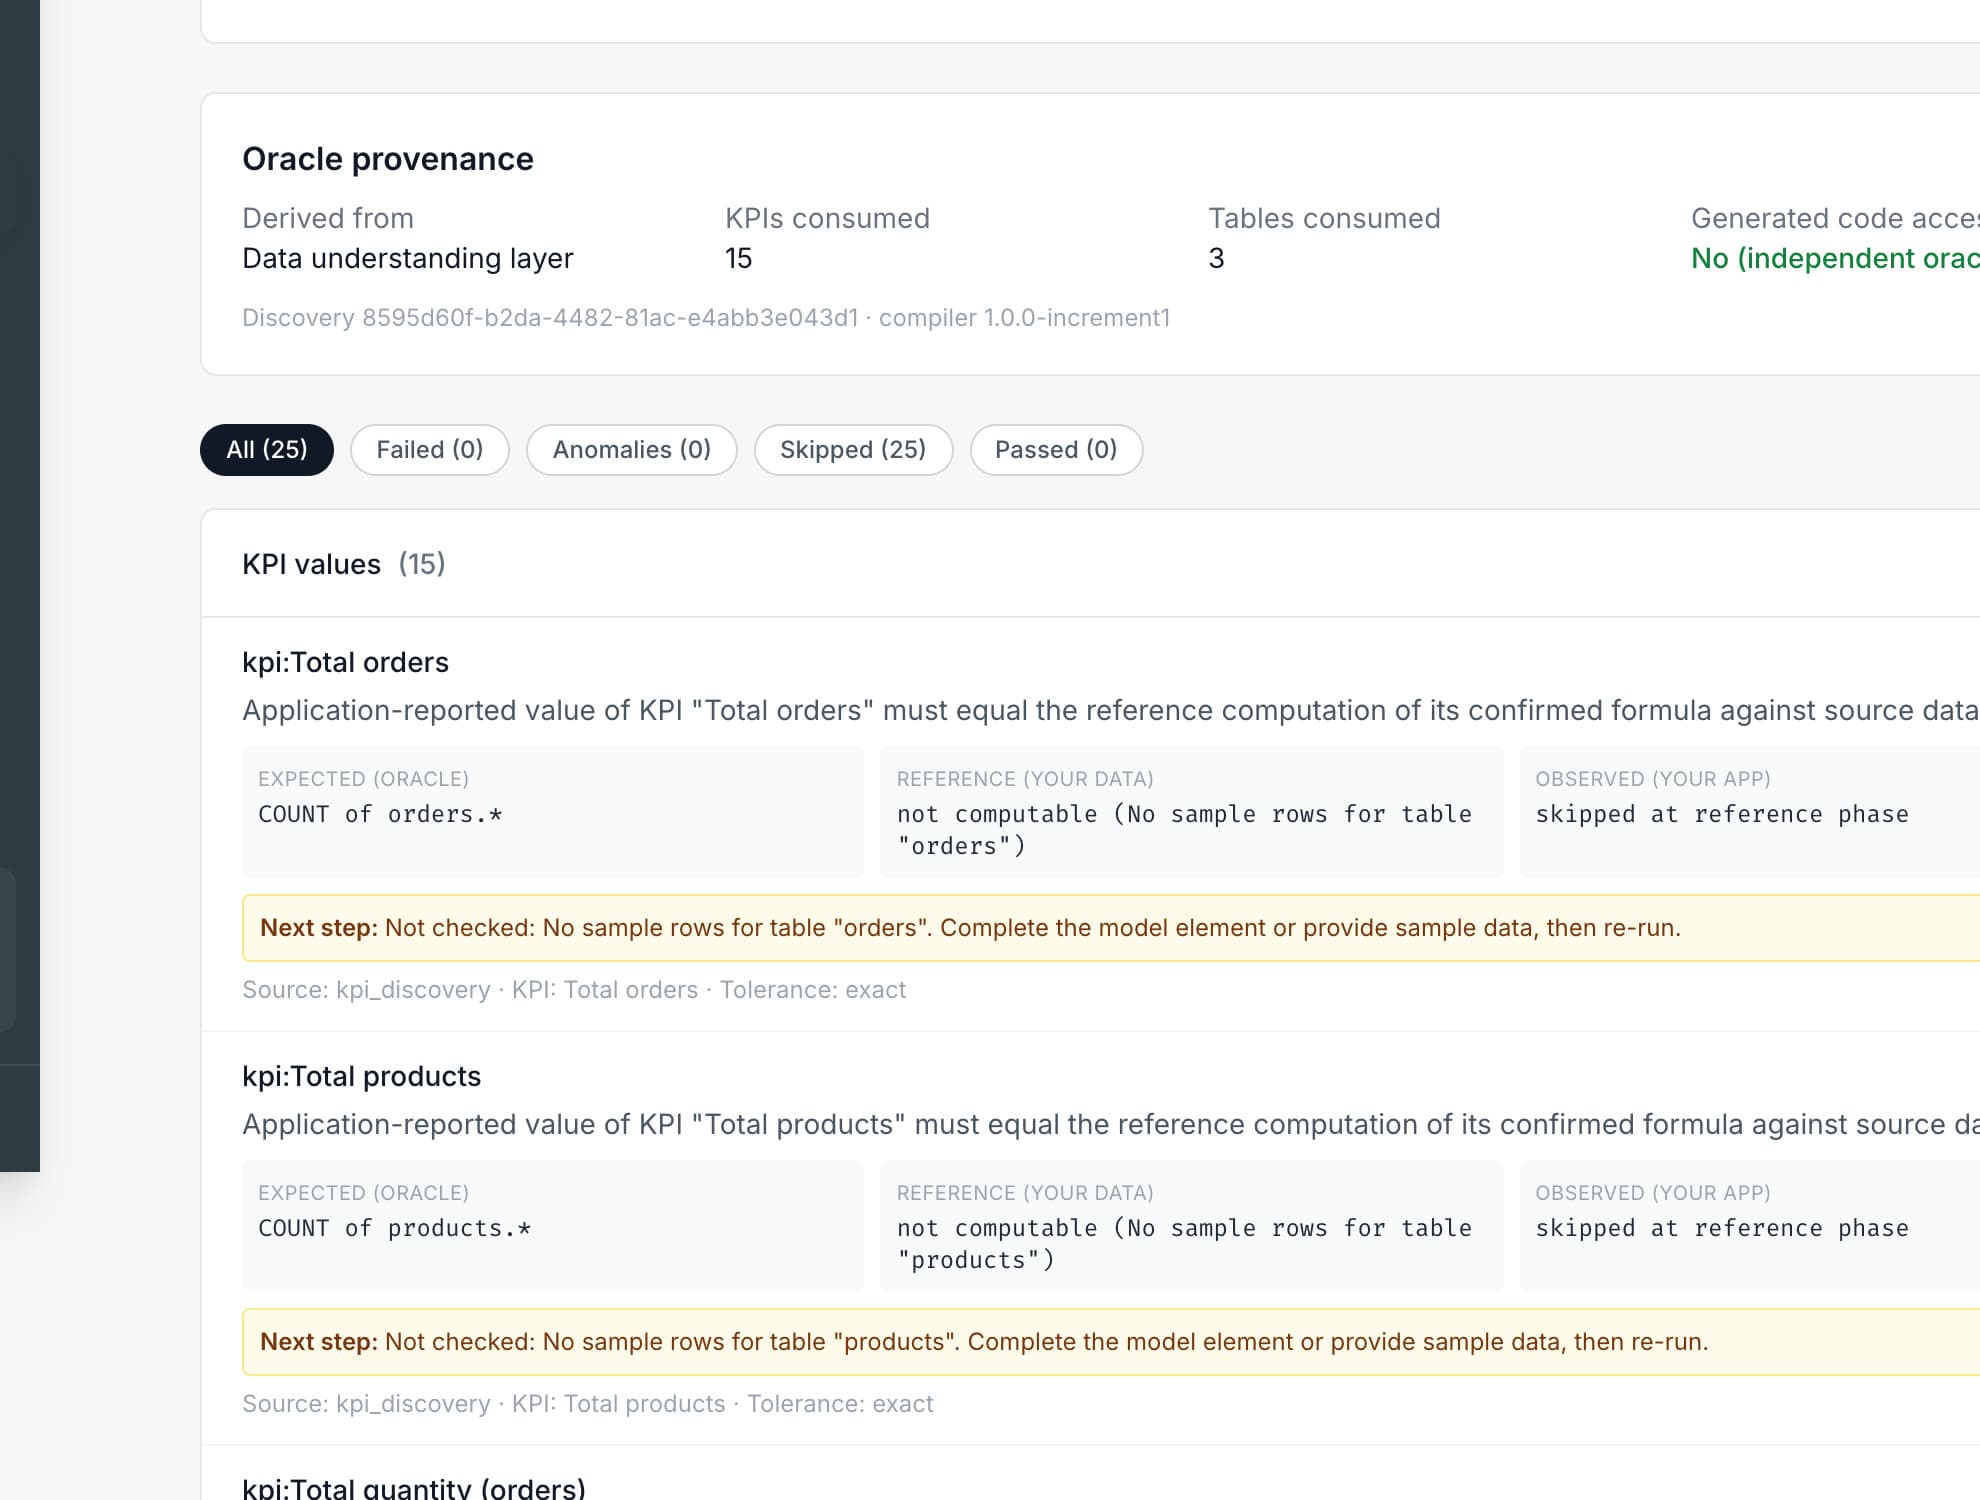
Details zum Validierungsbericht: Oracle-Herkunft mit 15 verbrauchten KPIs und 3 Tabellen und generiertem Code, auf den zugegriffen wurde: Nein, gefolgt von den kompilierten KPI-Wert-Behauptungen mit ihren erwarteten Formeln.

Menschliche Zustimmung

Wo Menschen prüfen und freigeben.

Das System schlägt vor; Eine Person entscheidet in den entscheidenden Momenten. Zwei Gates unterscheiden sich konstruktionsbedingt: die Genehmigung einer Spezifikation, bevor etwas erstellt wird, und das Akzeptieren einer Vorschau nach der Erstellung.

  • Bestandsgenehmigung bevor ein Strukturierungsplan erstellt wird.
  • Plan- und Architekturbestätigung bevor KPIs entdeckt werden.
  • Designgenehmigung bevor ein Build beginnt.
  • Vorschau der Annahme, Überarbeitung oder Ablehnung nach dem Build, mit einer Revisionsschleife zurück zum Design.
  • Validierungsbericht als Beweis für diese Entscheidung; Export blockiert, obwohl er fehlschlägt.
  • Audit-Trail: Jeder Übergang schreibt ein Ereignis und eine Nur-Anhänge-Überwachungszeile in derselben Transaktion, oder der Übergang wird zurückgesetzt.
  1. AI schlägt vor
  2. Menschliche Bewertungen
  3. Systemaufbauten
  4. System validiert
  5. Der Mensch akzeptiert

Lösungslebenszyklus · 12 Zustände

  1. Entwurf
  2. entwerfen
  3. warten auf Genehmigung
  4. genehmigt
  5. Gebäude
  6. Vorschau
  7. akzeptiert
  8. Überarbeitung beantragt
  9. abgelehnt
  10. eingesetzt
  11. Betrieb
  12. archiviert

Hervorgehobene Zustände sind die menschlichen Tore. Übergänge sind eine explizite Tabelle; Unzulässige werden abgelehnt, wiederholte sind idempotent und durch das Aufheben der Archivierung wird eine Laufzeit niemals neu gestartet.

08 · Produkterlebnis

Die Schritte eines Laufs.

Der In-App-Stepper verfolgt acht Schritte auf jeder Laufseite. Jeder Schritt erklärt mit der eigenen Stimme des Produkts, was das System weiß, warum es wichtig ist und welche nächstbeste Aktion es gibt.

  1. 01Verbinden
  2. 02Kontext
  3. 03Verstehe
  4. 04Empfehlen
  5. 05Design
  6. 06Bauen
  7. 07Validieren
  8. 08Bereitstellen
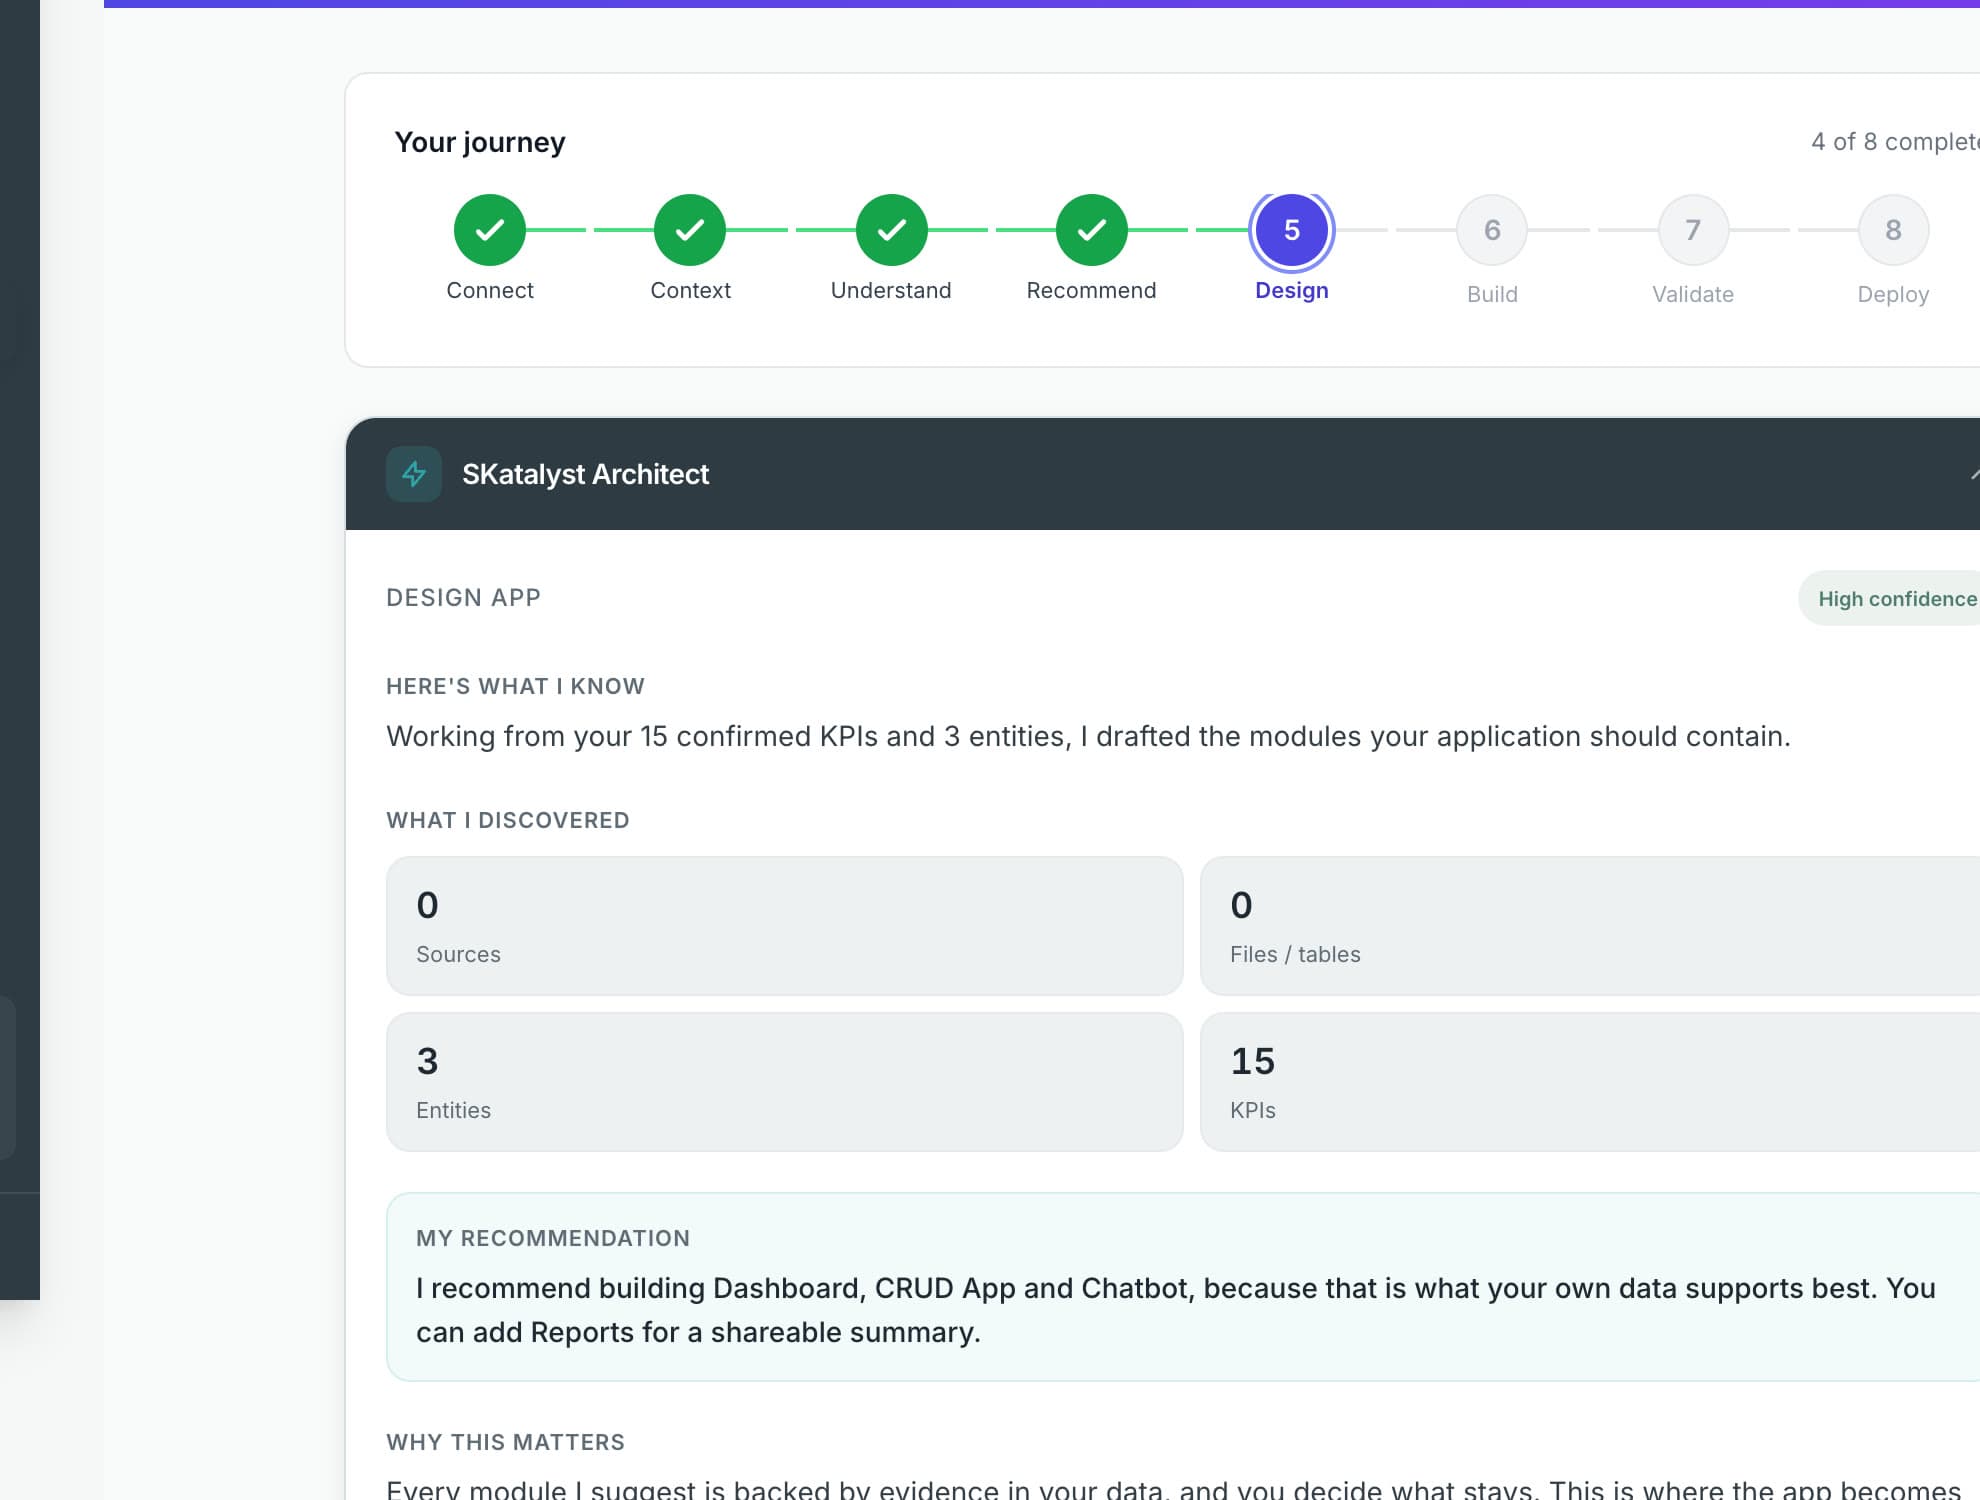
Design-Schritt mit dem achtstufigen Journey-Stepper oben und dem SKatalyst Architect-Panel: Was ich entdeckt habe, meine Empfehlung, warum das wichtig ist.
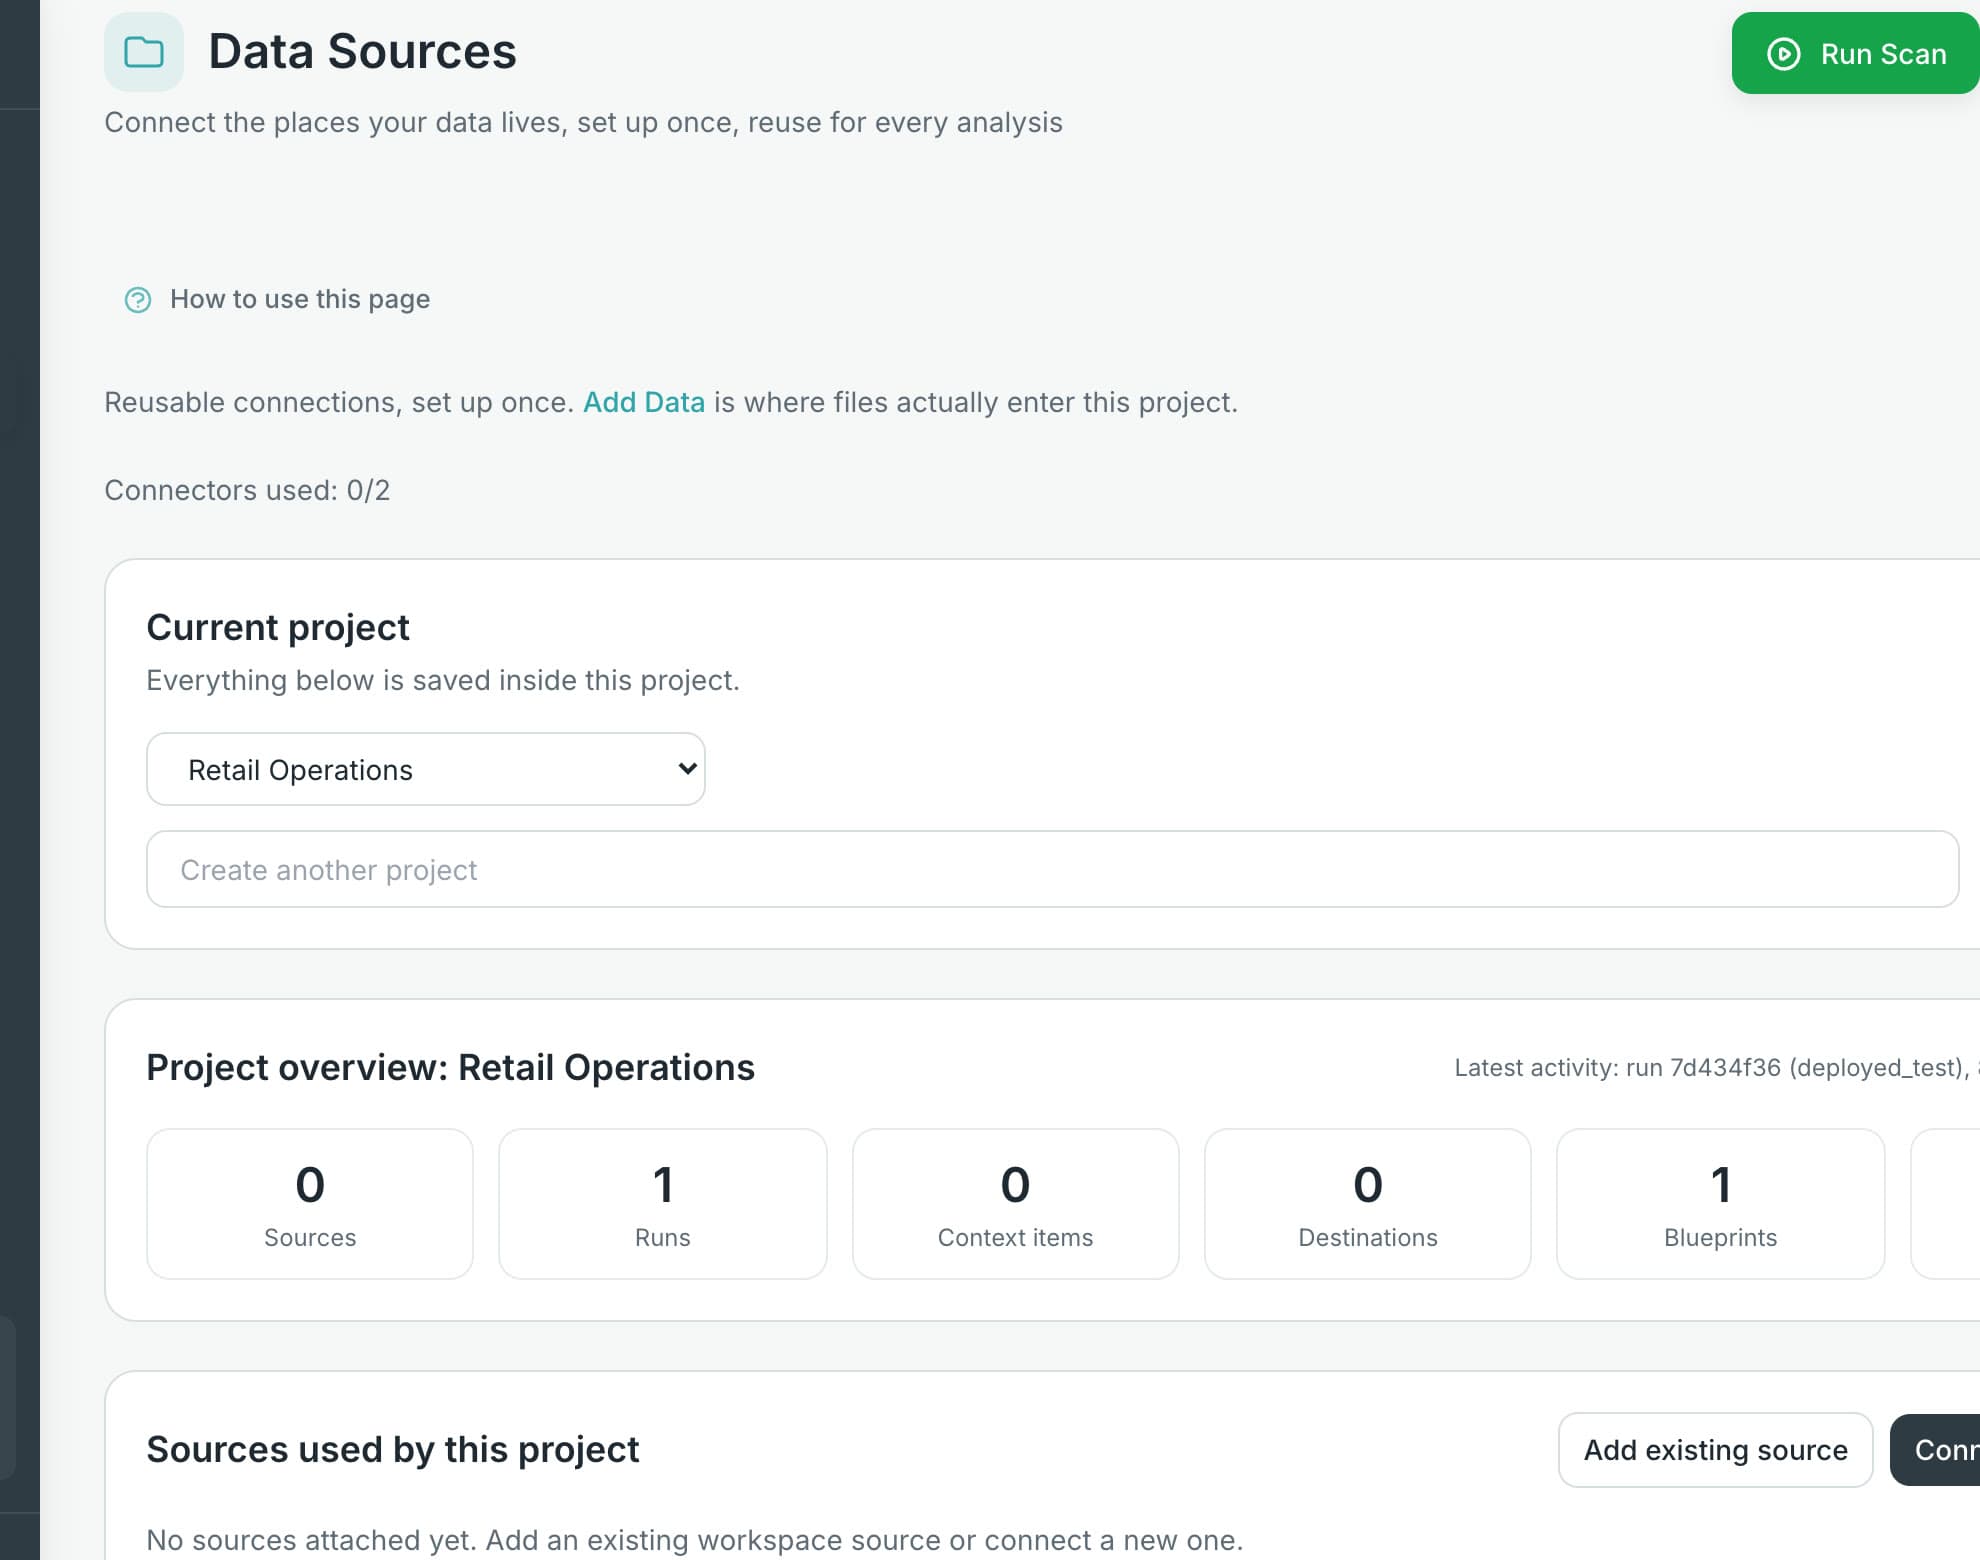
Seite „Datenquellen“: aktuelle Projektauswahl, Projektübersichtsanzahl für Quellen, Läufe, Kontextelemente, Ziele, Blaupausen und Metriken.
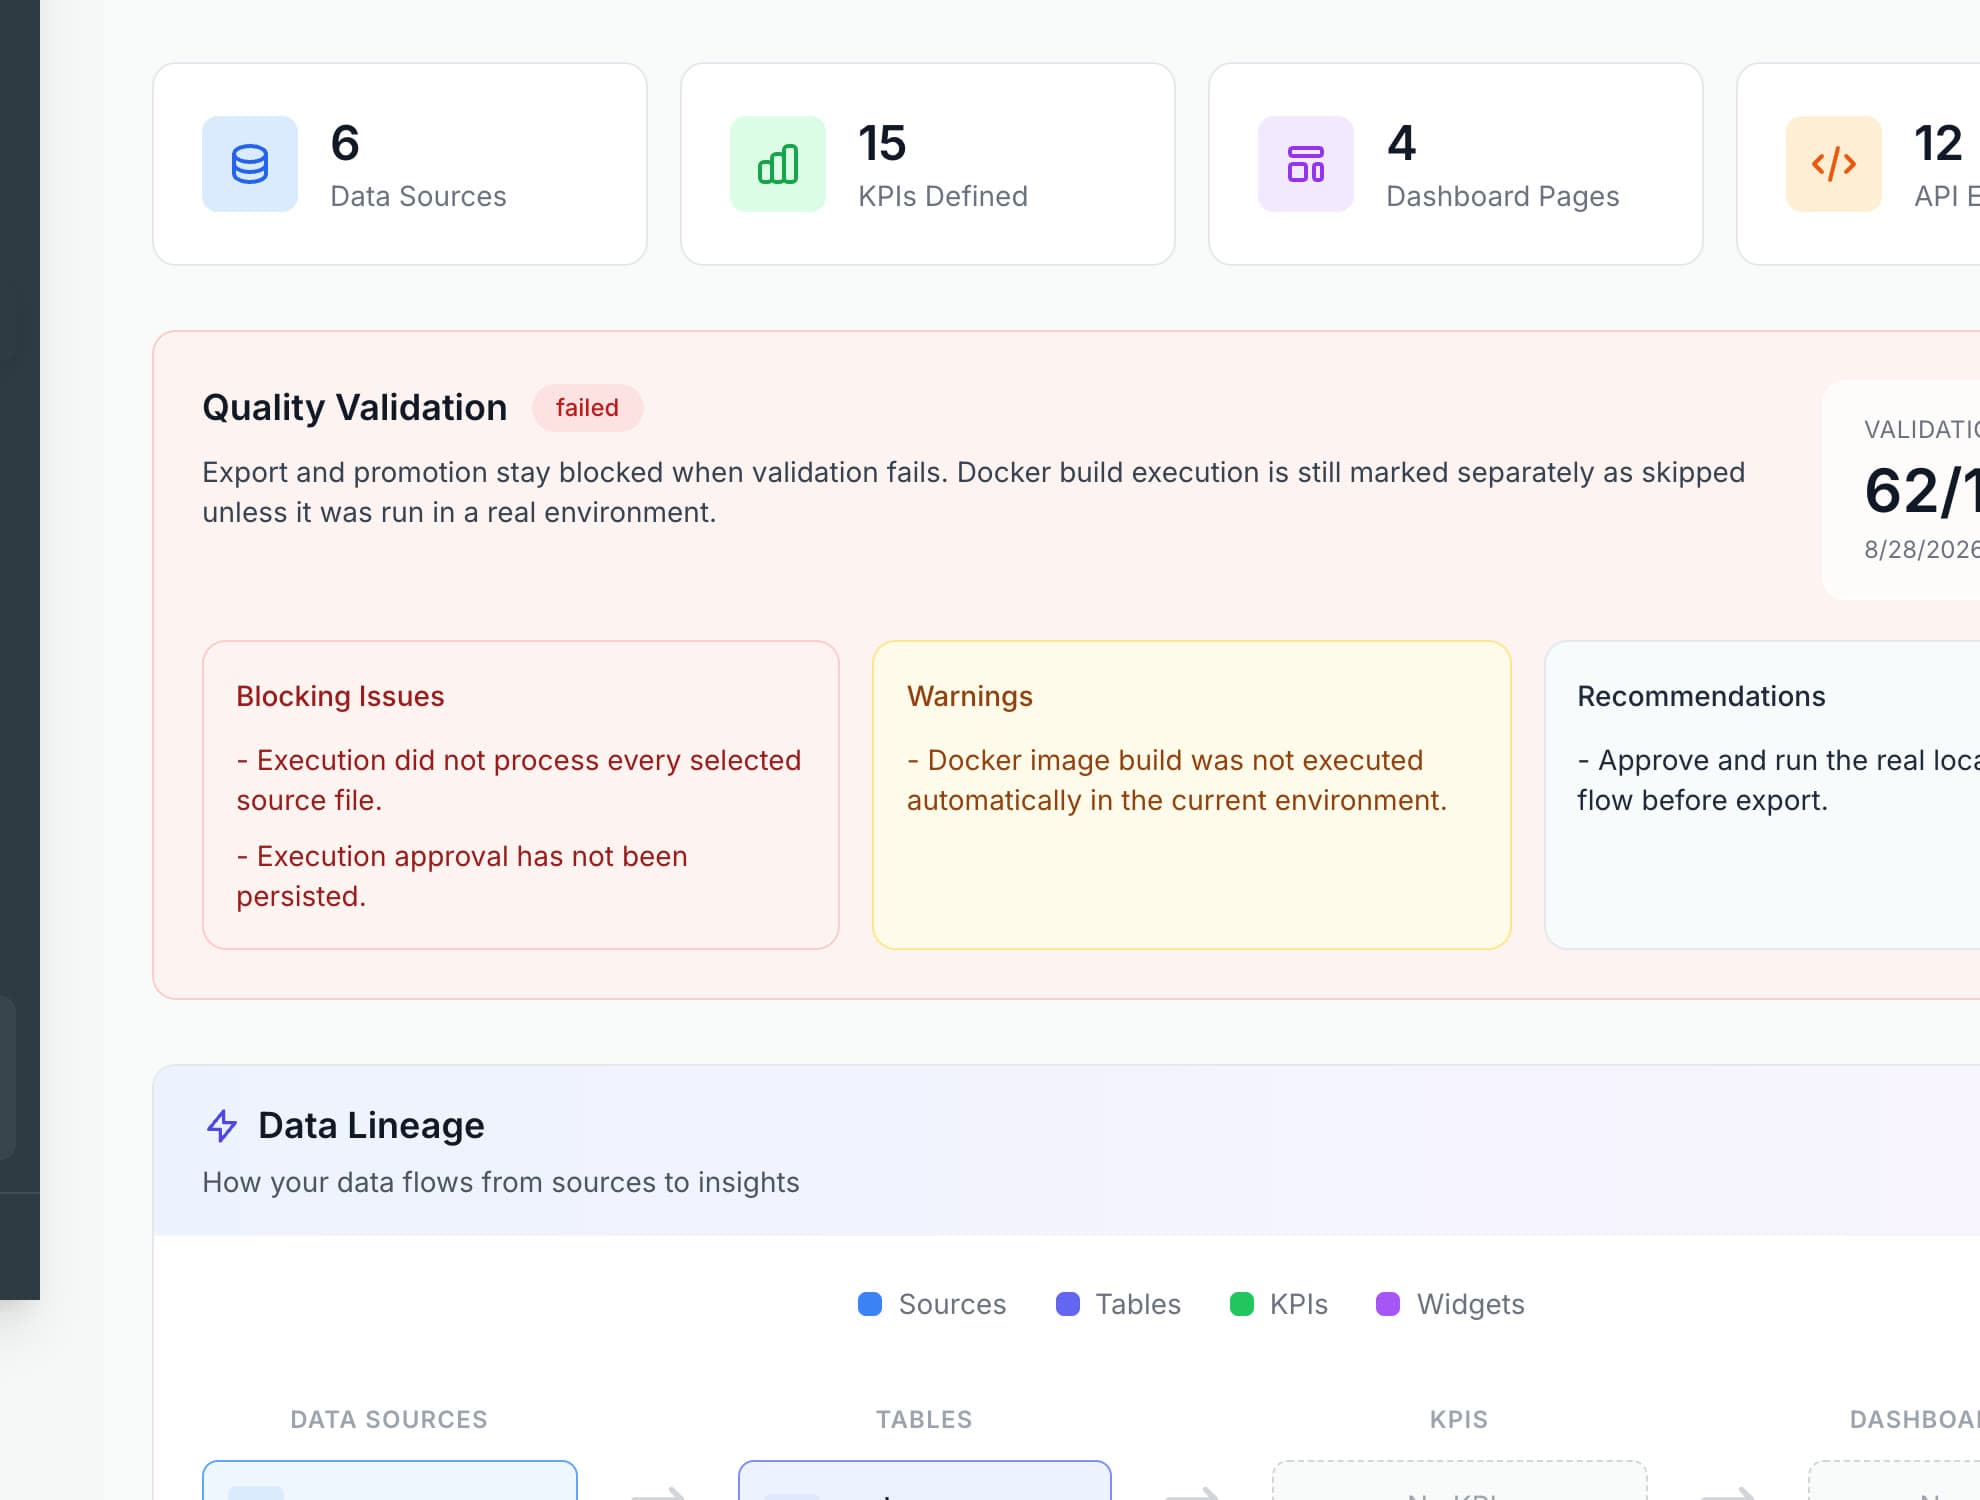
Build-Zusammenfassung: 6 Datenquellen, 15 KPIs, 4 Dashboard-Seiten, 12 API-Endpunkte und ein Qualitätsvalidierungspanel, das den Export blockiert, während die Validierung fehlschlägt, und Blockierungsprobleme, Warnungen und Empfehlungen auflistet.
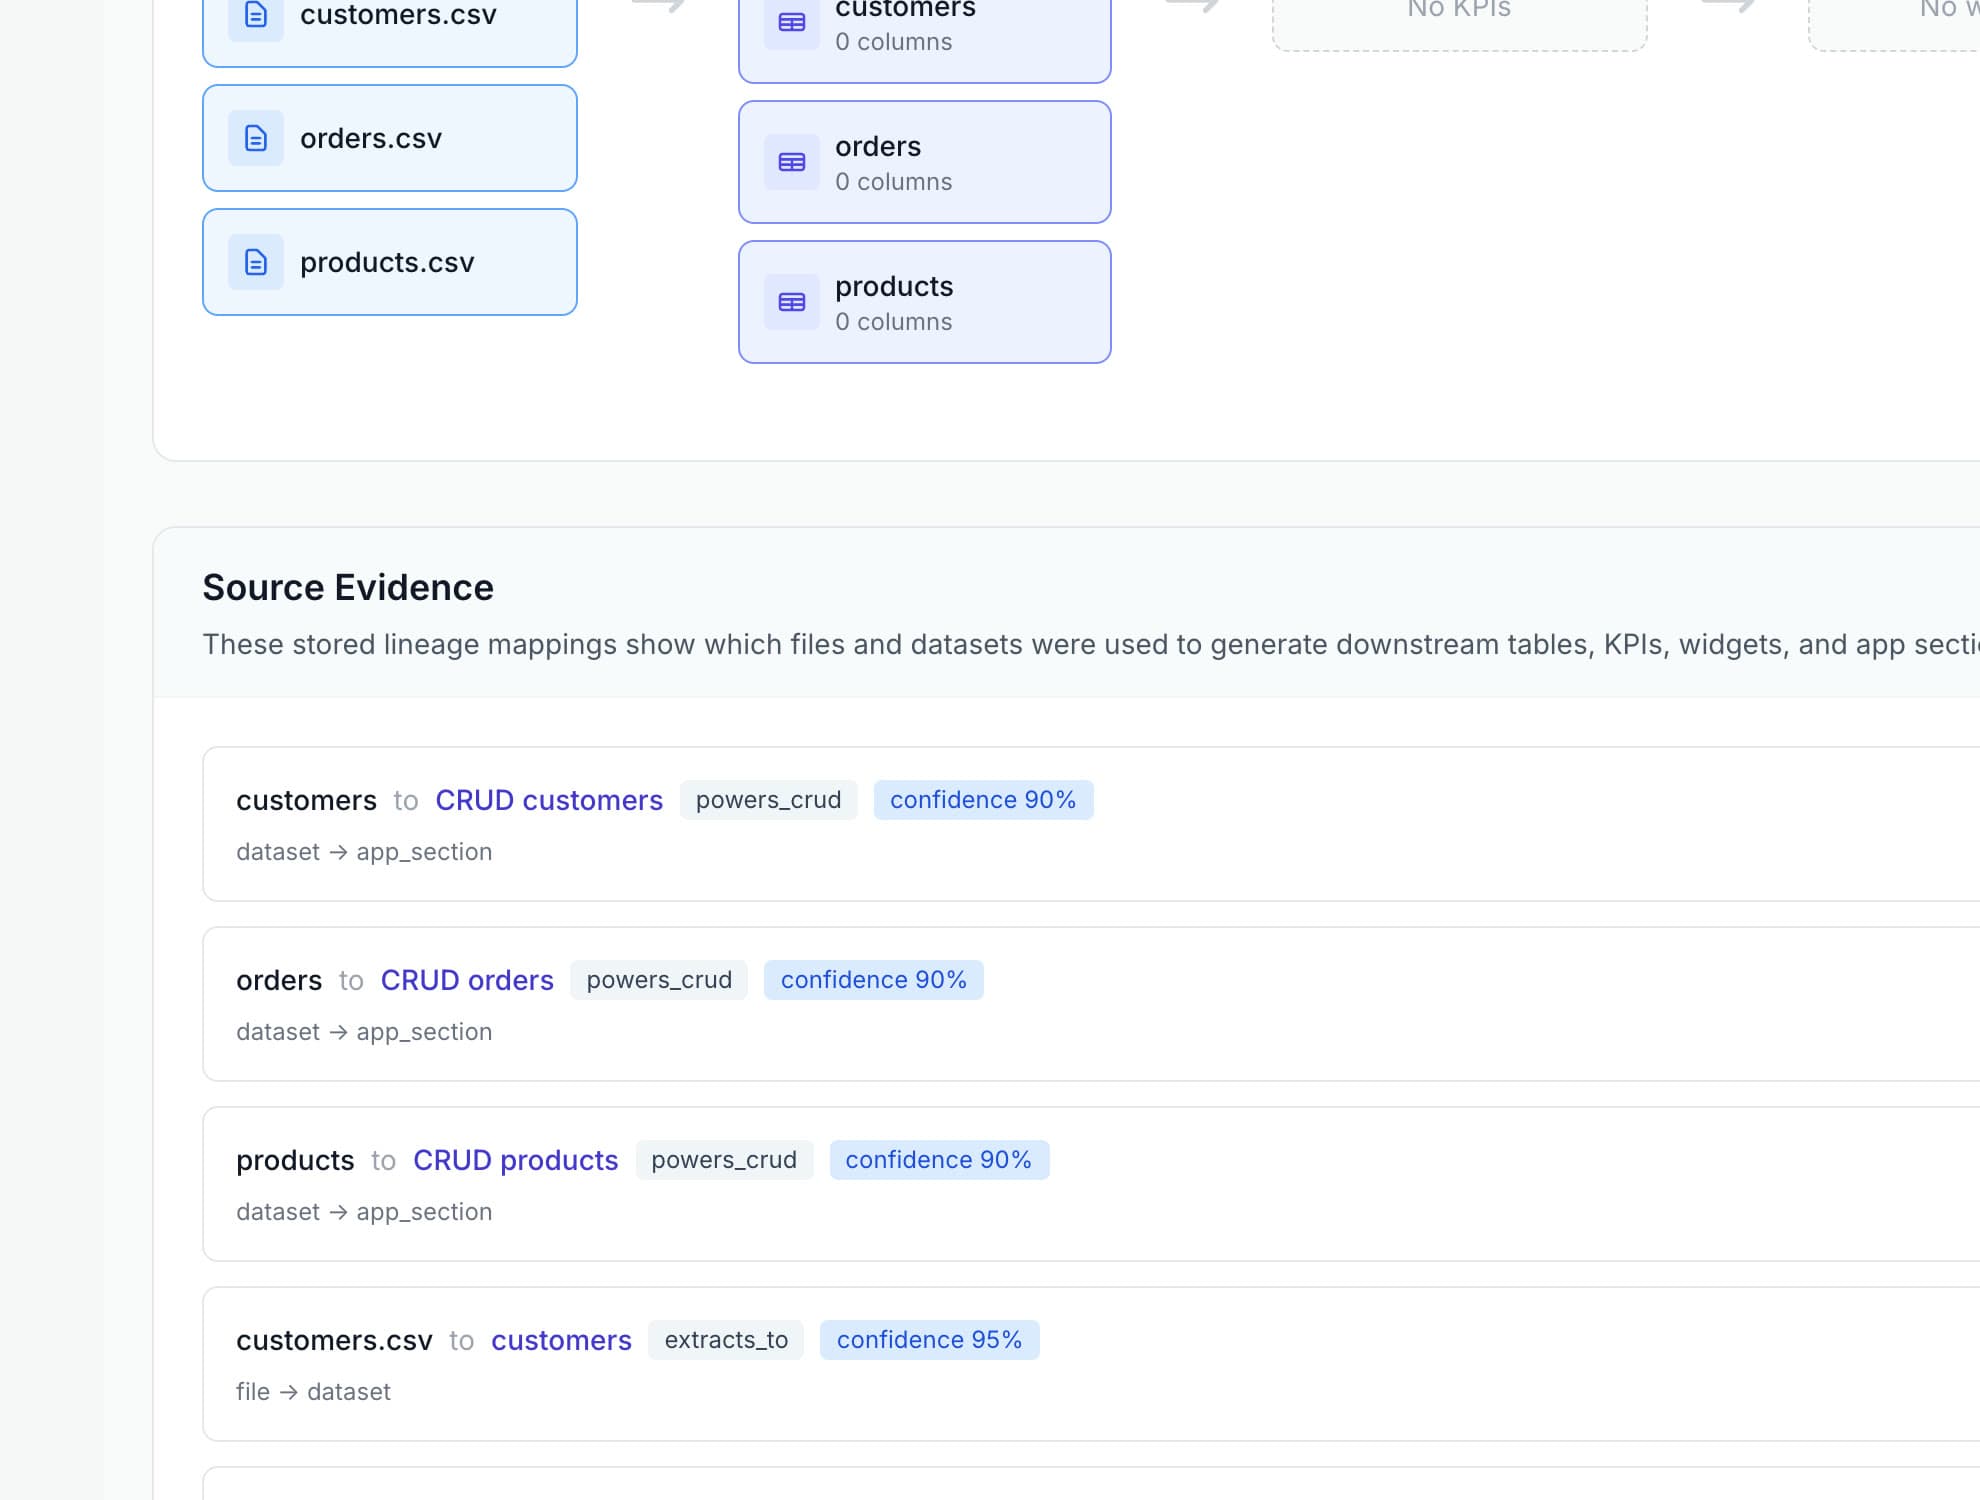
Datenherkunft und Quellennachweis: Gespeicherte Zuordnungen, die zuverlässig zeigen, welche Dateien und Datensätze jede generierte Tabelle, jeden KPI und jedes Widget unterstützt haben.
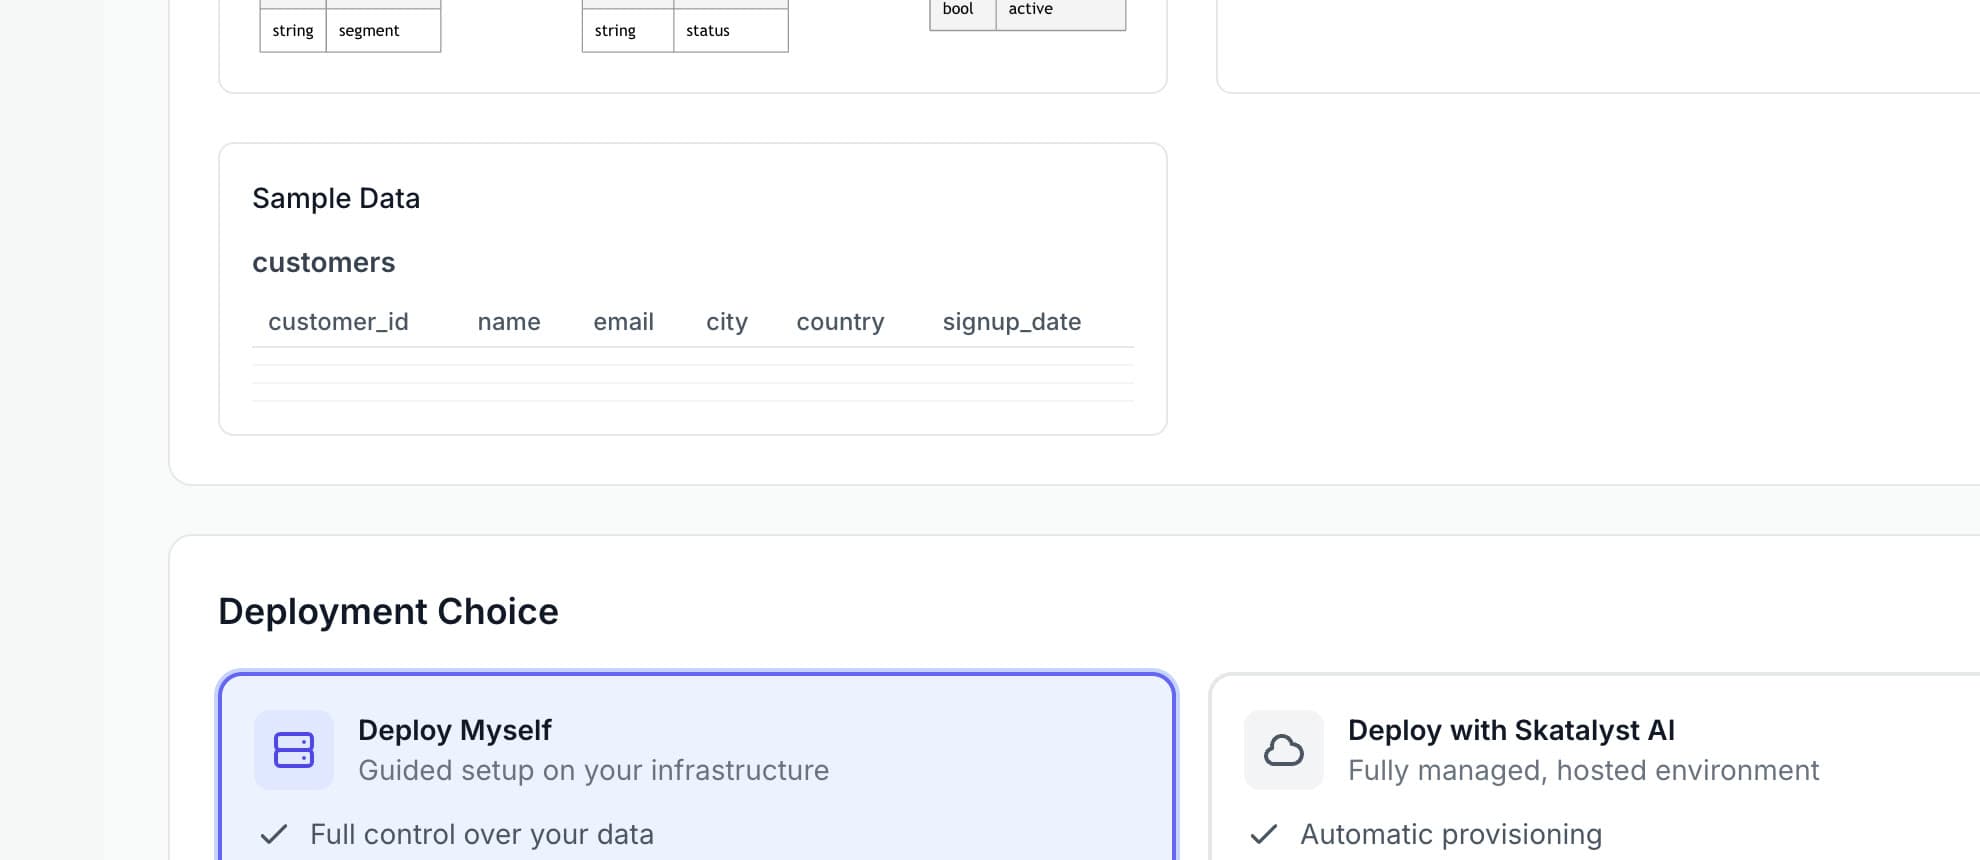
Bereitstellungsauswahl: Bereitstellung selbst mit vollständiger Kontrolle, herunterladbaren Schemata und Schritt-für-Schritt-Anleitungen oder Bereitstellung mit SKatalyst AI verwaltetem Hosting.
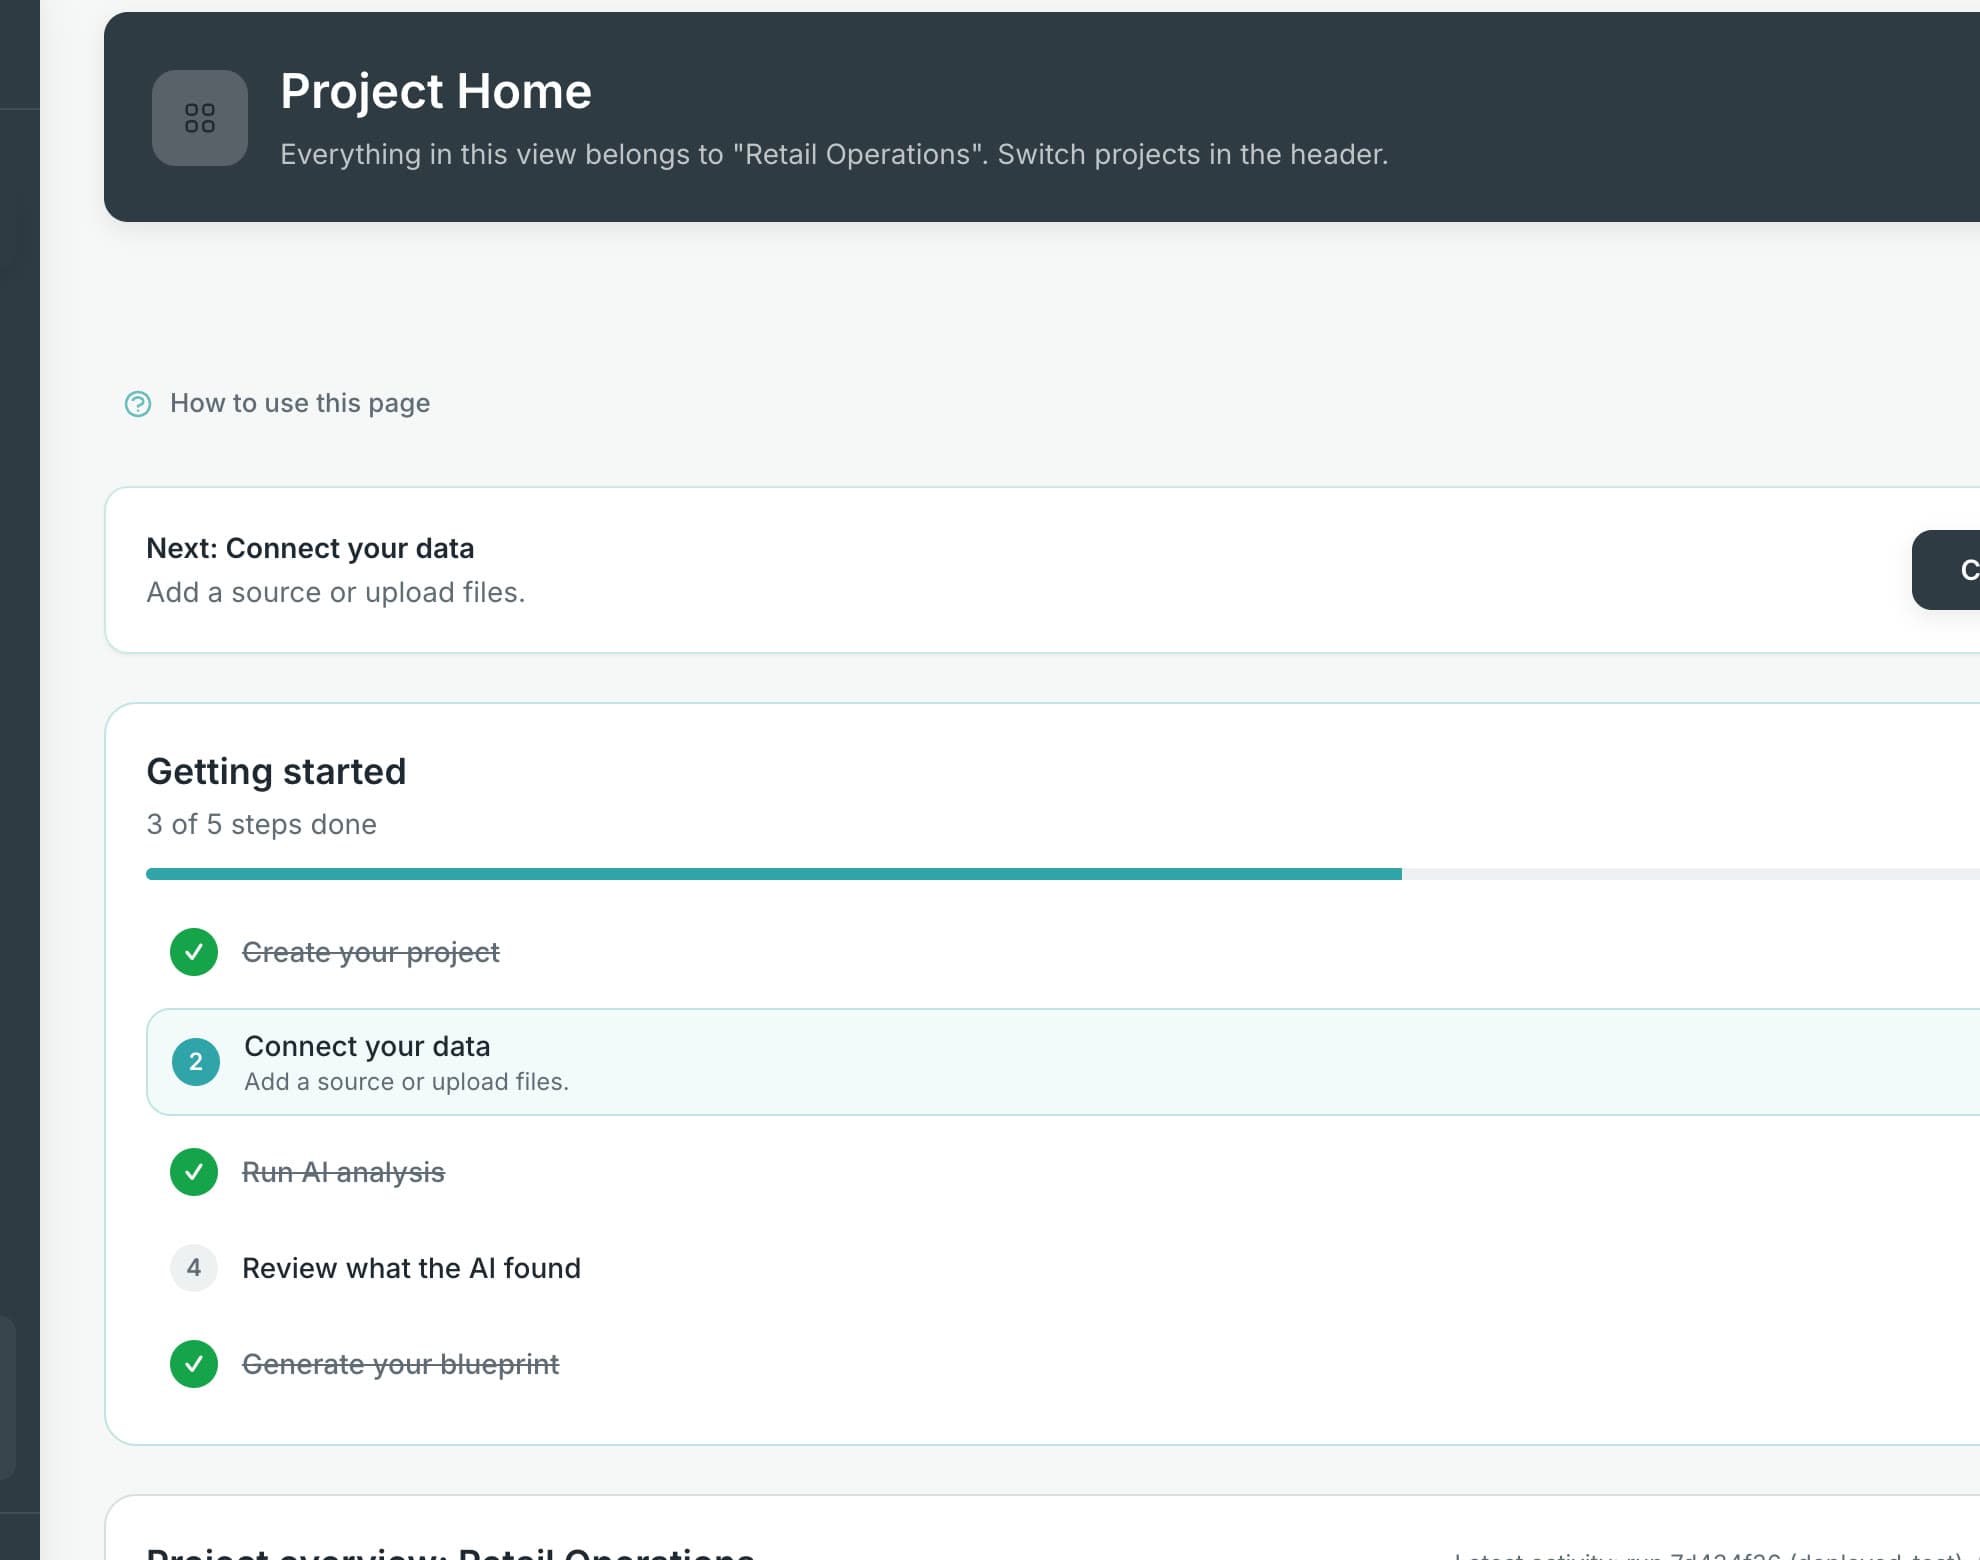
Project Home mit einer Checkliste für den Einstieg: Erstellen Sie Ihr Projekt, verbinden Sie Ihre Daten, führen Sie eine KI-Analyse durch, überprüfen Sie, was die KI gefunden hat, erstellen Sie Ihren Entwurf.

09 · Ingenieurwesen

Unter der Haube

Aus dem Repository überprüft, nach Zweck geordnet. Die Plattform ist ein Node- und PostgreSQL-System mit einer kleinen, expliziten KI-Oberfläche.

Frontend

  • Reaktion 18
  • React Router 6
  • Tailwind CSS
  • i18next
  • React-Dropzone
  • Meerjungfrau-Diagramme
  • Jest + Testing Library (45 Suiten)

Backend

  • Node.js (ESM)
  • Express 4 mit Helm, Geschwindigkeitsbegrenzung, CORS
  • Knex-Abfrage-Builder + Seite
  • Zod-Validierung
  • BullMQ + Redis Jobwarteschlange
  • Multer, PDF-Parse, Mammoth, XLSX, Sharp, ffmpeg

Daten

  • PostgreSQL 16
  • 51 additive Migrationen, etwa 80 Tabellen
  • Durch Trigger erzwungenes Audit-Protokoll, das nur zum Anhängen bestimmt ist
  • Kontext-Snapshots mit SHA-256-Integrität
  • Abstammungszuordnungen und Laufergebnisse

Wolke

  • Google Cloud Run (Europa-West1)
  • Cloud Build mit Git-SHA-Images
  • Firebase Hosting für die App
  • Cloud SQL für PostgreSQL
  • Docker-Export für Selbsthosting durch Kunden

Authentifizierung

  • Google, Microsoft und GitHub OAuth
  • JWT-Zugriff und Aktualisierungssitzungen
  • Verknüpfung mit einem verifizierten E-Mail-Konto
  • 4 Rollen: Eigentümer, Administrator, Mitglied, Betrachter
  • Beta-Zugangstor

Integrationen

  • Microsoft Graph (OneDrive, SharePoint)
  • Google Drive API, schreibgeschützte Bereiche
  • Dropbox-API
  • Databricks-API
  • AWS S3 und Azure Blob SDKs
  • MySQL-, SQL Server- und PostgreSQL-Treiber

KI

  • Anthropic SDK (Plattform)
  • BYOK: Claude, OpenAI, Gemini
  • Deterministischer heuristischer Anbieter als Standard-Fallback
  • 8 Laufzeit-KI-Optionen für generierte Chat-Apps
  • Tesseract und Google Vision OCR
  • Feature-Gating mit ausfallsicheren Alternativen

Validierung

  • Testen Sie den Oracle-Compiler
  • Referenzvollstrecker
  • Verhaltenssonden mit negativen Tests
  • Toleranzbewusster Komparator
  • Validierungsbericht mit Herkunft
  • Etwa 600 automatisierte Tests in über 100 Dateien

Mandantenfähige und Sicherheitsarchitektur

  • Mandantenisolation in der Datenbank. Ein zusammengesetzter Fremdschlüssel verknüpft jede Lösung mit ihrem Projekt und Mandanten; Eine mandantenübergreifende Zeile kann nicht eingefügt und nicht nur gefiltert werden. Eine Ausführung von einem anderen Mandanten verhält sich genau wie eine fehlende Ausführung, daher kann die API nicht durchsickern lassen, dass eine ID vorhanden ist.
  • Rollen. Besitzer, Administrator, Mitglied und Betrachter, standardmäßig verweigert, mit einer expliziten Zulassungsliste für schreibgeschützte Vorgänge.
  • Audit-Protokoll nur zum Anhängen. Ein Datenbanktrigger lehnt Aktualisierungen und Löschungen ab; Dienste dürfen niemals Anmeldeinformationen, Token oder Dateiinhalte hineinschreiben.
  • Verschlüsselte Anmeldeinformationen. Connector-Geheimnisse und BYOK-Schlüssel sind AES-256-GCM-verschlüsselt mit einem erforderlichen Hauptschlüssel; Das Frontend sieht immer nur einen Fingerabdruck.
  • Härten. Helm, durch die Datenbank unterstützte Ratenbegrenzung, Schemavalidierung, bereinigte Eingabe, DSGVO-Datenrechteflüsse und eine schriftliche Aufbewahrungsrichtlinie.

Modelle auswählen und anbinden.

SKatalyst ist nicht an einen Modellanbieter gebunden. Mieter bringen ihre eigenen Schlüssel für Claude, OpenAI oder Gemini mit; Schlüssel werden im Ruhezustand verschlüsselt, erst bei der Ausführung entschlüsselt und ein aktiver Schlüssel pro Anbieter wird erzwungen. Generierte Chat-Anwendungen nutzen den eigenen Laufzeitanbieter des Kunden, der zum Zeitpunkt der Bereitstellung ausgewählt und während des Entwurfs nie angefordert wurde.

Der Wert liegt in den Modellen: dem Kontext, den Arbeitsabläufen, den strukturierten Daten, der Anwendungsarchitektur und dem Validierungssystem.

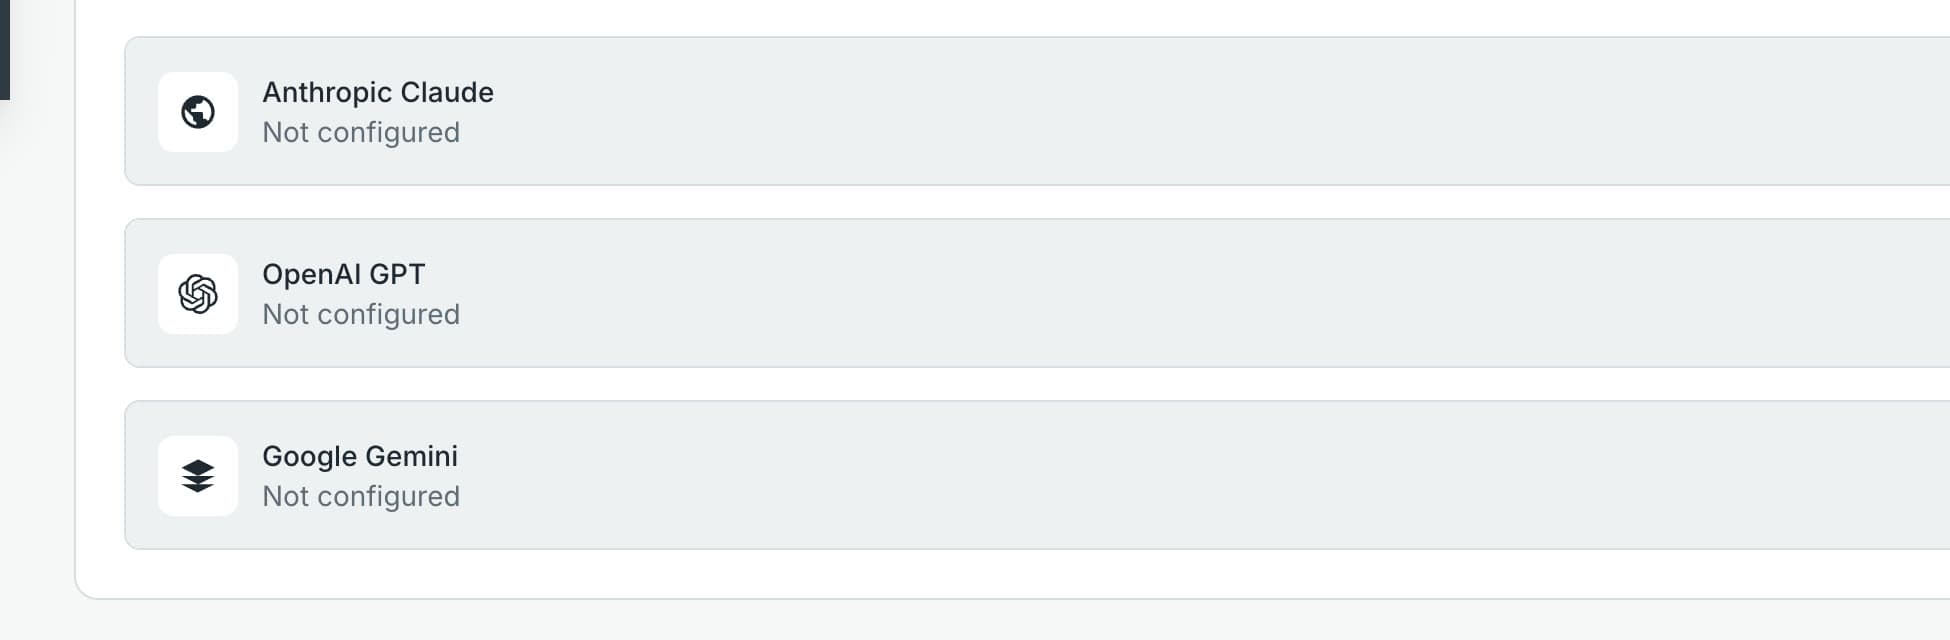
Einstellungen, LLM-API-Schlüssel: Bringen Sie Ihren eigenen Schlüssel für Anthropic Claude, OpenAI GPT und Google Gemini mit.
12
Quelltypen
10
Lösungsmodultypen
4
Versand von Generatoren
12
Lebenszykluszustände
2
menschliche Zustimmungstore
5
Behauptungstypen
3
OAuth-Anbieter
4
Mieterrollen
3
BYOK-Modellanbieter
51
Datenbankmigrationen
390+
API-Endpunkte
~600
automatisierte Tests

Alle Zahlen stammen aus dem Repository vom 28. August 2026: 180 Commits seit Juni 2025. Die Anzahl der Endpunkte ist eine Untergrenze (391 im Hauptrouter plus 11 Routenmodule).

10 · Evolution

Vom Prototyp zur Plattform

  1. Samen

    Anfängliche Projektstruktur.

  2. Datenaufnahme

    Dokumentenaufnahme-Pipeline, LLM-gestützte Klassifizierung mit heuristischem Fallback und herstellerneutraler Anbieterregistrierung.

  3. Kontextverständnis zur Generation

    Metrikmodell, Blueprint-Generierung und der erste Artefaktexport: von der Datenorganisation bis zur Softwareerstellung innerhalb weniger Tage.

  4. Strukturierte Speicherung, Miete, Konnektoren

    Mandantenfähiges Schema, OAuth, verschlüsselter Tresor und BYOK, OCR und visuelles Verständnis, zehn Connector-Backends, unveränderliche Kontext-Snapshots, orchestrierte Ausführungen und KPI-Erkennung.

  5. Prüfung der Produktionsbereitschaft

    Ein selbstkritisches Audit listete die Lücken auf: Beta-Gate, Ratenbegrenzung, Header, Validierungsbibliothek, unbewiesene Isolation. Die meisten wurden in den folgenden Wochen geschlossen.

  6. Verhaltensvalidierung

    Die Agenten-Validierungsschleife wurde offengelegt und schrittweise aufgebaut: Oracle-Compiler, Referenzausführung mit Anomalieerkennung, Verhaltensprüfungen. Patentpaket eingereicht.

  7. Genehmigungslebenszyklus

    Die Lösungseinheit mit ihrer 12-Zustandsmaschine, zwei unterschiedlichen menschlichen Toren und Transaktionsprüfereignissen.

  8. Operative Beta

    Landing-Administration, Ratenbegrenzungszähler, Bereitstellung und Überprüfung von Runbooks, Onboarding und die eingefrorene authentifizierte App für die Beta im September 2026.