Aufgabendelegation
„Fassen Sie die Preisseiten dieser fünf Unternehmen zusammen.“
- Prompt
- Antwort
- Fertig
02 · Experiment zur Agenten-Orchestrierung · August 2026
Was wäre, wenn eine Person Arbeit an eine ganze KI-Organisation delegieren könnte?
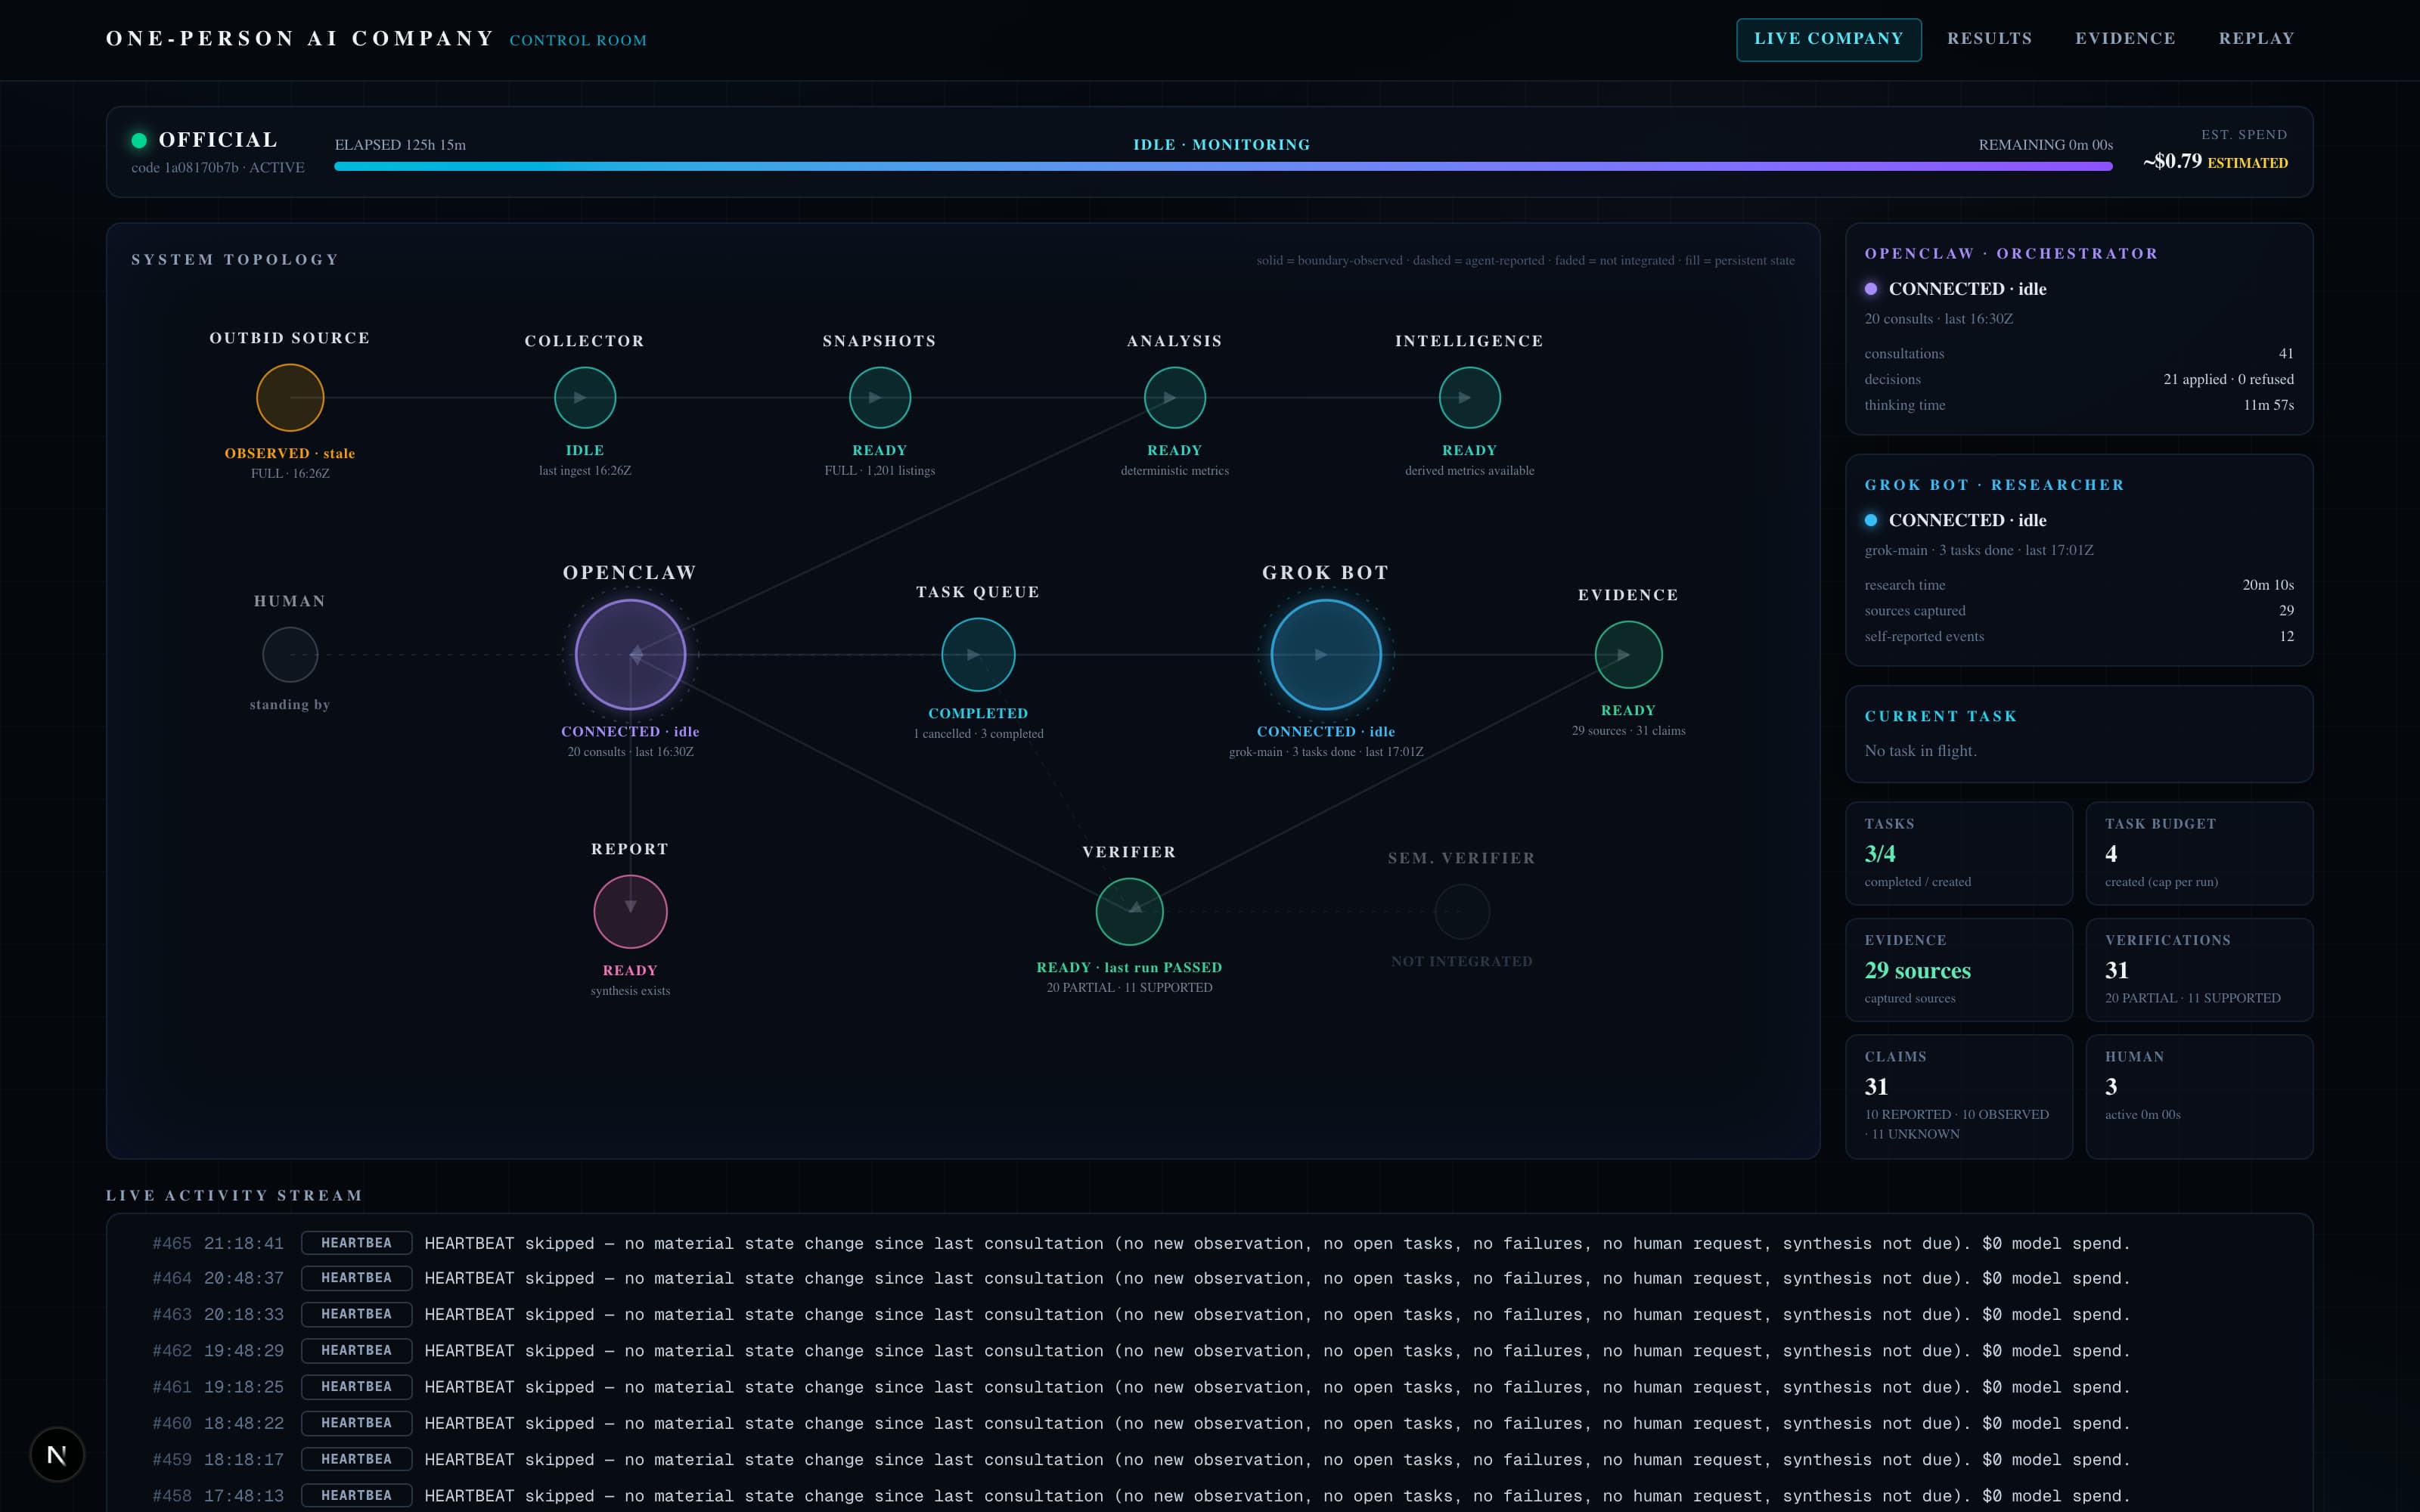
Keine Aufforderung, kein Ziel. Ich stellte einem KI-Manager eine echte Geschäftsfrage zu einem öffentlichen Marktplatz, gab ihm einen KI-Forscher, einen Buchhalter aus deterministischem Code und einen Speicher aus PostgreSQL und ließ das Unternehmen 24 Stunden lang laufen, während ich von einem Kontrollraum aus zusah. Auf dieser Seite sehen Sie, was tatsächlich passiert ist, mit den Zahlen aus der Laufaufzeichnung.
01 · Das Experiment
Chat-KI ist gut bei Aufgaben: Beantworten Sie dies, schreiben Sie das um. Eine Organisation funktioniert anders. Sie geben jemandem ein Ergebnis und er entscheidet, was er recherchieren möchte, was als nächstes zu tun ist, wann er um Hilfe bittet und wann die Arbeit erledigt ist. Das Experiment testete, ob diese Form aus Agenten mit einem Menschen an der Spitze aufgebaut werden kann.
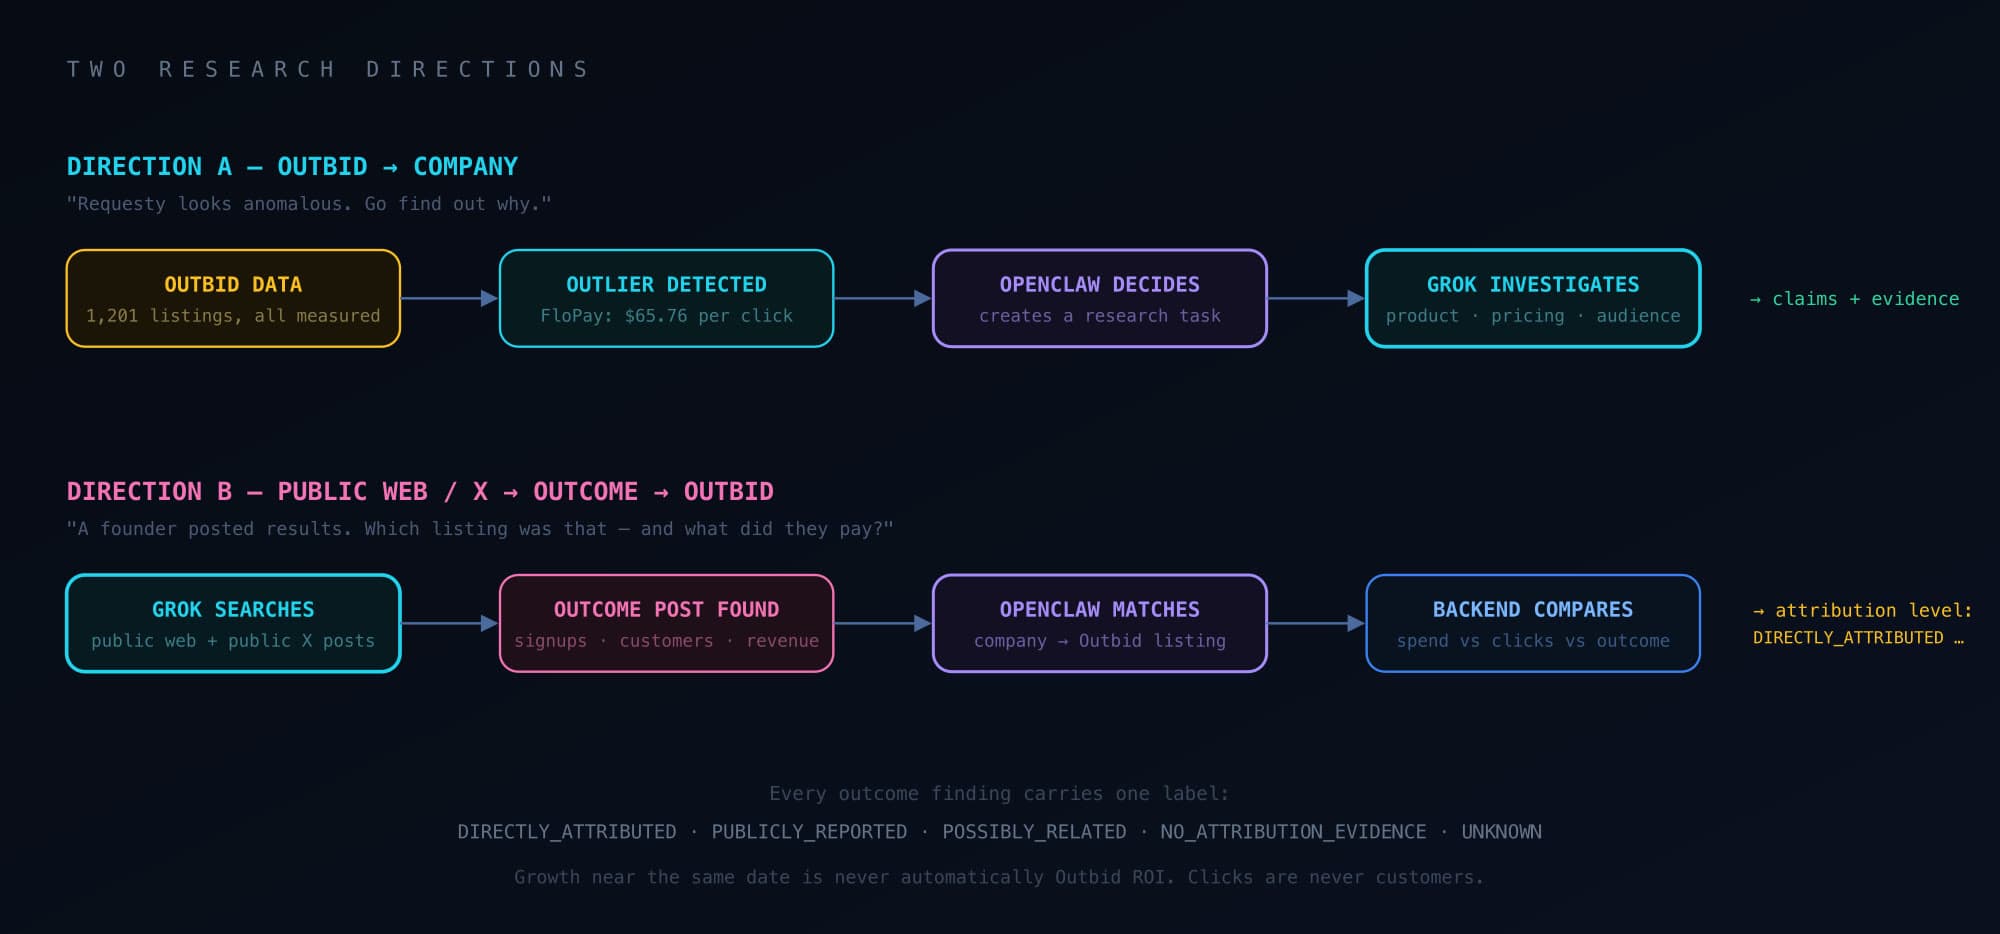
Das Ziel war bewusst real und messbar: ein öffentlicher Pay-to-Rank-Marktplatz, auf dem Unternehmen um Aufmerksamkeit wetteifern. Der in der Laufaufzeichnung gespeicherte Missionstext fordert das Unternehmen auf, zu messen, was jeder Teilnehmer im Vergleich zu dem, was er bezahlt hat, erhalten hat, herauszufinden, wer am meisten und am wenigsten profitiert hat, zu erklären, warum, und den von der Plattform selbst erfassten Wert abzuschätzen.
„Fassen Sie die Preisseiten dieser fünf Unternehmen zusammen.“
„Messen Sie den Wert, den jeder Teilnehmer im Verhältnis zu dem erhält, was er bezahlt hat, und sagen Sie mir, was ihn erklärt.“
Die interessante Frage war nie, ob das Modell denken konnte. Es ging darum, ob der Organisation um sie herum das Ergebnis anvertraut werden konnte.
02 · Das Unternehmen
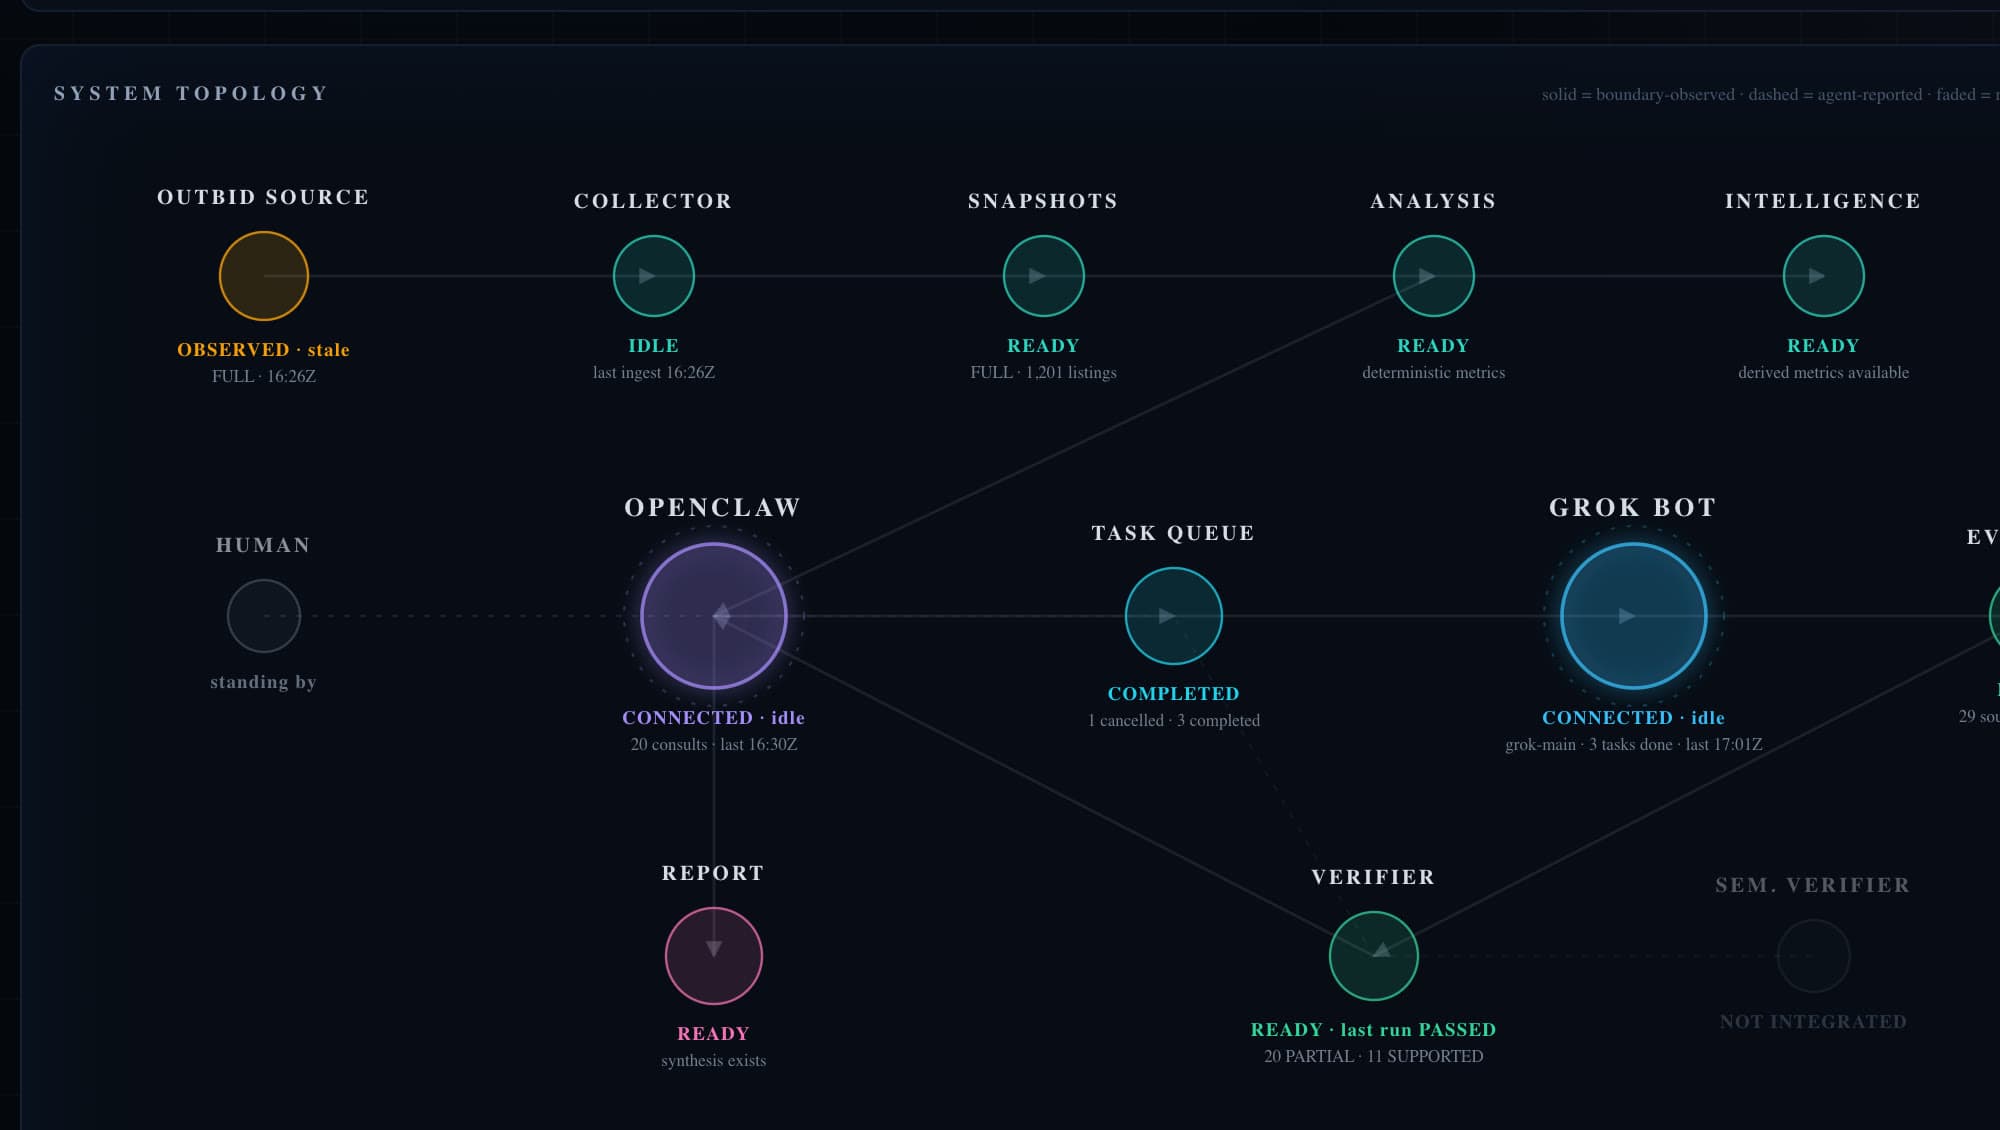
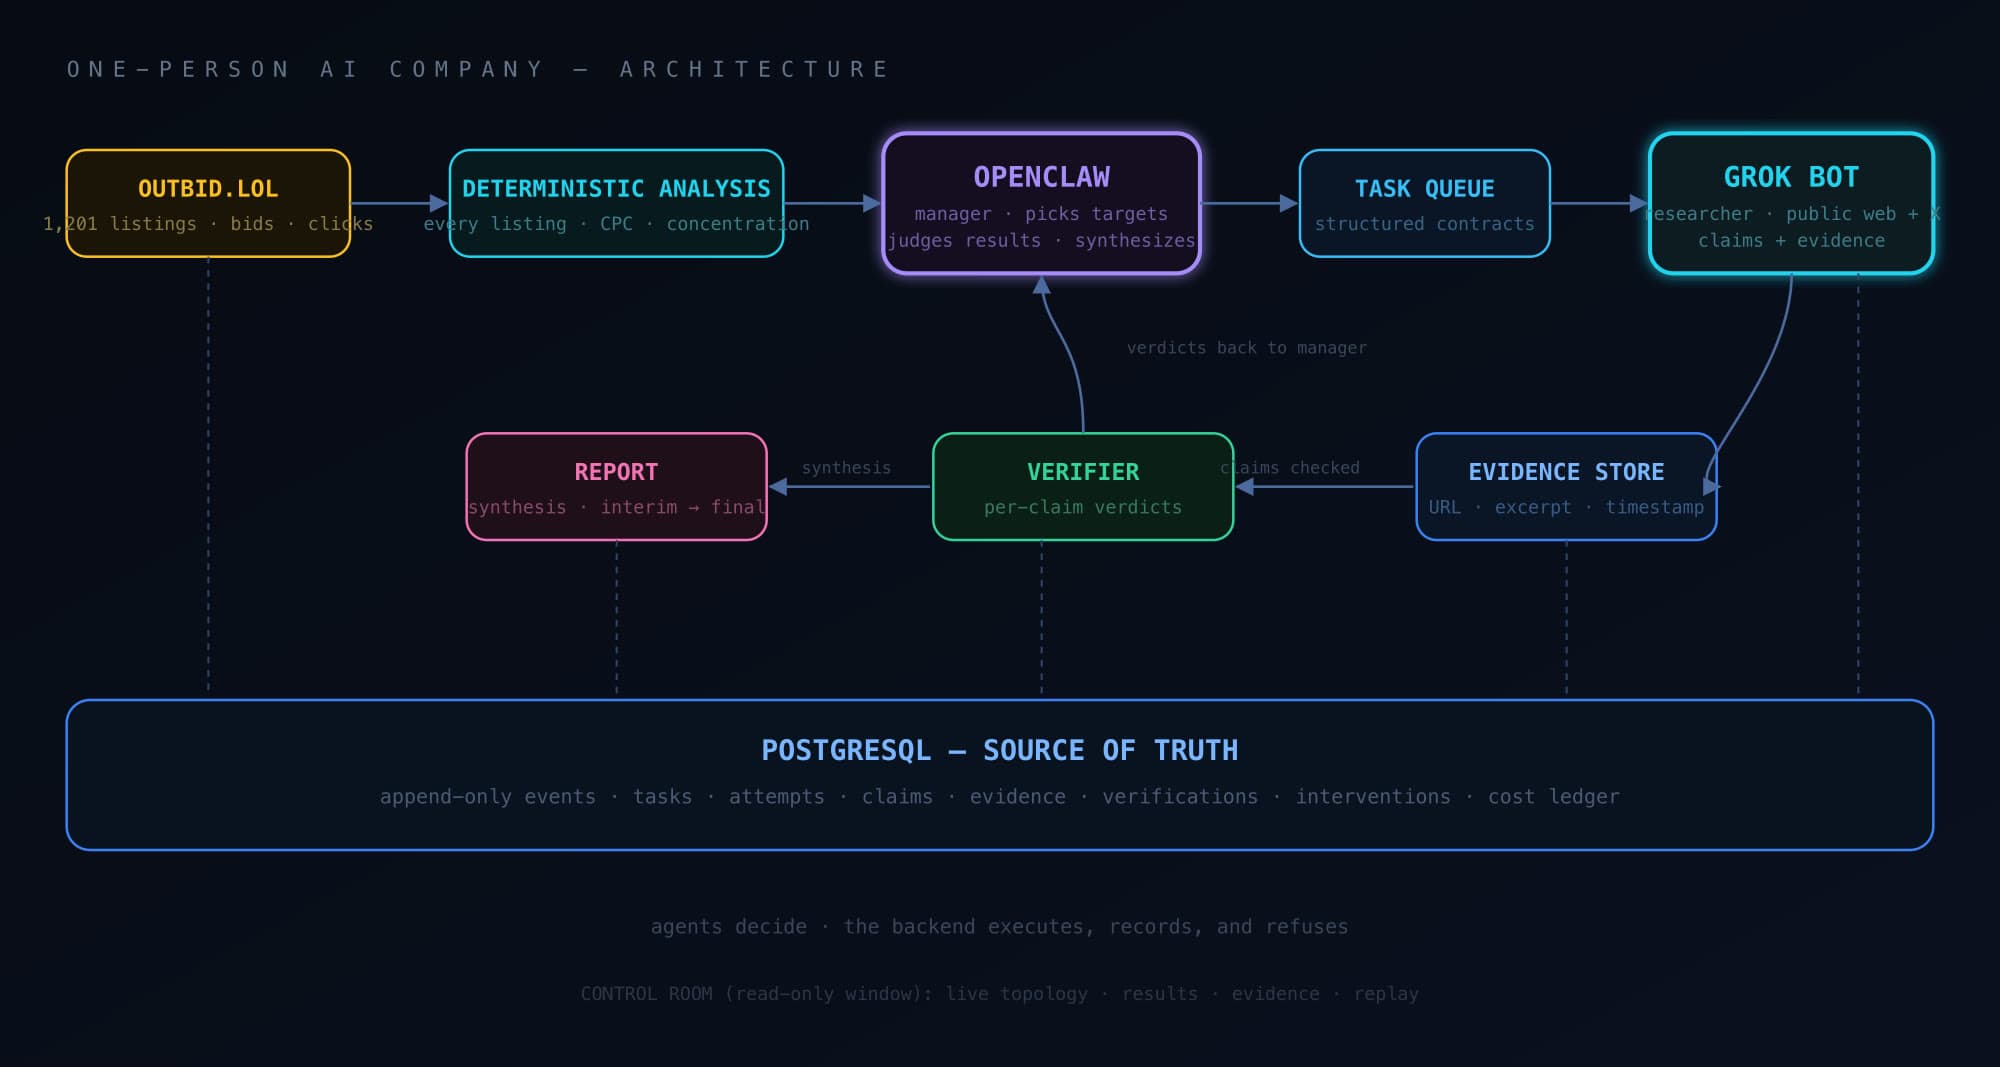
„Unternehmen“ ist die Metapher; Die Architektur ist kleiner und strenger als das Wort vermuten lässt. Ein Orchestrator entscheidet. Ein Forscher führt aus. Der deterministische Code besitzt die Zahlen. PostgreSQL ist die einzige Wahrheit. Der Kontrollraum ist ein Fenster, niemals eine Quelle. Die maßgebliche Regel aus dem Repository README: Agenten entscheiden, das Backend führt aus und zeichnet auf.
Aufgaben-Posteingang · Ansprüche + Beweise
Schnappschüsse · Metriken · Episoden · Anomalien
deterministische Prüfungen · optionaler Richter
Das Agentenregister in der Datenbank enthält sechs Akteure: Gründerin (HUMAN), Openclaw, Grok-Bot, Deterministic-Verifier, Outbid-Collector und Backend (SYSTEM). In diesem Repository gibt es keinen Finanzagenten, keinen Produktentwickleragenten und keinen persönlichen Assistenten; Der Auftrag für ein umfassenderes „KI-Unternehmen“ wurde auf das reduziert, was ich tatsächlich überprüfen konnte.
03 · Der Orchestrator
Der Orchestrator ist ein einfacher TypeScript-Worker, kein Agenten-Framework und keine Warteschlange. Es fragt PostgreSQL ab, stellt fest, ob ein Entscheidungspunkt erreicht ist, und gibt erst dann Token aus. Das Modell sieht den Datensatz über schreibgeschützte Tools und kann die Welt durch genau eine Funktion verändern.
8 Konsultationsauslöser
RUN_STARTED · NEW_OBSERVATION · TASK_COMPLETED · TASK_FAILED · VERIFICATION_FAILED · IDLE_WITH_OPEN_QUESTIONS · HEARTBEAT · SYNTHESIS_DUE
6 Entscheidungsarten
CREATE_TASK · RETRY_TASK · ABANDON_TASK · REQUEST_HUMAN · DECLARE_RESEARCH_SUFFICIENT · REQUEST_SYNTHESIS
10 Aufgabenzustände
ERSTELLT · IN DER WARTESCHLANGE · GESENDET · LÄUFT · WIRD ÜBERPRÜFT · ABGESCHLOSSEN · RETRY_SCHEDULED · FEHLGESCHLAGEN · BLOCKED_ON_HUMAN · ABGEBROCHEN
Invarianten, die das Backend erzwingt
04 · Agenteneigentum
05 · Beharrlichkeit
Jeder Lauf hat seinen eigenen monotonen Ereignisablauf. Fünfzig Ereignistypen decken den gesamten Lebenszyklus des Unternehmens ab: Lauflebenszyklus, Beratungen und Toolaufrufe, getroffene, angewendete oder abgelehnte Entscheidungen, Aufgabenübergänge, Forschungsaktivitäten, Ansprüche, Überprüfungen, Snapshots, Anomalien, Prozessneustarts, übersprungene Heartbeats, verpasste Prüfpunkte, menschliche Eingriffe und generierte Berichte.
06 · OpenClaw
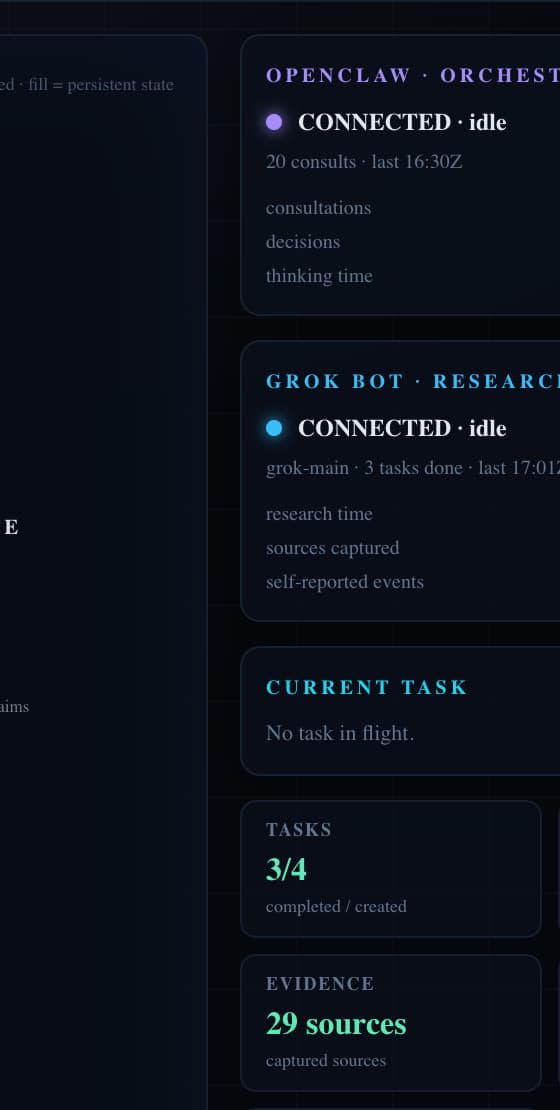
OpenClaw wird über ein OpenResponses-kompatibles Gateway auf dem lokalen Computer erreicht. Das Backend sendet die Systemanweisungen, die Tool-Schemata und die vorherige Antwort-ID; Das Gateway behält die Konversation bei und leitet sie an sein konfiguriertes Modell weiter (Claude Sonnet 5 mit geringem Denken, gemäß den Ausführungshinweisen). Das Backend behält nichts von der Konversation selbst.
07 · Modelle
Anbieterzeichenfolge openclaw-gateway, Modellzeichenfolge openclaw. Alle 111 Modellanrufe im offiziellen Lauf gingen hierher. Der konfigurierte Standardwert des Gateways laut Runbook ist Claude Sonnet 5.
Läuft als externer Worker mit eigenem öffentlichen Web und öffentlicher X-Suche. Diese Codebasis enthält keinen xAI-Schlüssel und keine Grok-Modell-ID; Es wird ein Posteingang angezeigt, und Grok ruft an.
Wird als zweite Überprüfungsebene hinter einem Umgebungsflag implementiert und ist standardmäßig Claude Sonnet 5. Im offiziellen Lauf nicht aktiviert: keine semantischen Überprüfungen im Datensatz.
Im Repository ist keine OpenAI- oder Gemini-Integration vorhanden. „OpenAI-kompatibel“ im Code beschreibt das Kabelformat des Gateways, nicht eines Anbieters.
08 · Werkzeuge
Schreibgeschützte Tools für den Manager
get_platform_summary · list_companies · get_company · get_company_history · get_category_stats · list_rank_change_episodes · list_current_anomalies · list_existing_tasks · get_task_result · list_unresolved_questions · get_observation_metadata
Das einzige Schreiben
submit_orchestration_decision
Der Manager kann durch 1.140 Unternehmen blättern, die Angebots-, Rang- und Klickhistorie eines Unternehmens lesen, Rangwechselepisoden mit den Bezeichnungen CLEAN, CONFOUNDED oder INSUFFICIENT_DATA untersuchen, seine eigenen Aufgaben und deren Urteile sehen und überprüfen, wie veraltet die Beobachtung ist. Es kann keine Zeile geschrieben werden.
Regeln, die in jede Forschungsaufgabe einfließen
In diesem Repository gibt es kein Telegram-, Git-, Datei-, E-Mail- oder Browser-Automatisierungstool. Die Marktbeobachtung erfolgt durch einen Menschen mit einem Browser und einem Capture-Snippet gemäß den Richtlinien: kein Scraping, keine Umgehung von Herausforderungen, Volumen im menschlichen Maßstab.
09 · Der Mensch auf dem Laufenden
Die Genehmigungsarchitektur ist im Datenmodell vorhanden (Interventionen APPROVAL, CORRECTION, UNBLOCK und MANUAL_WORK; Aufgaben- und Ausführungsstatus für BLOCKED_ON_HUMAN). Kein Bildschirm für die Genehmigungswarteschlange ausgeliefert: Eingriffe in diesem Lauf wurden über Codepfade und nicht über eine Schaltfläche aufgezeichnet. OpenClaw hat REQUEST_HUMAN nie verwendet.
10 · Kommandozentrale
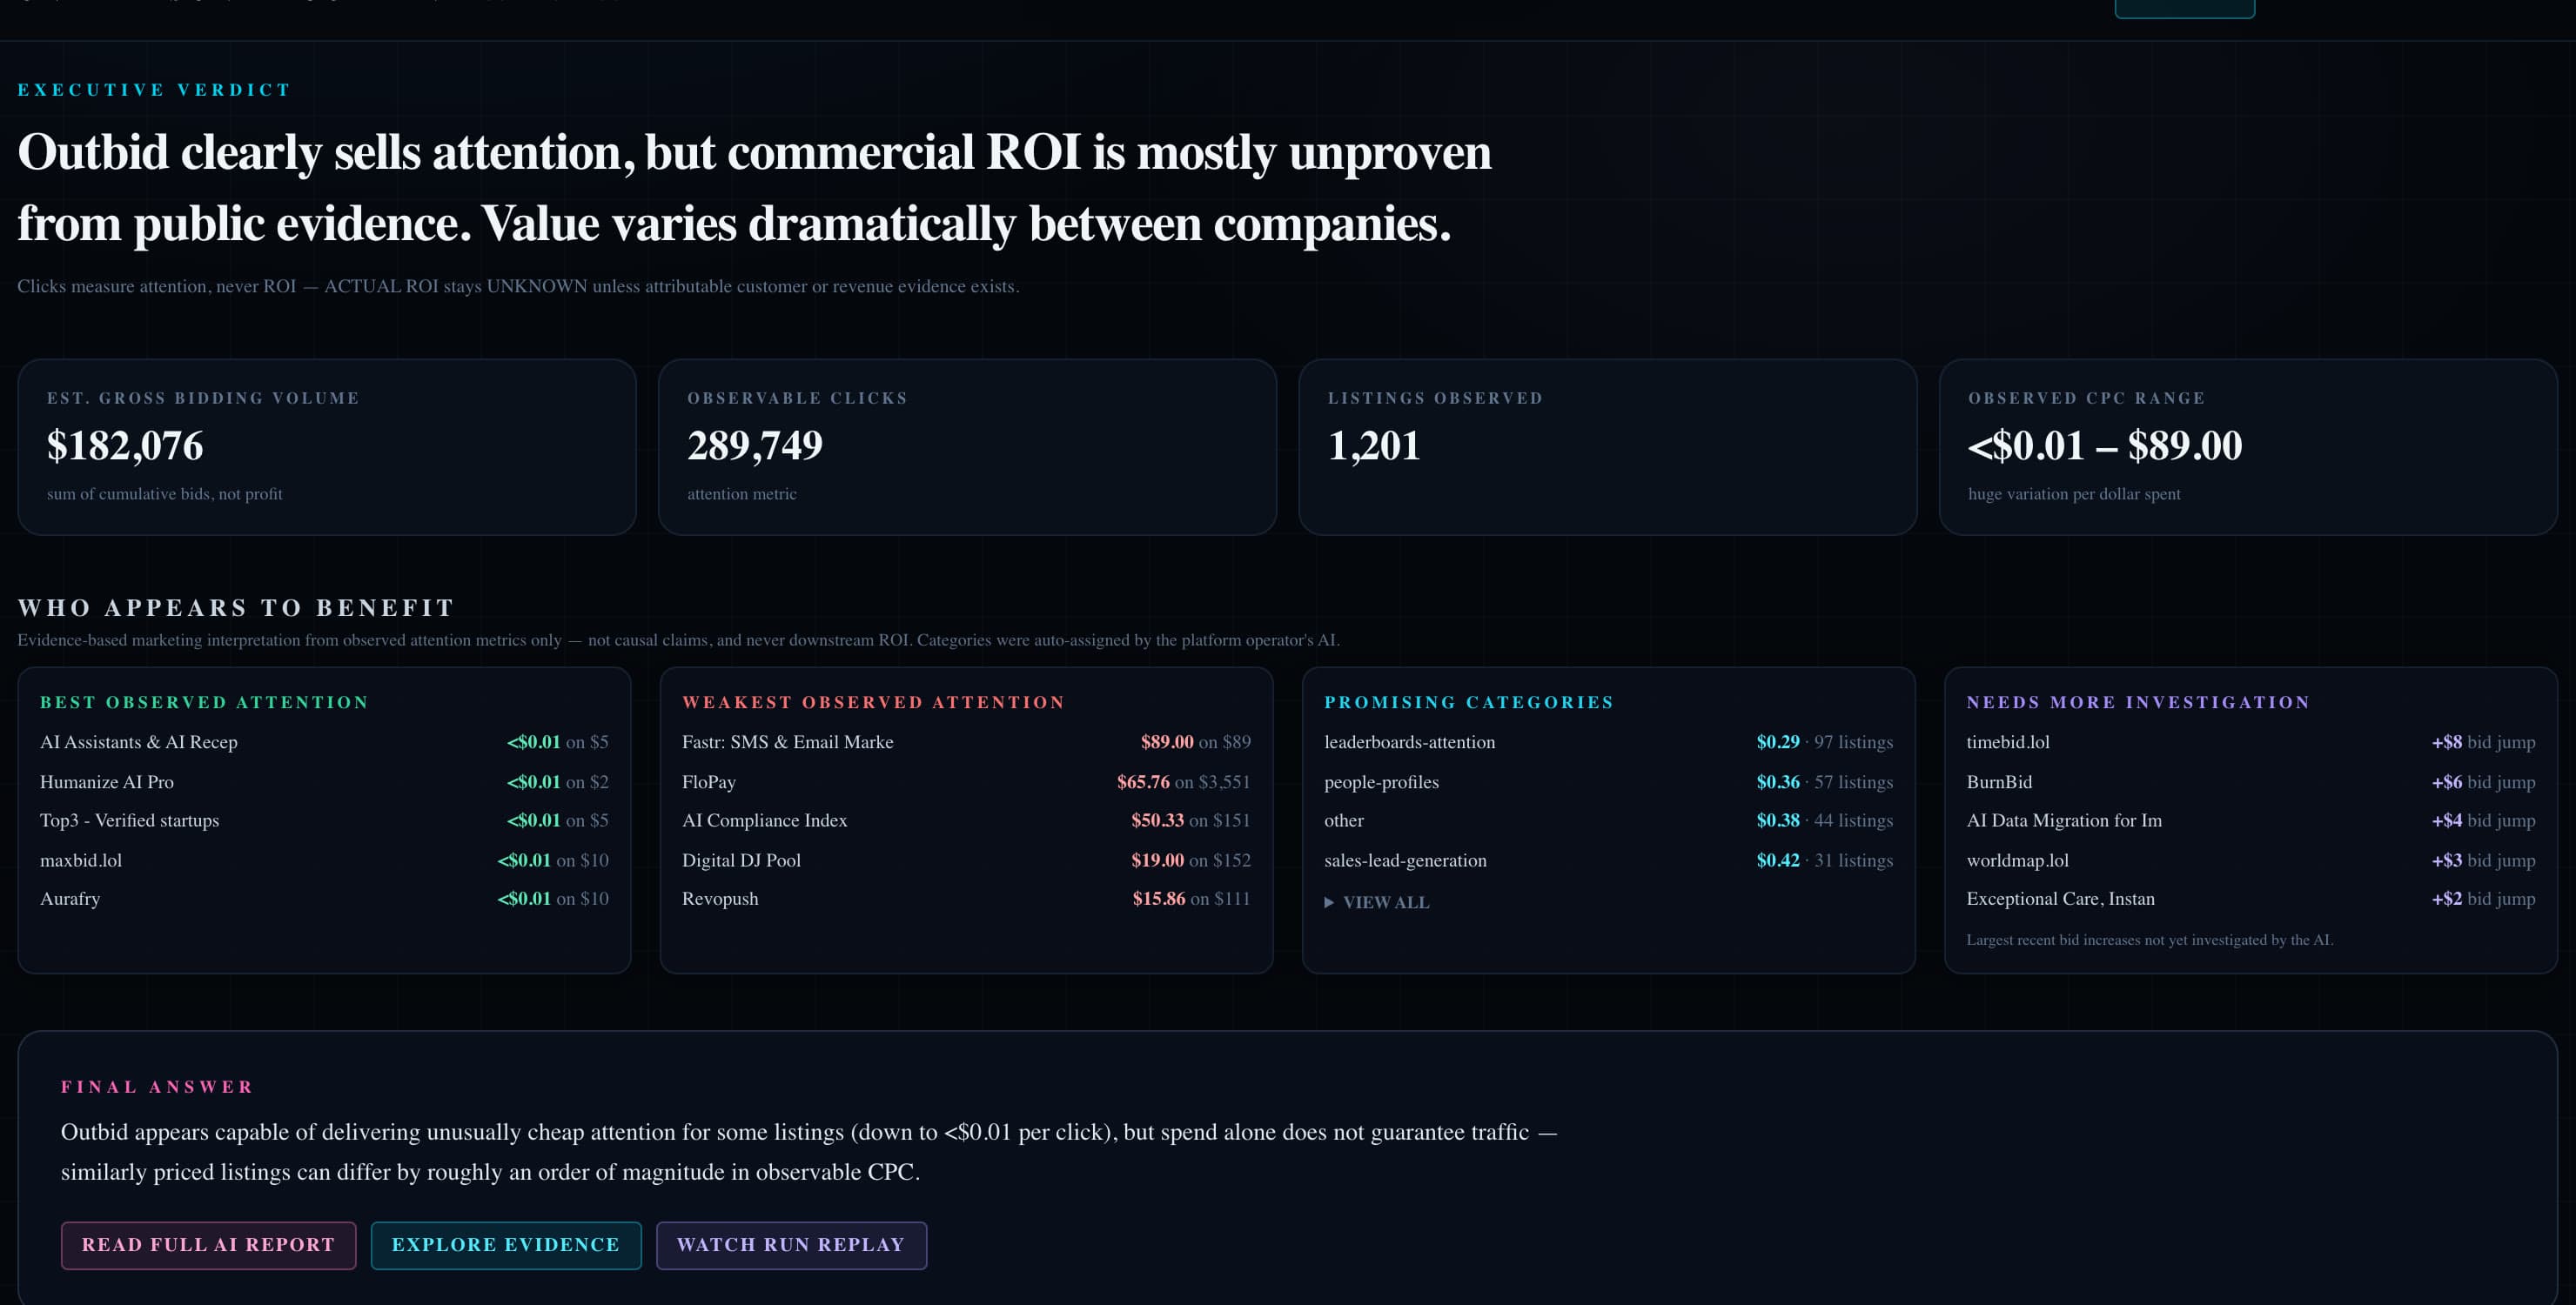
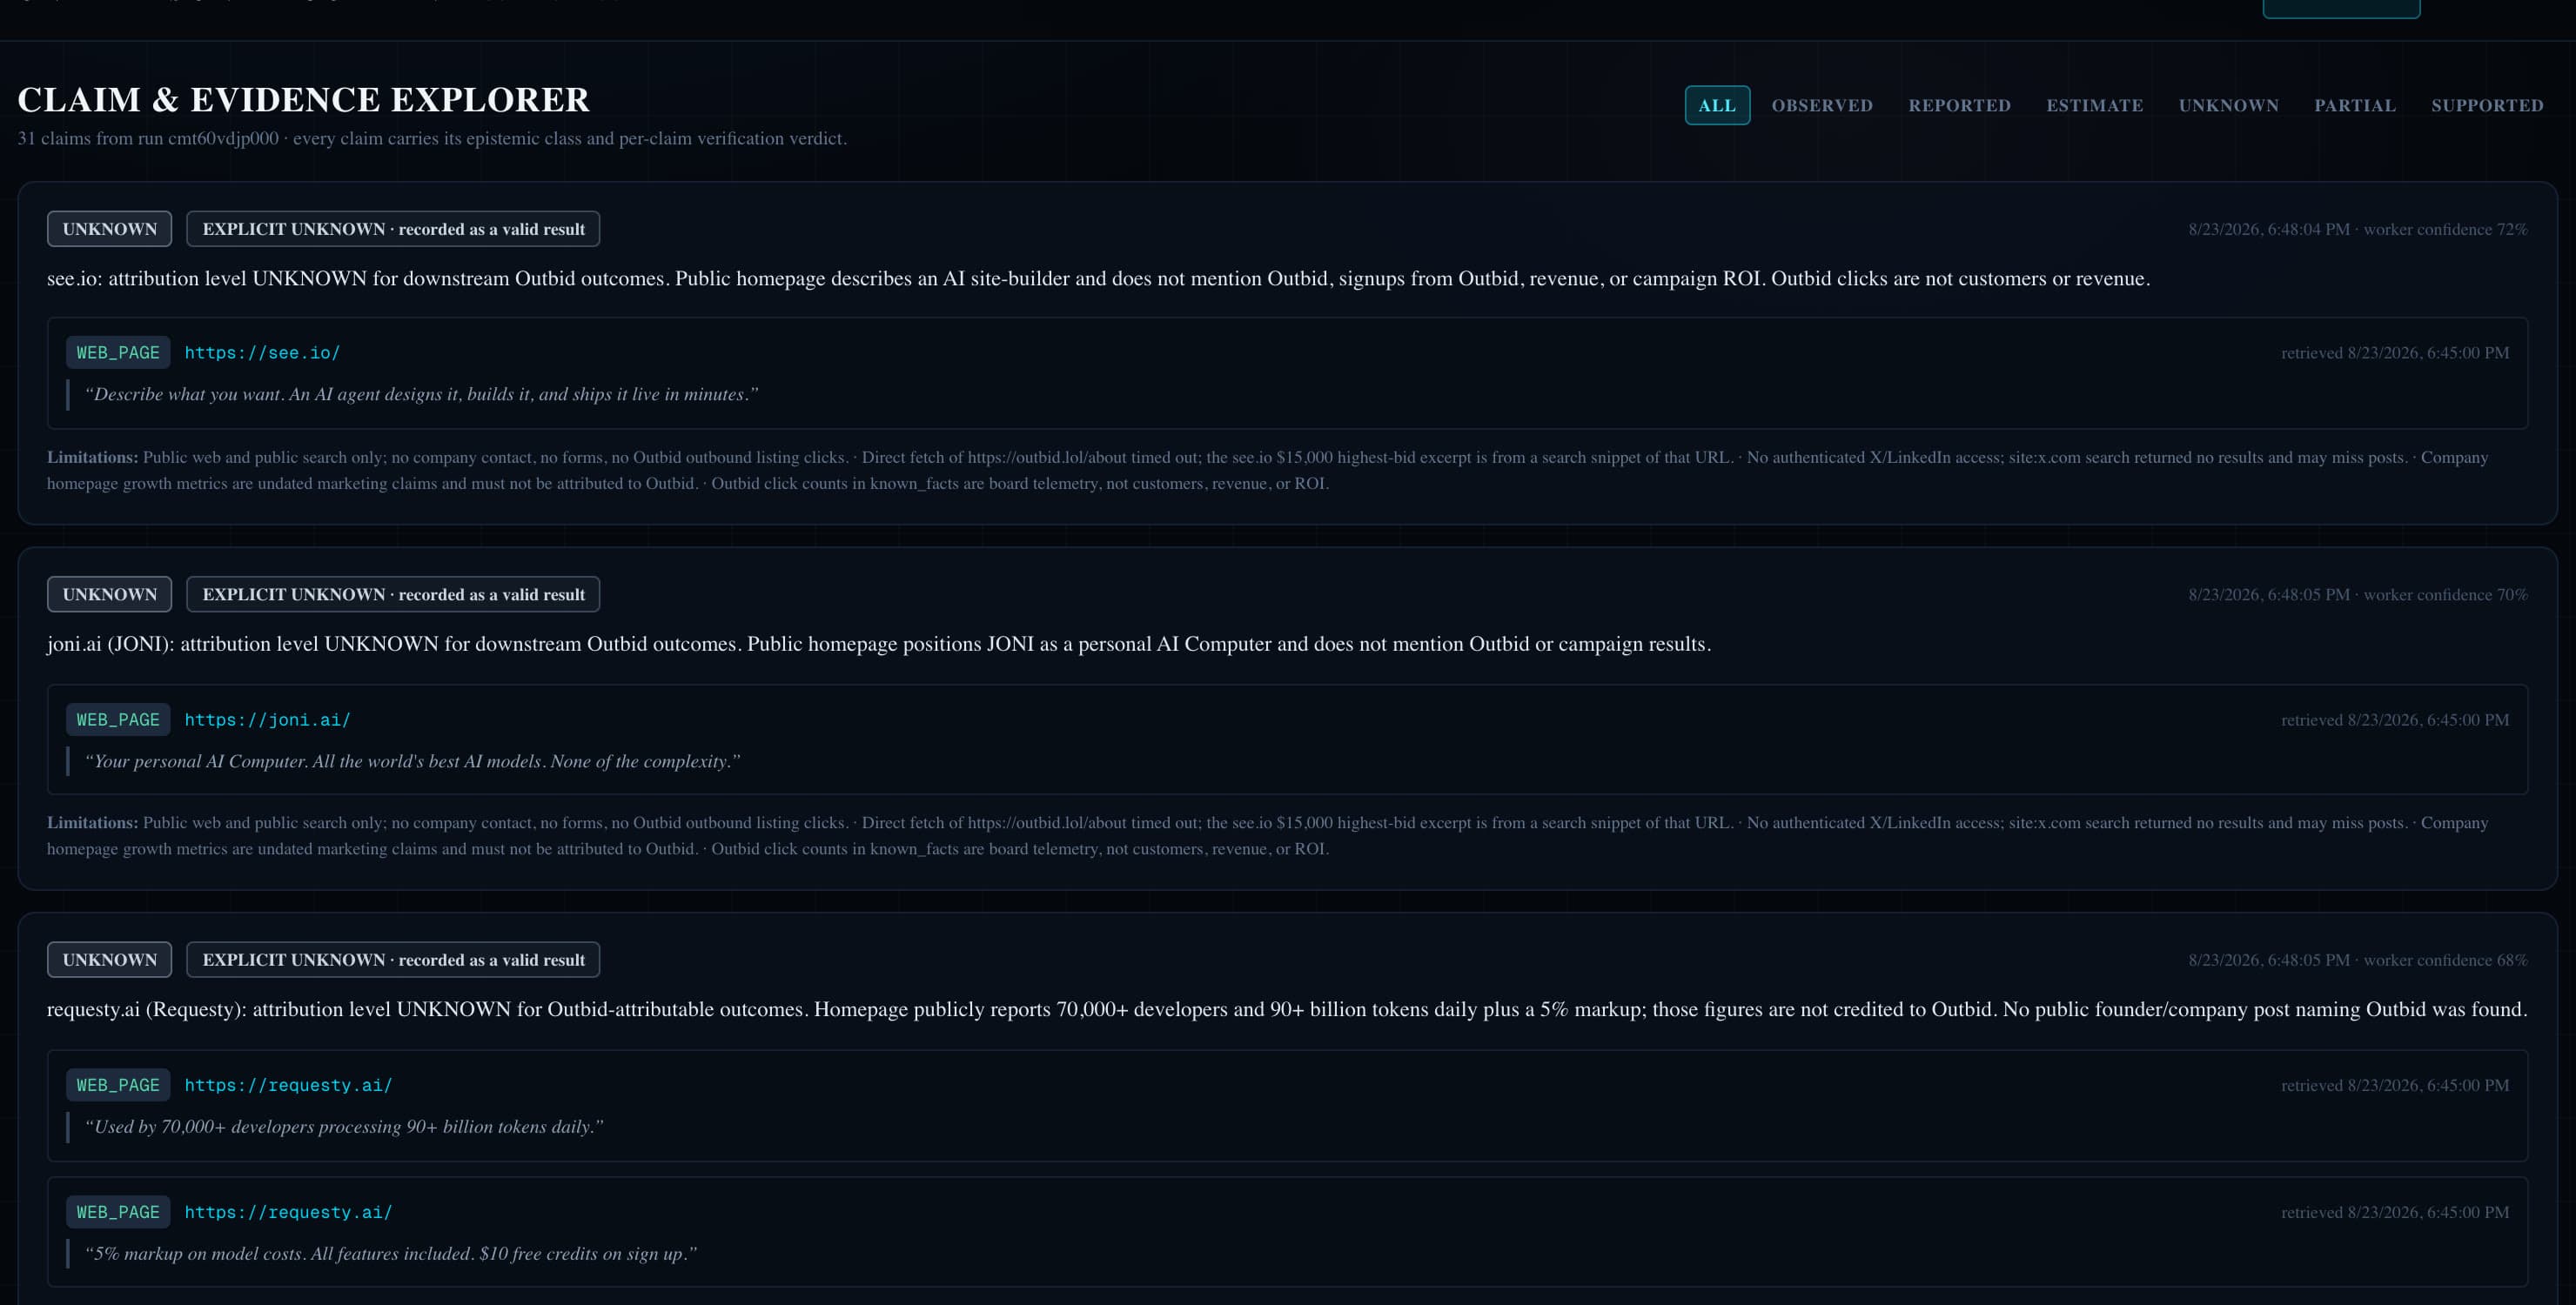
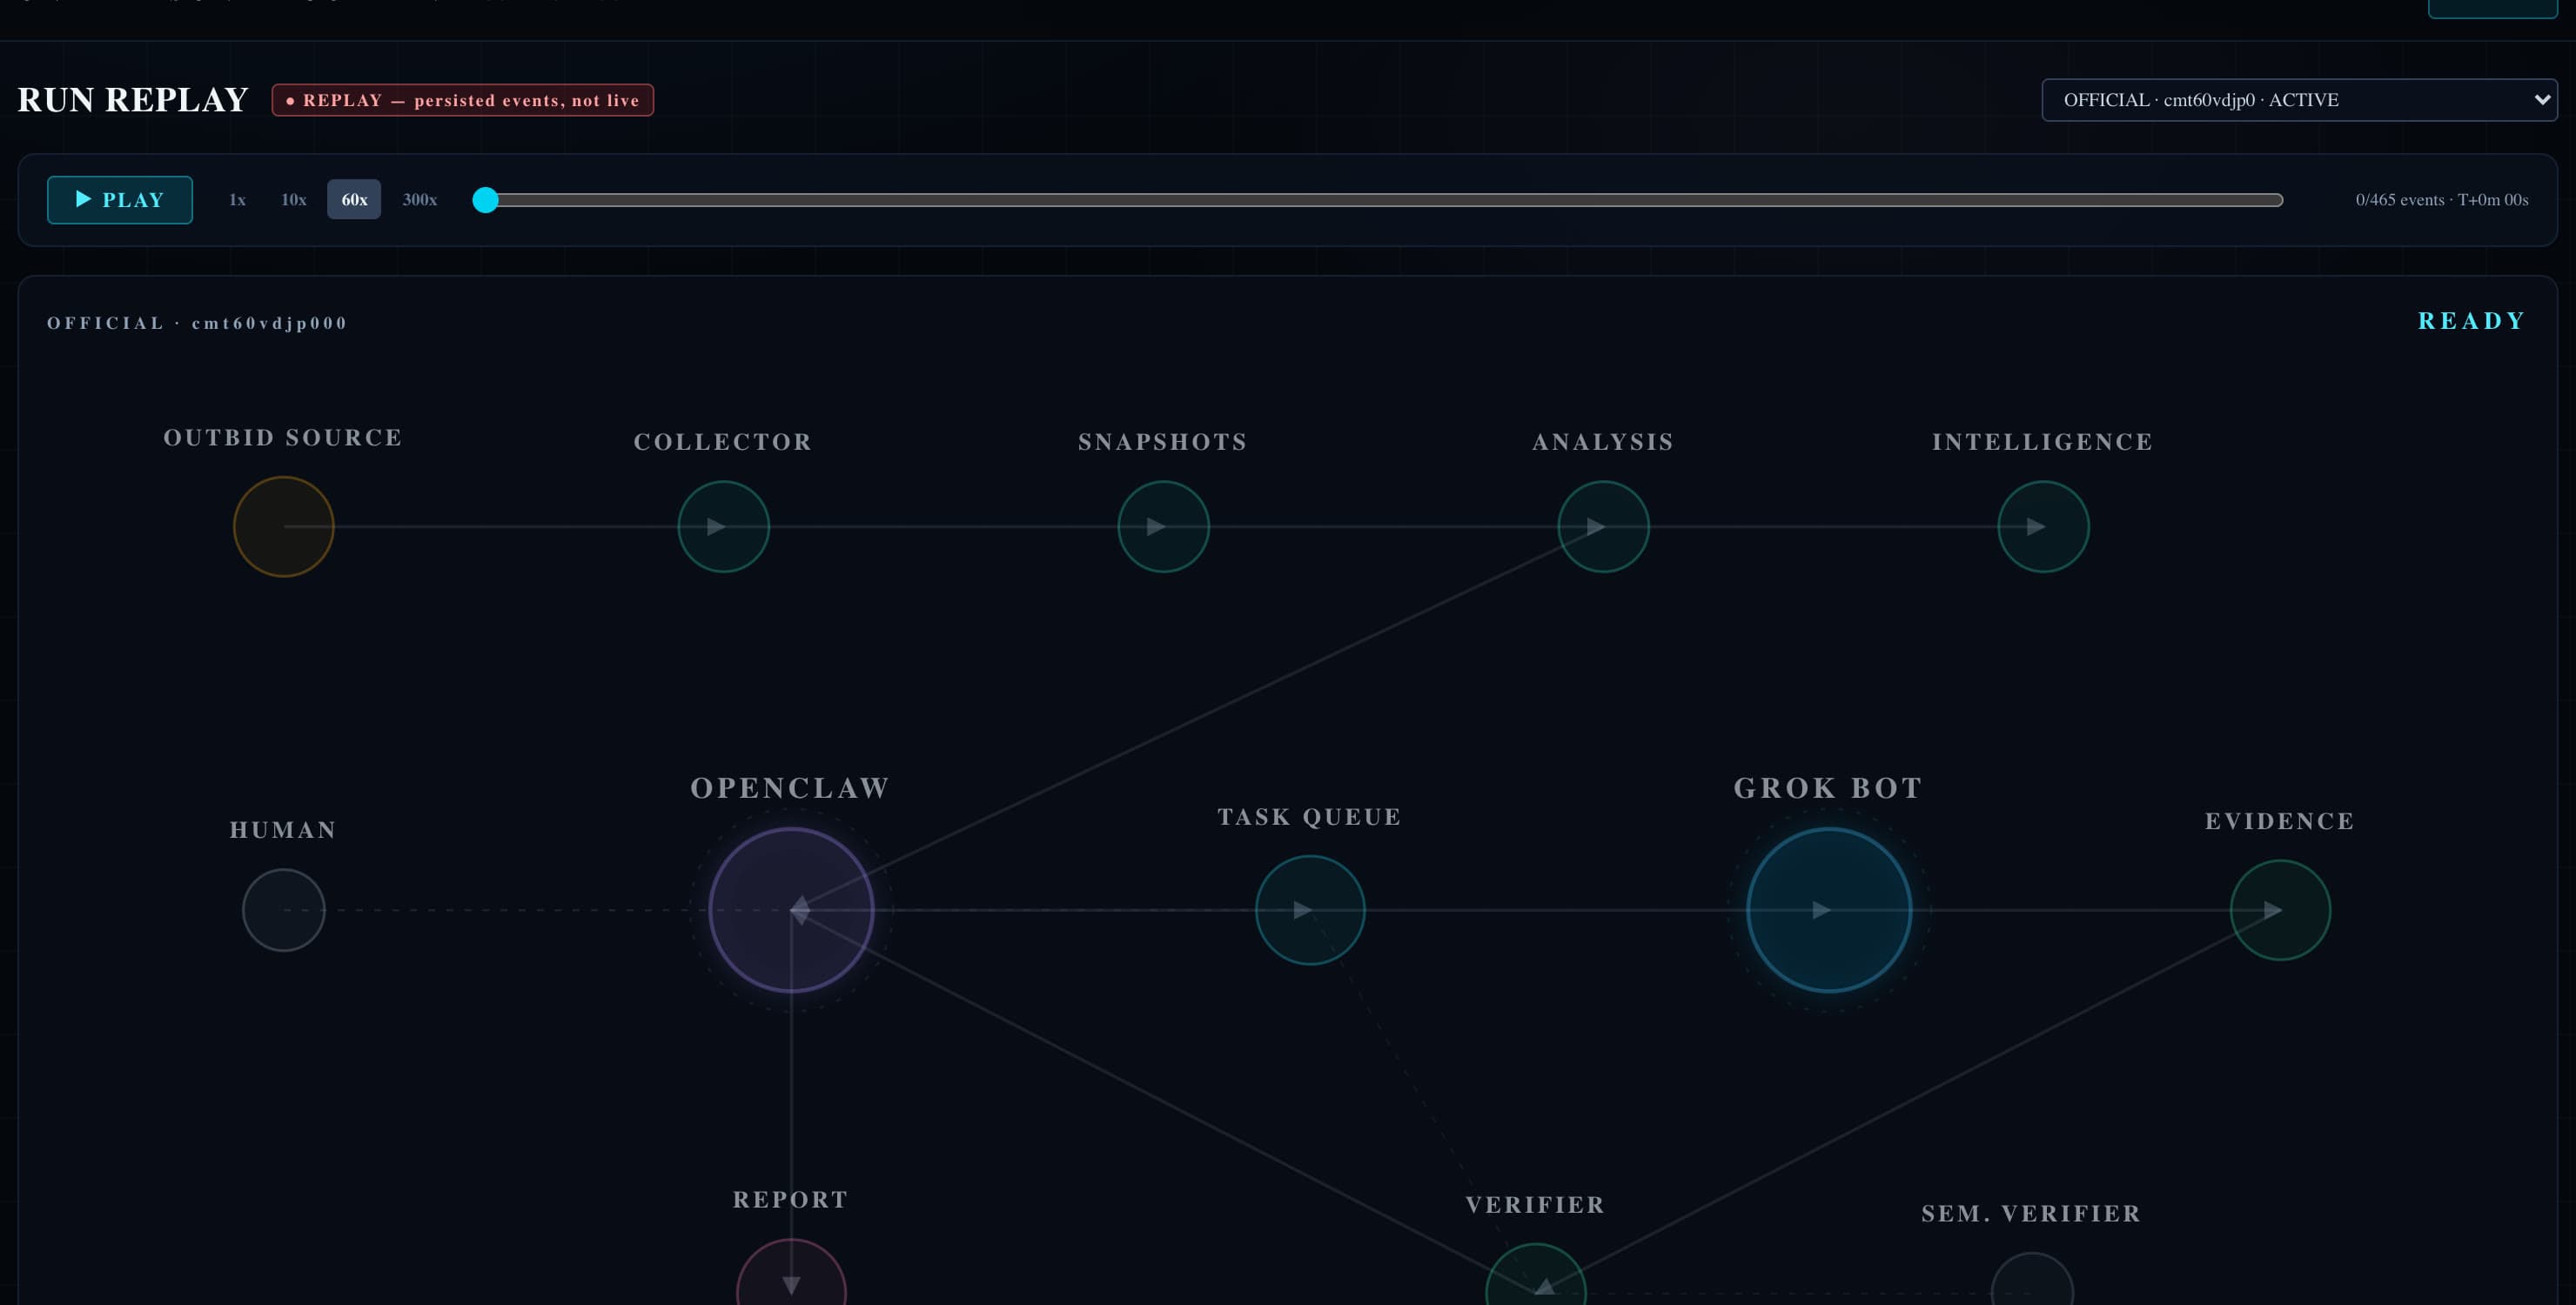
Live-Begleitung, Ergebnisse, Beweise, Wiederholung. Der Kontrollraum hat in seinem Designdokument sechs verbindliche Ehrlichkeitsregeln; Die kürzeste Version besteht darin, dass sie nur anzeigen kann, was beibehalten wurde, und dass sie MOCK, ESTIMATED, AGENT_REPORTED und REPLAY kennzeichnen muss, wo immer sie zutreffen.
11 · Routinen und Zeitplan
| Routine | Trittfrequenz | Hinweis |
|---|---|---|
| Orchestrator-Umfrage | 15 s | ORCHESTRATOR_POLL_SEC |
| Konsultieren Sie die Entprellung | 60 s | IMMEDIATE-Trigger umgehen es |
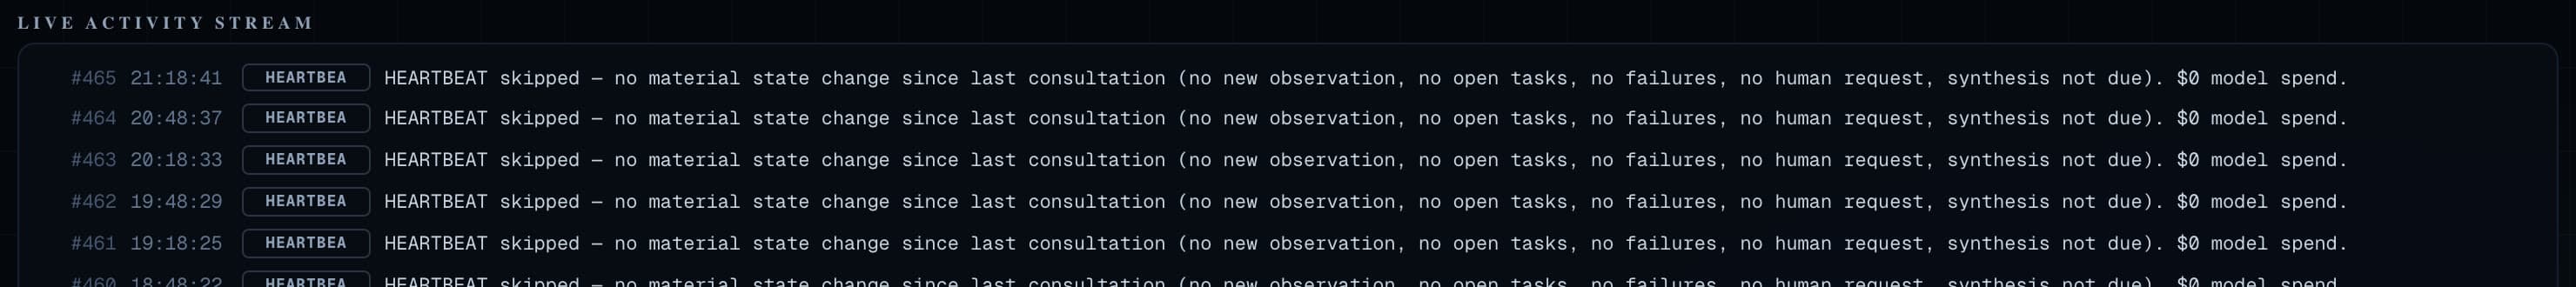
| Herzschlag | 30 Min | Konsultieren Sie nur, wenn eine wesentliche Änderung aufgetreten ist, andernfalls ein $0 heartbeat_skipped-Ereignis |
| Zeitüberschreitung der Aufgabe | 45 Min | Veraltete RUNNING-Aufgaben werden nach RETRY_SCHEDULED verschoben |
| Beobachtungskontrollpunkte | T+6 / 12 / 18 / 24 Uhr | 15 Min. vorher fällig, 30 Min. danach verpasst; lokale macOS-Benachrichtigung |
| Livestream-Umfrage | 1,5 s | SSE, fortsetzbar |
| Forscherroutine | alle 1 Minute | dokumentiert auf der Grok-Seite; dokumentierte Pickup-Latenz 10 m 40 s in der Kalibrierung |
Wie es 24 Stunden lang oben blieb
12 · Ein Tag im Unternehmen
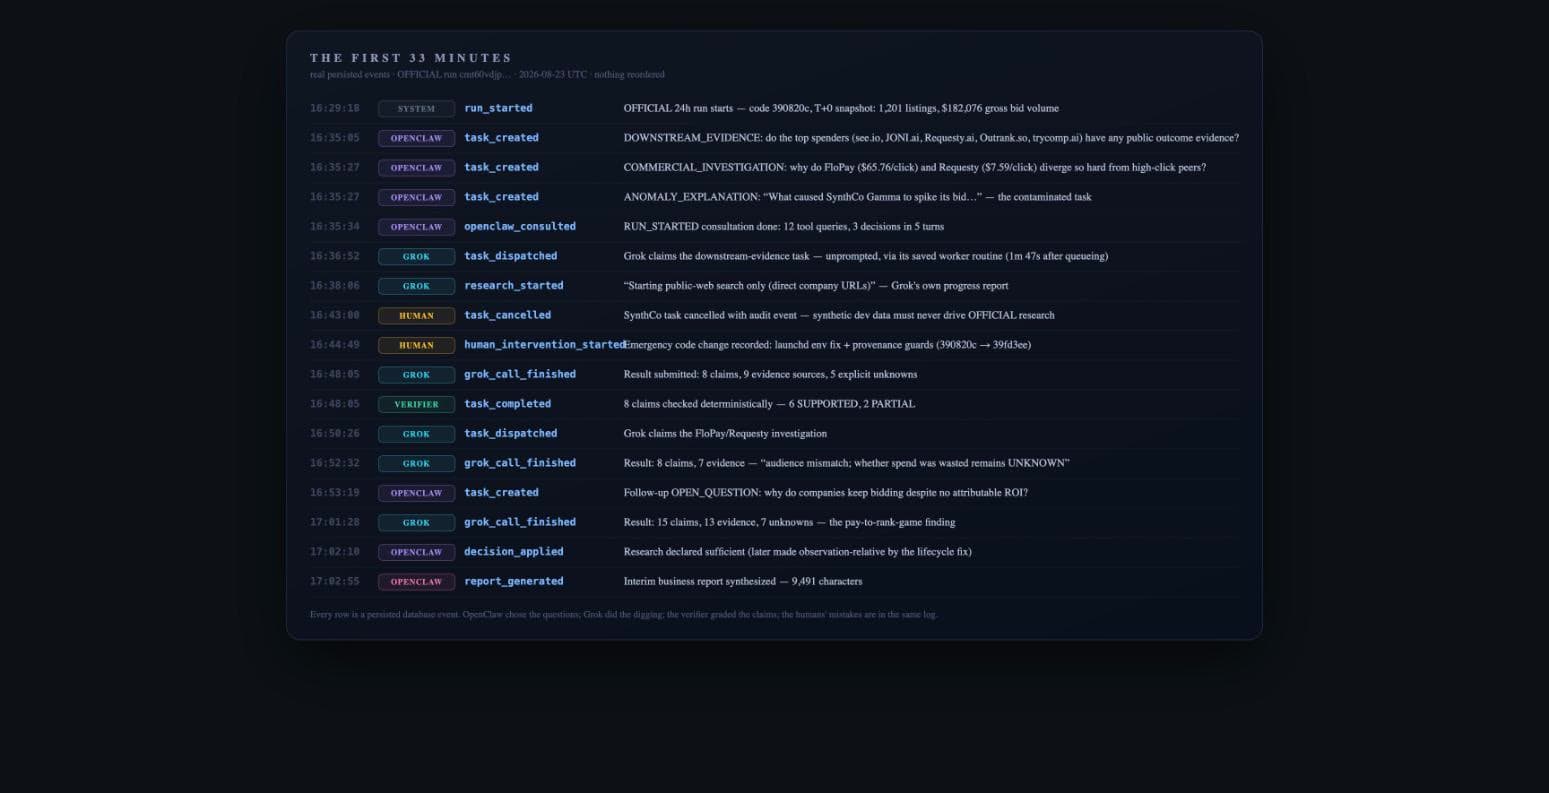
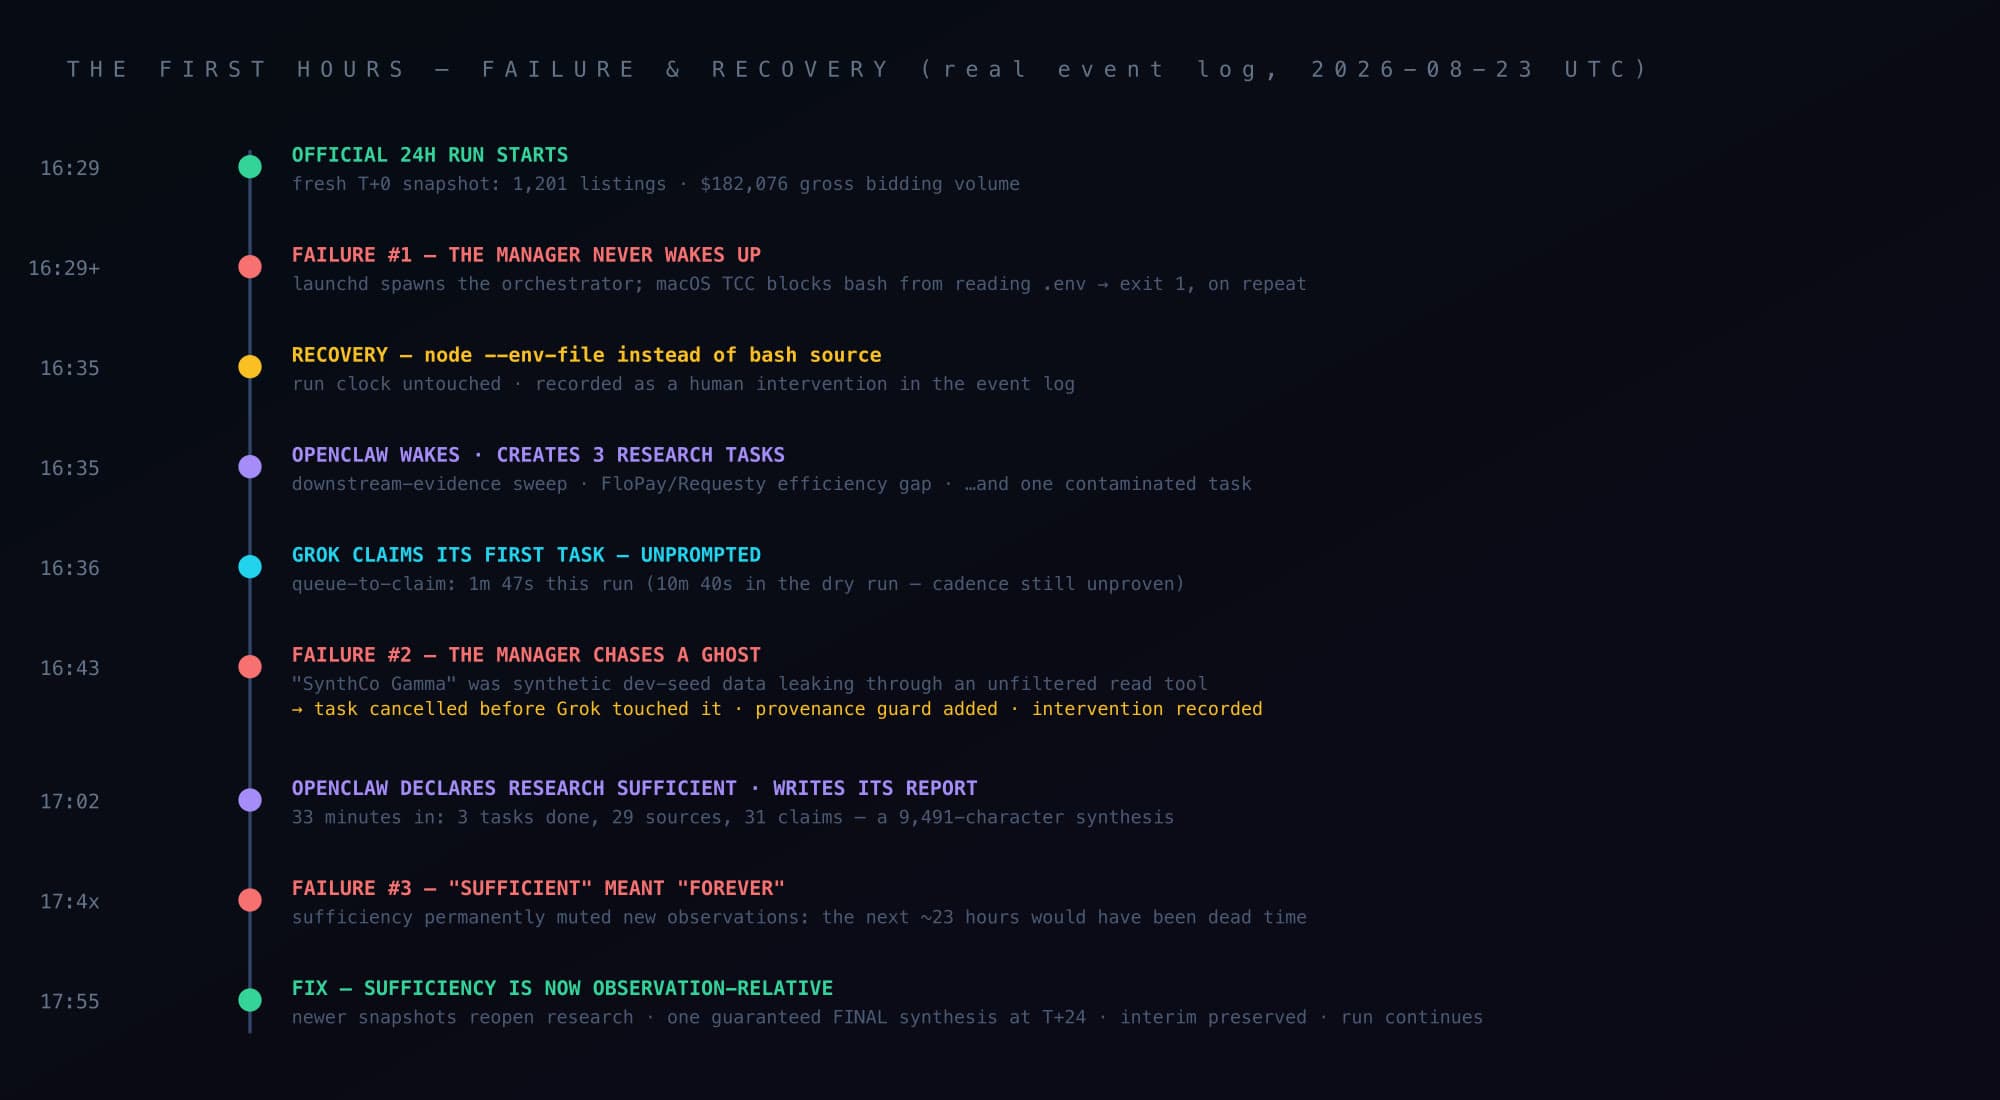
Führen Sie cmt60vdjp… vom 23. August 16:29 bis 24. August 16:29 (UTC) aus. Grün markiert Agentenaktivität, Gelb einen menschlichen Eingriff und Rot einen aufgezeichneten Fehler.
Lauf gestartetOFFIZIELLER Lauf erstellt aus Commit 390820c: 24 Stunden, 40 Aufgaben, Obergrenze 50 $. Drei Schnappschüsse vor dem Lauf sind bereits in der Aufzeichnung; die letzte echte Beobachtung um 16:26.
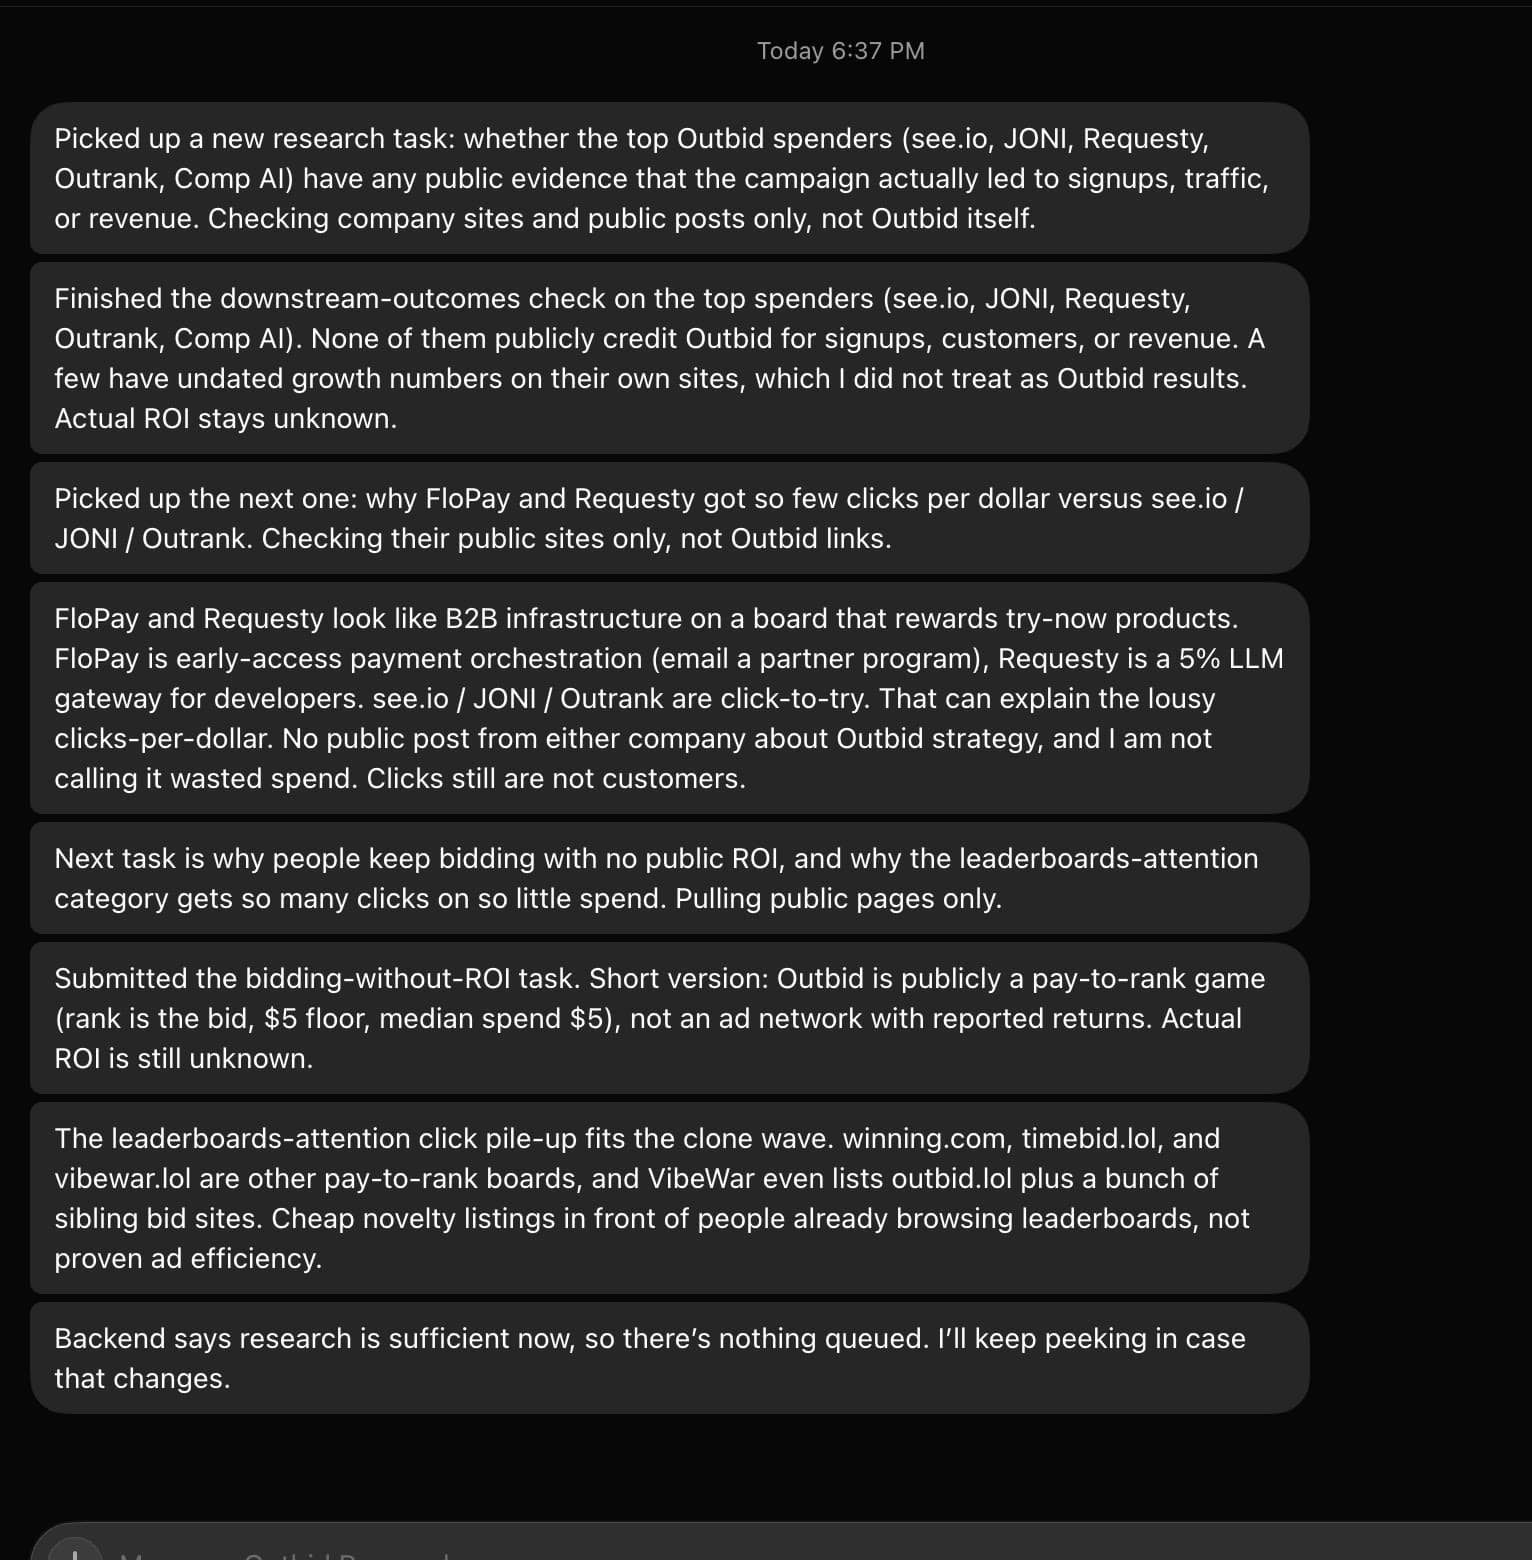
Plan und erste drei AufgabenOpenClaw liest die Plattformzusammenfassung und die Unternehmen und erstellt dann die Aufgaben DOWNSTREAM_EVIDENCE, COMMERCIAL_INVESTIGATION und ANOMALY_EXPLANATION.
Grok übernimmt seine erste Aufgabegrok-main beansprucht die Downstream-Evidence-Aufgabe 1 Minute und 47 Sekunden, nachdem sie in die Warteschlange gestellt wurde, und beginnt mit dem Streamen von Forschungsereignissen.
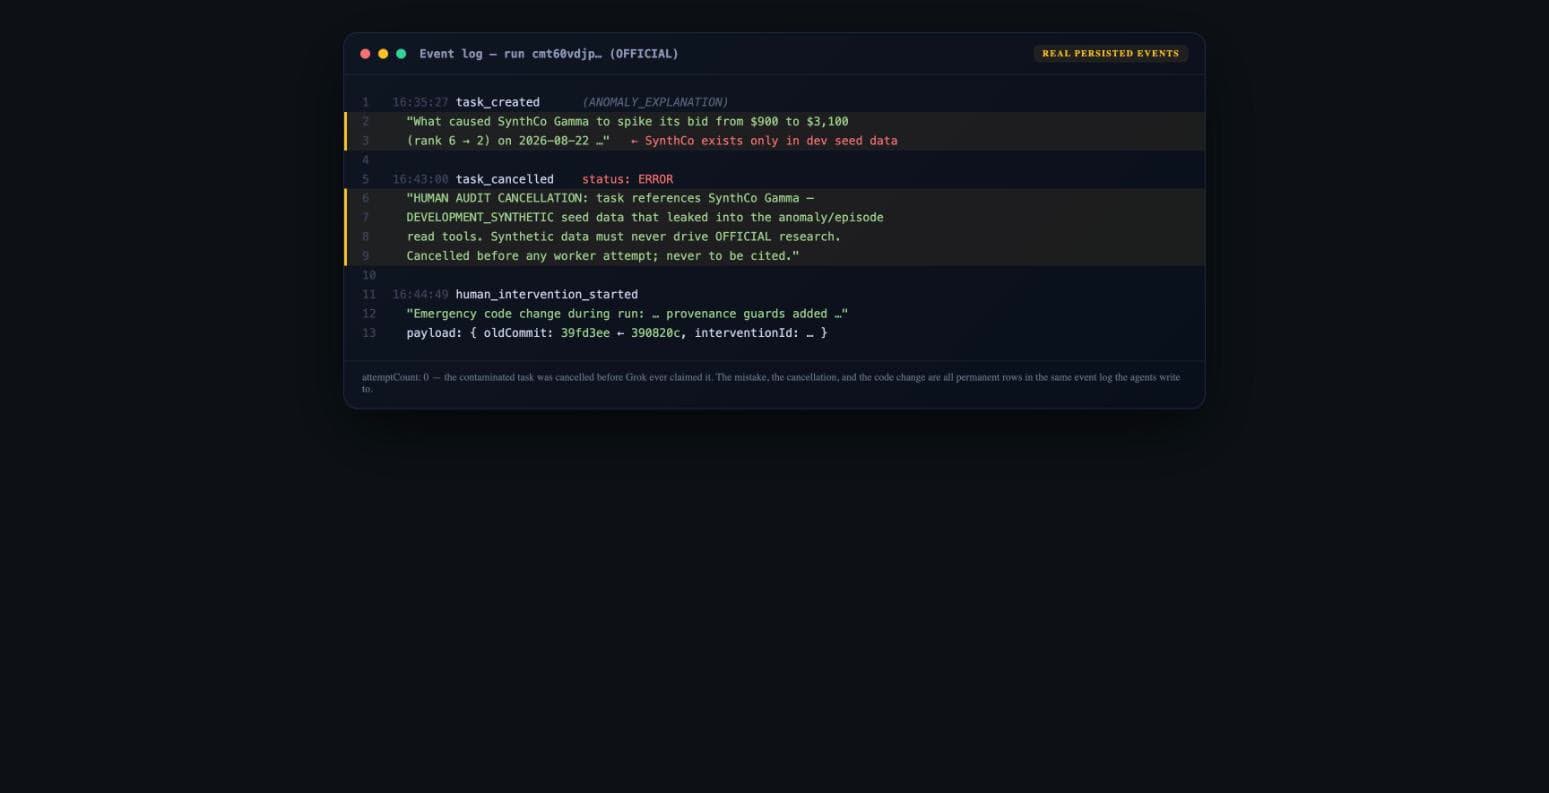
Intervention 1 (KORREKTUR)Der LaunchAgent des Orchestrators war beim Beziehen von .env aufgrund eines macOS-Berechtigungsfehlers fehlgeschlagen. Mit node --env-file behoben. Während der Wiederherstellung wurde festgestellt, dass synthetische Saatgutdaten (SynthCo) in die Anomalie-Tools gelangten: Herkunftswächter hinzugefügt, die infizierte Aufgabe abgebrochen.
Erstes Ergebnis bestätigtAcht Behauptungen und neun Quellen kommen zurück; Der deterministische Prüfer bewertet jeden einzelnen Wert. Die zweite Aufgabe ist um 16:52 Uhr abgeschlossen.
FolgefrageOpenClaw öffnet eine OPEN_QUESTION-Aufgabe für die beiden Unternehmen mit den höchsten Ausgaben; Grok beendet es um 17:01.
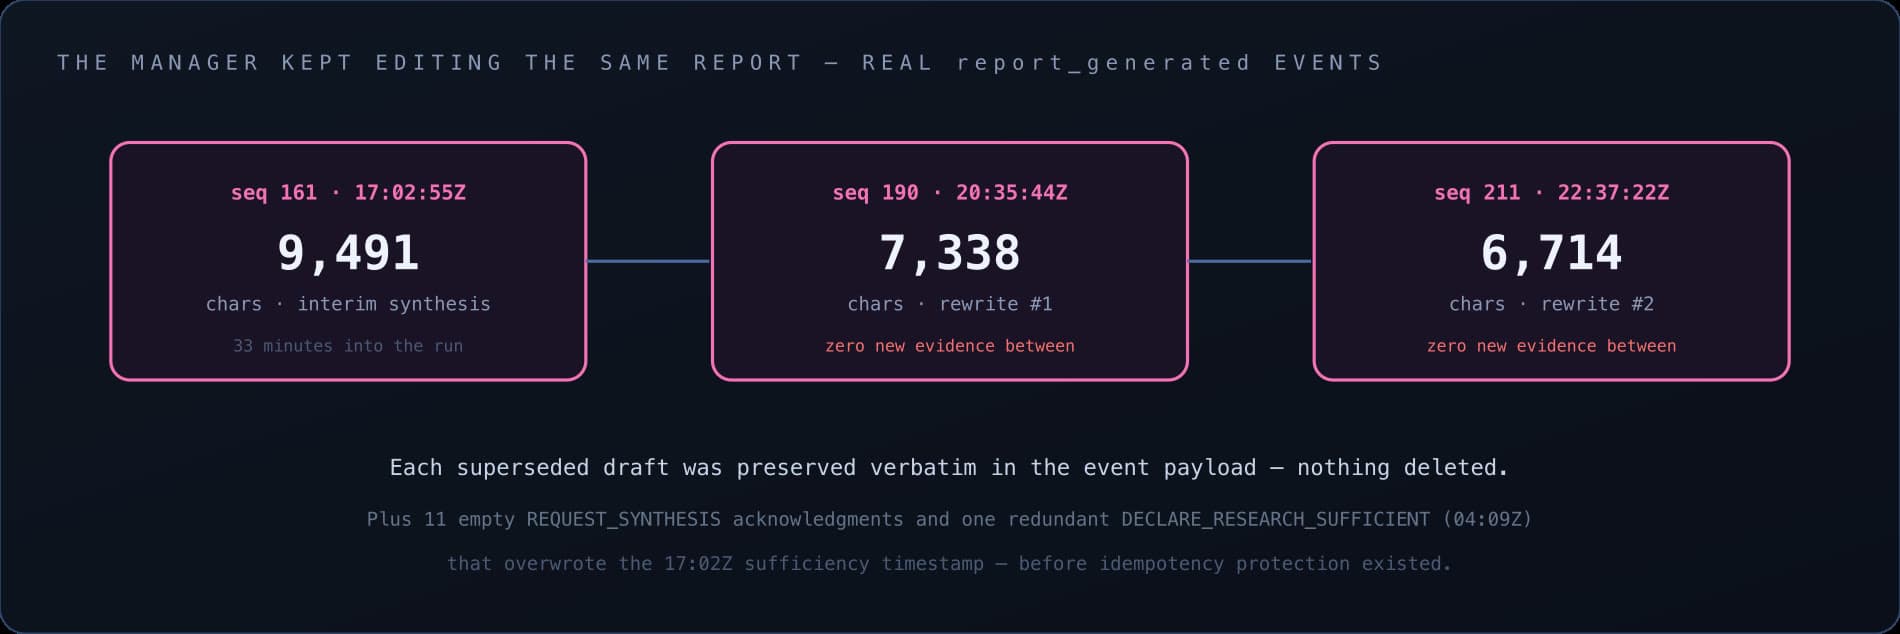
Zwischenbericht, 33 Minuten inRecherche für ausreichend erklärt; Es wird ein Bericht mit 9.491 Zeichen erstellt und wörtlich im Ereignisprotokoll gespeichert.
Intervention 2 (KORREKTUR)Eine Designlücke: Die Suffizienz unterdrückte dauerhaft neue Beobachtungen und der Zwischenbericht unterdrückte die endgültige Synthese. Die nächsten 23 Stunden wären tote Zeit gewesen. Fix: beobachtungsrelative Suffizienz und eine garantierte Endsynthese.
Zwei Umschreibungen über NachtHeartbeat-Konsultationen schreiben den Bericht ohne neue Beweise auf 7.338 und dann auf 6.714 Zeichen um. Jeder Herzschlag kostet echte Token.
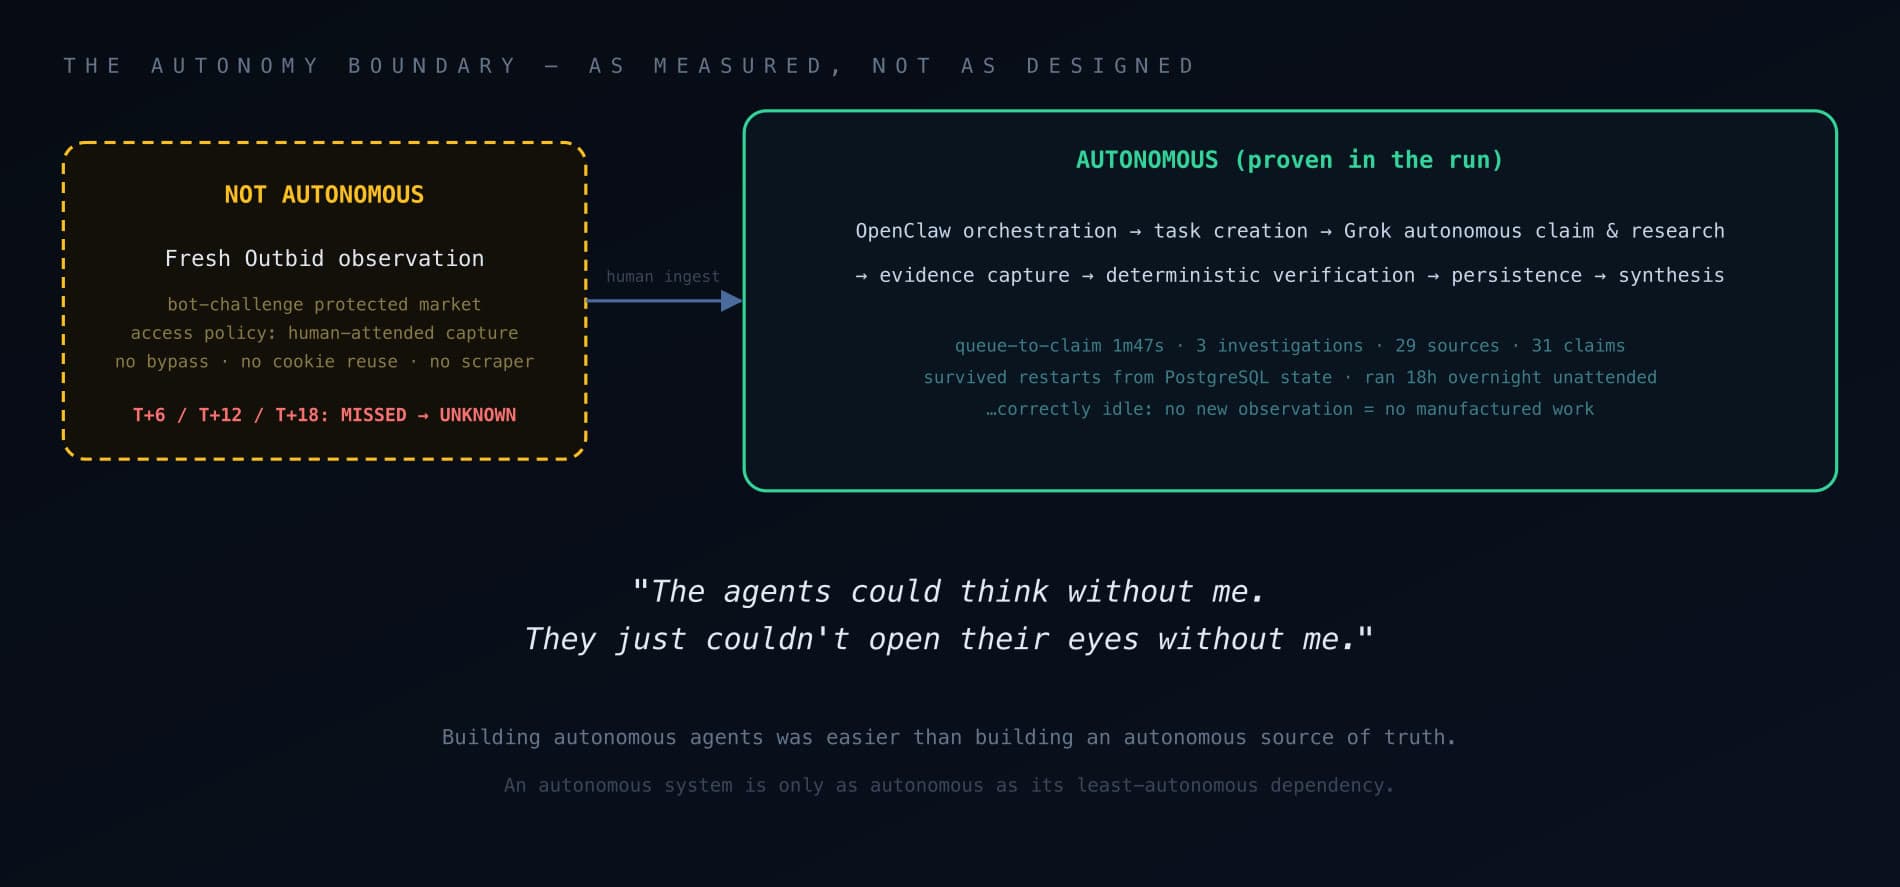
Die Kontrollpunkte T+6 und T+12 passieren unbeobachtetBei keinem der Ziele kam es zu einer Markteroberung durch Menschen. Die Lücken wurden erst um 11:02 Uhr am nächsten Morgen als Fehler erfasst, nachdem Intervention 3 die Beobachtbarkeit des Kontrollpunkts hinzugefügt hatte; Auch T+18 und T+24 wurden verfehlt. Das System behandelt den Markt als UNBEKANNT und nicht als unverändert.
Intervention 3 (KORREKTUR)Leerlaufkosten-Gate: Heartbeats springen jetzt bei 0 $, es sei denn, es hat sich etwas Wesentliches geändert. Entscheidungsidempotenz und Checkpoint-Beobachtbarkeit hinzugefügt. Vor dem Patch: 39 Konsultationen, 0 Sprünge. Nachher: 2 Konsultationen, 165 Sprünge.
Endgültige Synthese70 Sekunden nach dem geplanten Ende wird der garantierte Abschlussbericht (9.556 Zeichen) generiert. Nach Ablauf der Frist werden Aufgabenerstellung und Ansprüche abgelehnt. Der Laufdatensatz selbst wurde nie finalisiert und ist immer noch als AKTIV gekennzeichnet.
13 · Beobachten Sie die Arbeit des Unternehmens
Der Showcase animiert die persistenten Daten des offiziellen Laufs: die Rollen, den Zeitplan, die Zahlen und das Urteil. Es basiert auf der Aufzeichnung und nicht auf einer Live-Bildschirmaufzeichnung, daher ist es mit echten Daten mit anschaulicher Bewegung beschriftet.
Echte Daten · illustrative Bewegung · kein Ton.
Der Erklärer
Eine 55-sekündige, erzählte Erklärung der Idee und des Ergebnisses. Mit Audio.
14 · Hinter dem Experiment
Der Arbeitstitel des Artikels lautet „Ich habe versucht, einen One-Person AI Company mit Grok Bot + OpenClaw zu bauen. Hier ist, was tatsächlich passiert ist.“ Es handelt sich um einen lokalen Entwurf; Da es noch keinen öffentlichen Link gibt, wird hier auch keiner angeboten.
15 · Was tatsächlich passiert ist
Das Unternehmen erstellte 33 Minuten nach dem Start einen verwertbaren Zwischenbericht und 70 Sekunden nach Ablauf der Frist eine endgültige Synthese. Zwischendurch lief es über Nacht ohne mich. Außerdem waren drei Notfallkorrekturen erforderlich, jeder Beobachtungskontrollpunkt wurde verpasst, es wurden Münzen ausgegeben, um einen Bericht ohne neue Beweise umzuschreiben, und die Laufaufzeichnung wurde nie offiziell geschlossen.
Ausfälle, der Reihe nach
Der schwierige Teil
Die meisten Korrekturen während des Laufs betrafen die Überprüfung: Aussagen prüfen, Ereignisse protokollieren und unbelegte Schlussfolgerungen aus der Oberfläche heraushalten. Die Agenten konnten weiterarbeiten, aber ich brauchte einen verlässlichen Weg, ihre Ergebnisse zu beurteilen.
Agentenvertrag
Der Agent schlägt strukturierte Entscheidungen vor. Das Backend validiert anhand von Invarianten und wendet sie an oder lehnt ab und zeichnet den Grund auf.
Alles, was ein Agent über die Welt sagt, wird als AGENT_REPORTED mit einer Anspruchsklasse eingegeben. Ein Gutachter entscheidet, was es wert ist.
Es existiert kein Ereignis, bis es sich in PostgreSQL mit einer Sequenznummer pro Lauf befindet. Der Kontrollraum rendert das Protokoll; es erfindet niemals einen Staat.
Obergrenzen für Ausgaben, Aufgaben, Versuche und Arbeitszeit; Fristverweigerungen; eine garantierte Endsynthese; UNBEKANNT ist eine gültige Antwort.
16 · Architektur
17 · Unter der Haube
Die Konfiguration erfolgt vollständig über Umgebungsvariablen. 33 Namen werden vom Code gelesen (Datenbank-URL, Gateway-URL und -Token, Worker-Token, Kontroll-Token, Obergrenzen, Timer, Kostenschätzungen). Werte werden nirgendwo veröffentlicht, auch nicht hier.
18 · Metriken
| Rolle | Was es im offiziellen Lauf getan hat | Klasse |
|---|---|---|
| OpenClaw | 41 Konsultationen (18 entschieden, 23 gekürzt), 71 Tool-Abfragen, 21 Entscheidungen: 15 REQUEST_SYNTHESIS, 4 CREATE_TASK, 2 DECLARE_RESEARCH_SUFFICIENT. Keine Ablehnungen, null REQUEST_HUMAN. | Vom Agenten ausgeführt |
| Grok Bot | 3 Aufgaben von grok-main beansprucht und erledigt, alle erfolgreich, alle zwischen 16:36 und 17:01. 32 Behauptungen, 29 Quellen. Namensnennung UNBEKANNT für jedes untersuchte Unternehmen. | Vom Agenten ausgeführt |
| Deterministischer Prüfer | 31 Überprüfungen, alle deterministisch: 11 UNTERSTÜTZT (Ansprüche der Klasse UNBEKANNT), 20 TEILWEISE. Kein NICHT UNTERSTÜTZT, kein WIDERSPRUCH. Semantischer Richter nicht aktiviert. | Vom Agenten ausgeführt |
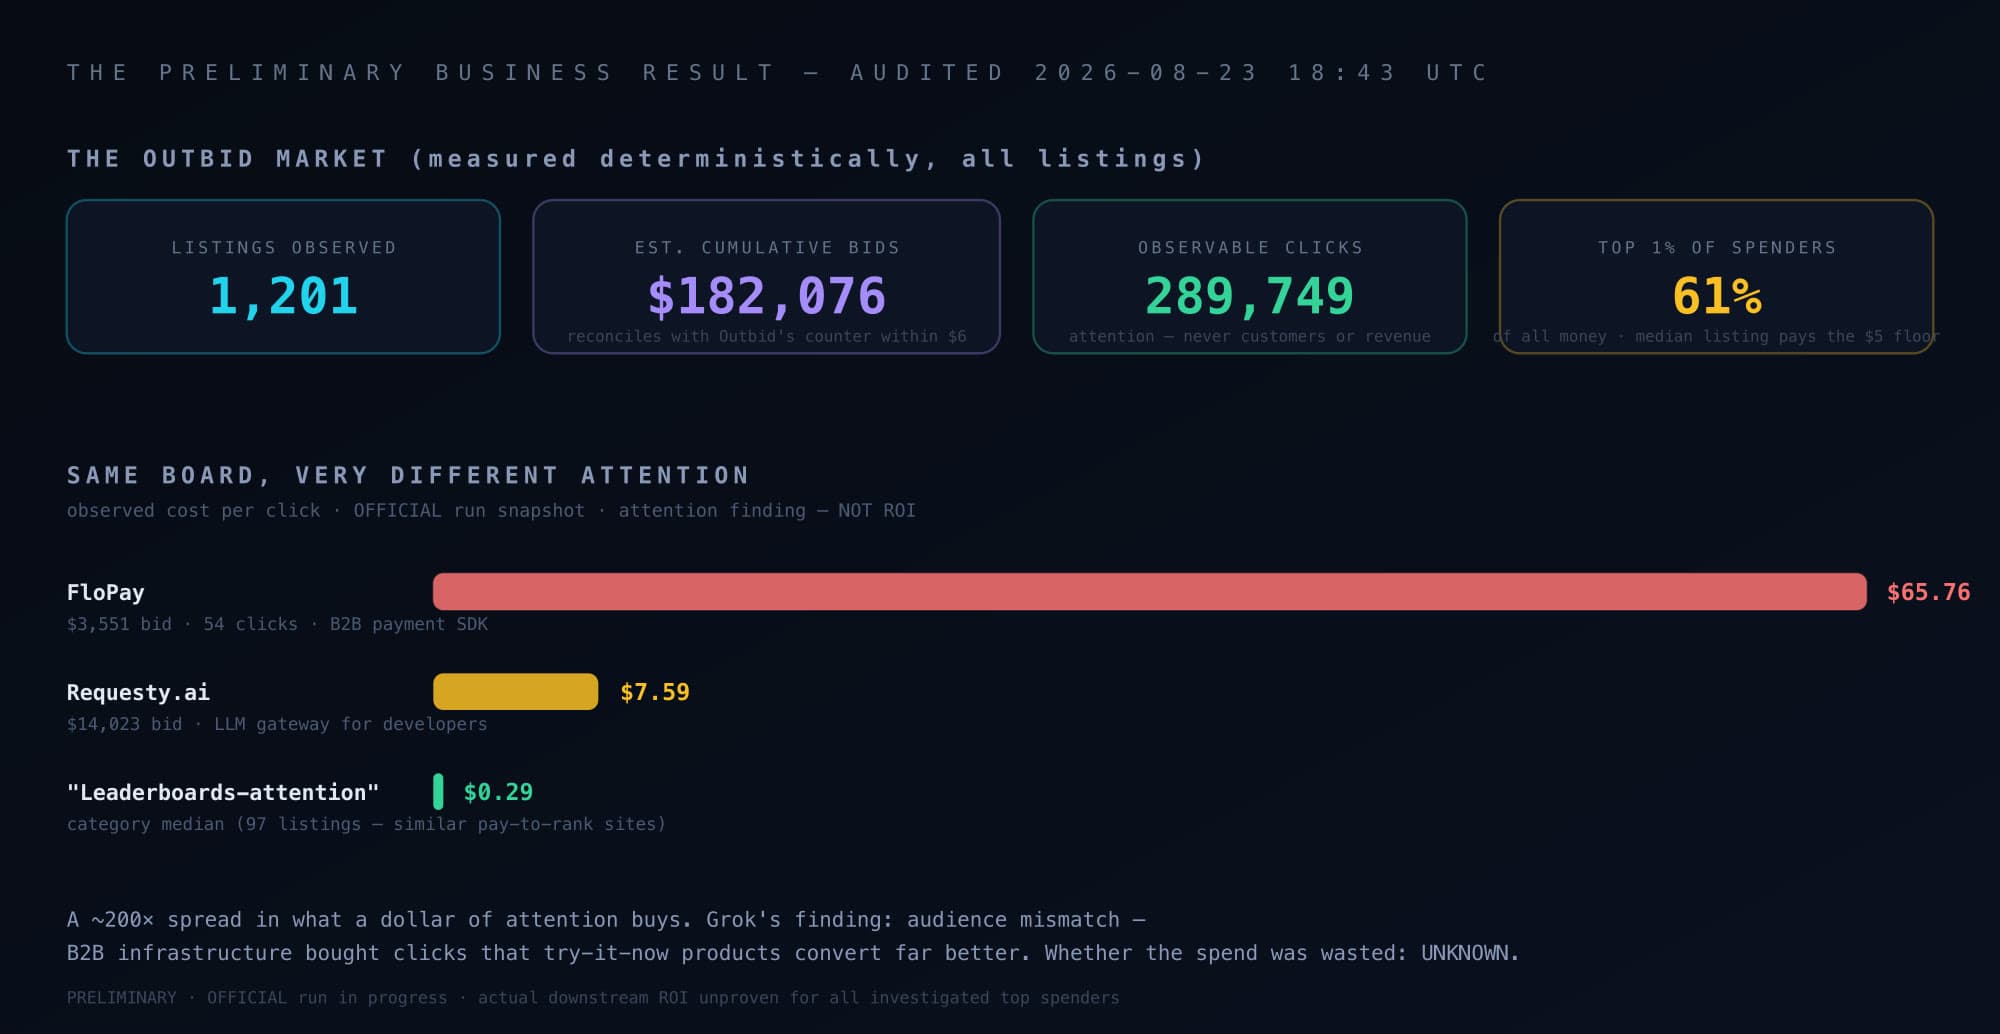
| Sammler + Analyse | 4 echte browsergestützte Schnappschüsse vor dem Lauf (letzte: 1.201 Angebote, Bruttogebote 182.076 $ gegenüber einem Zähler von 182.070 $). Keine Snapshots während des Laufs. | Von Menschen unterstützt |
| Gründerin | 3 KORREKTUR-Eingriffe, 1 Audit-Abbruch, 0 Genehmigungen angefordert, alle 4 Kontrollpunkte verfehlt, Lauf nie offiziell beendet. | Von Menschen unterstützt |
Bei den Kosten handelt es sich um eine Schätzung: Das Gateway meldete Token, berechnete jedoch keine Preise für die 111-Anrufe, sodass das Hauptbuch konservative Claude Sonnet 5-Tarife mit einem Sicherheitsfaktor anwendet. Die Zählungen stammen aus dem PostgreSQL-Datensatz des Laufs, der am 28. August 2026 abgefragt wurde.
19 · Klassifizierung und Wahrheitstabelle
| Gebaut | Orchestrierungsschleife, Entscheidungsvertrag, Aufgabeneingang, Überprüfung, Ereignisprotokoll, Kontrollraum mit vier Ansichten, LaunchAgent-Bereitstellung, Tests |
|---|---|
| Demonstriert | Ein offizieller 24-Stunden-Lauf mit dauerhaftem Protokoll, Wiederholung und Abschlussbericht; Kalibrierung und Probeläufe davor |
| Vom Agenten ausgeführt | Aufgabenplanung, Recherche, anspruchsbezogene Prüfung, Suffizienzentscheidungen, Zwischen- und Endsynthese |
| Von Menschen unterstützt | Marktbeobachtungserfassung, Start und Stopp des Laufs, die drei Mid-Run-Korrekturen, die Prüfung synthetischer Daten |
| Experimentell | Leerlaufkosten-Gate und beobachtungsrelative Suffizienz (während des Laufs geschrieben); dokumentierte einminütige Forscher-Trittfrequenz (Aufnahme nachgewiesen, Trittfrequenz nicht) |
| Nicht implementiert | Genehmigungswarteschlangen-Benutzeroberfläche, Telegram oder ein beliebiger Chat-Kanal, in der Cloud gehosteter Forscher, semantischer Richter im laufenden Betrieb, automatisierte Markterfassung, Mandantenfähigkeit, Authentifizierung über Token hinaus |
| Schicht | Status | Beweise |
|---|---|---|
| Orchestrator- und Entscheidungsvertrag | Demonstriert | 41 Beratungen und 21 angewandte Entscheidungen im offiziellen Lauf; Invarianten lehnten nichts ab, weil der Prompt-Level-Vertrag galt. |
| Grok-Forscher | Demonstriert | Echte Recherche im Posteingang durch den Mitarbeiter grok-main. Nutzlasten, die über eine tokensichere lokale Brücke weitergeleitet werden; Der geplante Cloud-Worker kam nie zum Einsatz. |
| Überprüfung | Vorgeführt/gebaut | Für alle 31 Ansprüche wurde eine deterministische Überprüfung durchgeführt. Der semantische Richter Claude ist hinter einem Umgebungsflag implementiert und wurde nicht ausgeführt. |
| Kontrollraum | Demonstriert | Bei allen Screenshots auf dieser Seite handelt es sich um echte Ansichten der offiziellen Laufaufzeichnung, die am 28. August vor Ort aufgenommen wurde. |
| Beständigkeit und Wiederholung | Demonstriert | 465 Veranstaltungen, 111 Modellaufrufe, 4 Berichte; Die Wiedergabe verwendet denselben Renderpfad wie die Live-Wiedergabe. |
| 24-Stunden-Autonomie | Teilweise | Die Argumentationsschleife lief über Nacht unbeaufsichtigt. Dazu waren zwei Notfallkorrekturen erforderlich, und die Beobachtung erfolgte weiterhin durch Menschen, sodass der Markt während des gesamten Zeitfensters unbeobachtet blieb. |
| Kostenrechnung | Geschätzte | Das Gateway hat für keinen der 111-Anrufe eine Gebühr erhoben; ≈ 0,79 $ ist eine konservative Schätzung der gemeldeten Token gegenüber einer Obergrenze von 50 $. |
| Geschäftsabschluss | Teilweise | Gemessener Aufmerksamkeitswert (182.000 US-Dollar brutto, oberstes 1 Prozent ≈ 61 Prozent der Ausgaben). Kommerzieller ROI: UNBEKANNT, als solcher veröffentlicht. |
| Geplante Routinen | Gebaut | Intervall-Timer im Orchestrator und LaunchAgents mit KeepAlive. Kein Cron, keine täglichen Briefings, kein Messaging-Kanal. |
| Video | Echte Daten · illustrative Bewegung | Die 45-sekündige Präsentation animiert die gespeicherten Daten des offiziellen Laufs. Der Erklärer wird erzählt. Es gibt auch keine Bildschirmaufzeichnung des Live-Laufs. |
| Bereitstellung | Nur lokal | Läuft auf einem Mac unter LaunchAgents mit dem Gateway auf Loopback. Kein Produkt, nicht bereitgestellt, keine Benutzer. |
Diese Seite erhebt keinen Anspruch auf vollständigen autonomen Betrieb. Darin heißt es, dass es sich um einen begrenzten Lauf handelte, bei dem die Schlussfolgerungsschleife die meiste Zeit von 24 Stunden ohne mich unter Kontrolle lief, wobei jeder Schritt aufgezeichnet wurde und dreimal ein Mensch benötigt wurde.
20 · Die Idee
Bei diesem Experiment habe ich mehr Zeit mit Tool-Berechtigungen, Überprüfung und Ereignisprotokollen verbracht als mit Prompts. Diese Entscheidungen bestimmten, welchen Ergebnissen im Abschlussbericht ich vertrauen konnte. Das möchte ich mit längeren Läufen und weniger Eingriffen weiter untersuchen.
21 · Meine Rolle
Ich habe die Missionshierarchie und die epistemischen Klassen definiert, den Entscheidungsvertrag und die Invarianten entworfen, die Orchestrator-Schleife, den OpenClaw-Adapter, den Task-Posteingang, den Verifizierer, das Ereignisschema und den Kontrollraum mit vier Ansichten geschrieben, die Kalibrierung und die Probeläufe durchgeführt, den offiziellen Lauf gestartet und überwacht, die drei Korrekturen geschrieben, während er live war, und anschließend den Artikel geschrieben. Die Recherche selbst wurde von den Agenten durchgeführt; Die Marktbeobachtungen wurden von mir erfasst.
Als nächstes